
AI文章
读懂模型与应用的新进展,找到值得尝试的 AI 实践。
7,595篇文章,持续更新
文章列表
LangBot – 多模态即时聊天机器人构建与管理的开源平台
LangBot 是开源的即时聊天机器人平台,支持多平台(如 QQ、微信、飞书、Discord 等)和多种大语言模型(如 ChatGPT、DeepSeek、Gemini 等)。LangBot具备多模态交互能力,支持文本、语音、图片等多种输入输出形式,能进行多轮对话和工具调用。
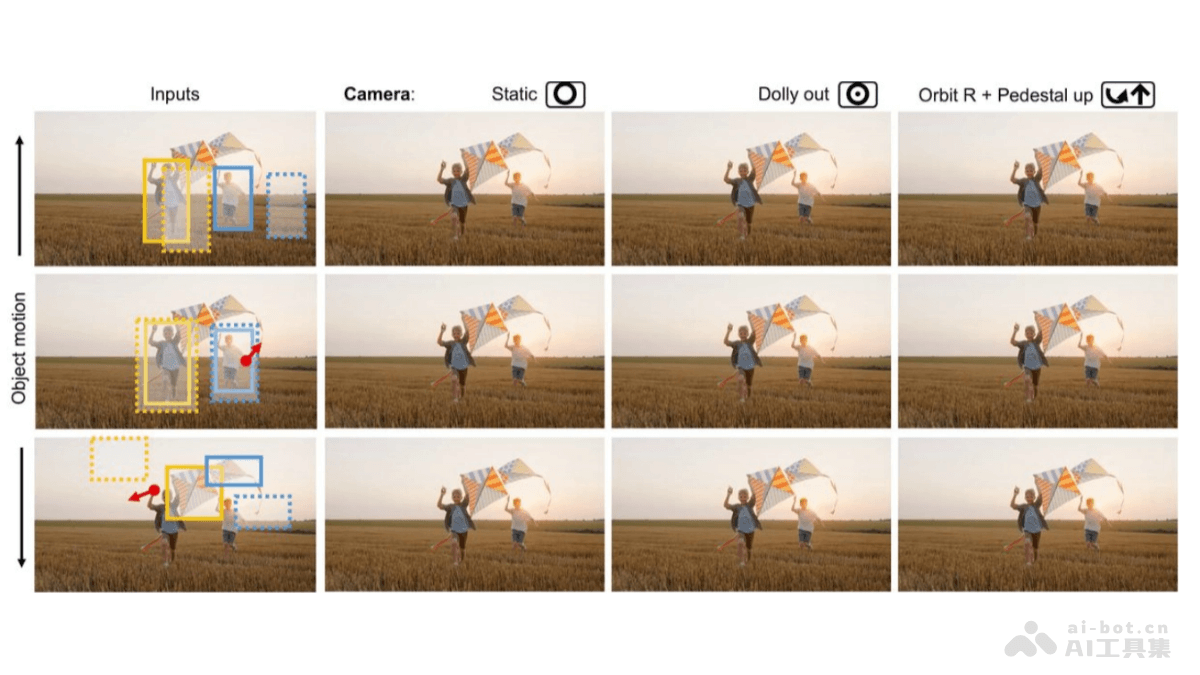
MotionCanvas – 港中文和 Adobe 等机构推出的可控图像到视频生成方法
MotionCanvas是香港中文大学、Adobe 研究院和莫纳什大学推出的图像到视频(I2V)生成方法,能将静态图像转化为具有丰富动态效果的视频。MotionCanvas基于引入运动设计模块,让用户能直观地在图像上规划相机运动和物体运动,实现复杂的镜头设计。
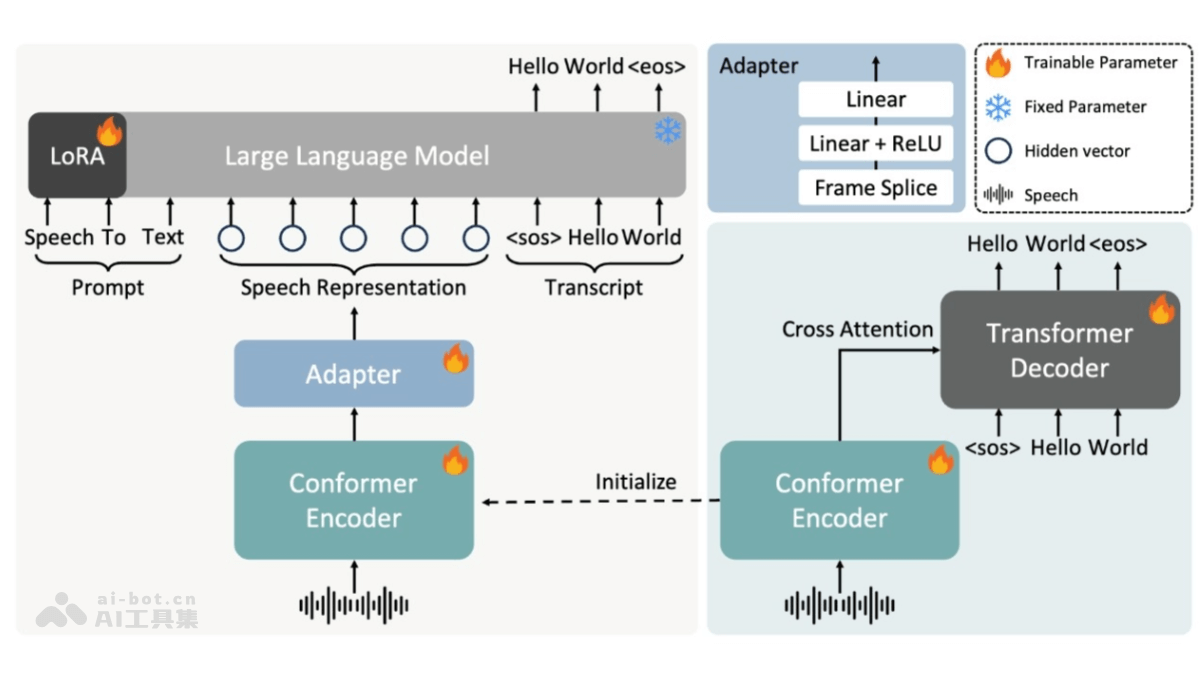
FireRedASR – 小红书开源的自动语音识别模型
FireRedASR 是小红书开源的工业级自动语音识别(ASR)模型家族,支持普通话、中文方言和英语,在普通话 ASR 基准测试中达到了新的最佳水平(SOTA),在歌词识别方面表现出色。
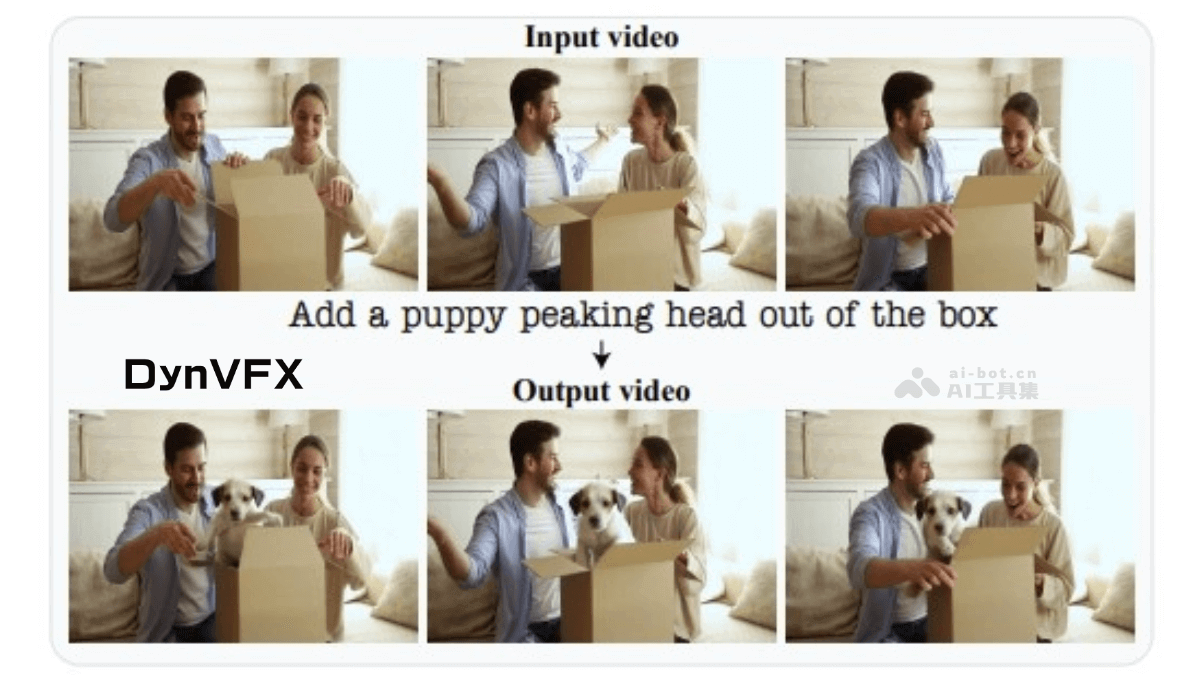
DynVFX – AI视频增强技术,将新动态内容与原始视频无缝融合
DynVFX是创新的视频增强技术,能根据简单的文本指令将动态内容无缝集成到真实视频中。通过结合预训练的文本到视频扩散模型和视觉语言模型(VLM),实现了在不依赖复杂用户输入的情况下,自然地将新动态元素与原始视频场景融合。
EpicTopia AI – AI驱动的个人成长与人生规划智能应用
EpicTopia AI 是专注于个人成长与人生规划的智能应用。通过AI技术为用户提供个性化的人生旅程管理方案,帮助用户设定目标、记录进展、反思成长,庆祝成就。用户可以在时间轴上记录生活中的重要时刻和任务完成情况,AI会根据输入信息生成针对性的行动建议和总结,助力用户实现目标。
Omakase.ai – AI购物助手,输入目标网址自动分析筛选符合需求的商品
Omakase.ai 是 AI 电商客服助手平台,用户只需提供电商或品牌官网网址,能快速创建个性化购物 AI 代理。平台通过智能筛选与推荐商品,结合语音、聊天等多种交互方式,为消费者提供高效、个性化的购物体验。
Scam AI – AI内容检测平台,快速验证视频、音频和文本内容真实性
Scam AI 是基于人工智能的防诈骗平台,帮助用户快速验证视频、音频和文本内容的真实性,识别潜在的诈骗行为。通过自然语言处理(NLP)、视觉和音频认证技术,结合多层分析,以高精度检测合成媒体内容。
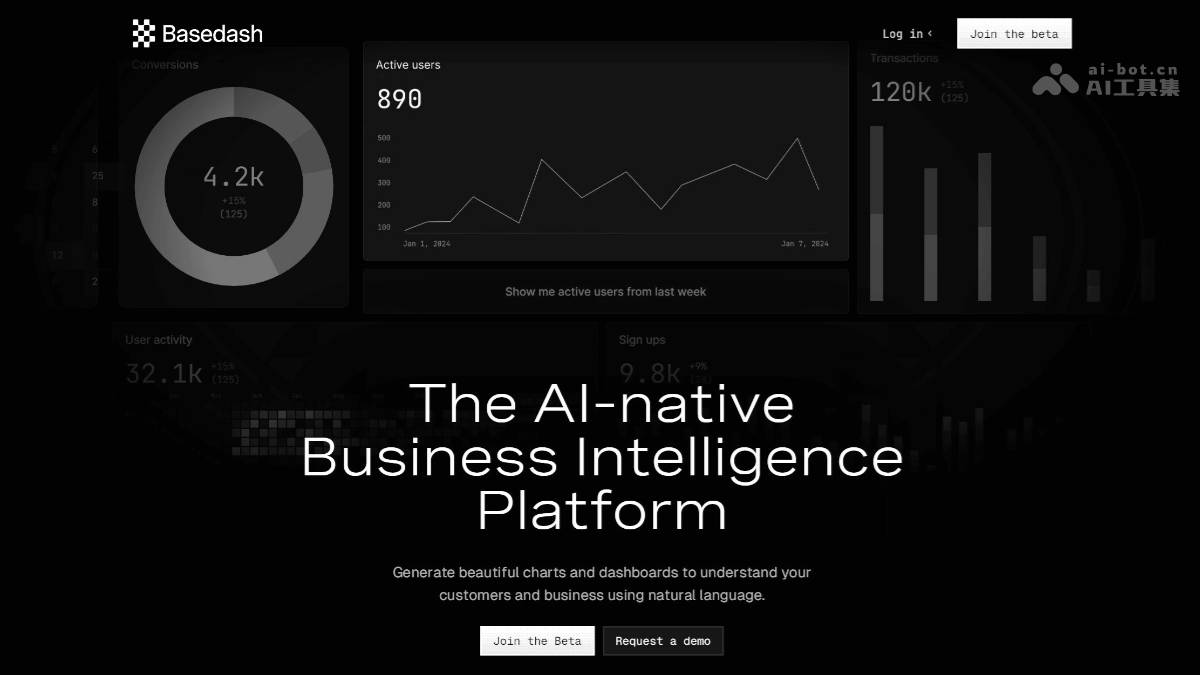
Basedash – AI数据库管理工具,零代码编写自动完成数据查看、编辑、分析
Basedash 是无代码数据库管理工具,通过 AI 技术自动生成数据管理界面,无需编写代码可完成数据的查看、编辑和分析。支持多种数据库(如 PostgreSQL、MySQL 等)和第三方 API 的连接,可创建自定义仪表板和图表,帮助团队共享见解和跟踪目标。
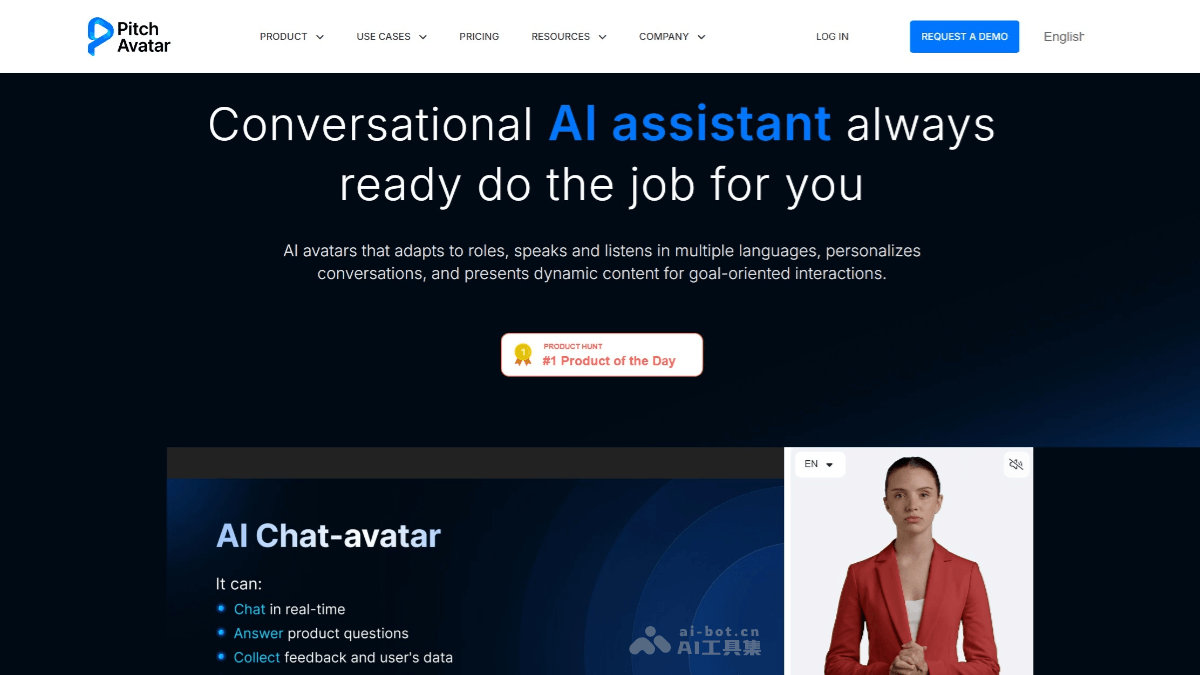
AI Chat-avatar – AI数字人交互助手,根据对话内容提供动态视觉互动
AI Chat-avatar 是 AI 驱动的数字人交互助手,通过高度个性化的互动体验提升沟通效率与用户参与度。具备多语言支持,能实时翻译并进行自然对话,打破语言障碍。AI Chat-avatar 可以根据不同的业务场景(如销售、客服、培训等)调整语气和风格,提供动态视觉互动,如实时展示幻灯片、图片和视频,帮助用户更直观地理解信息。
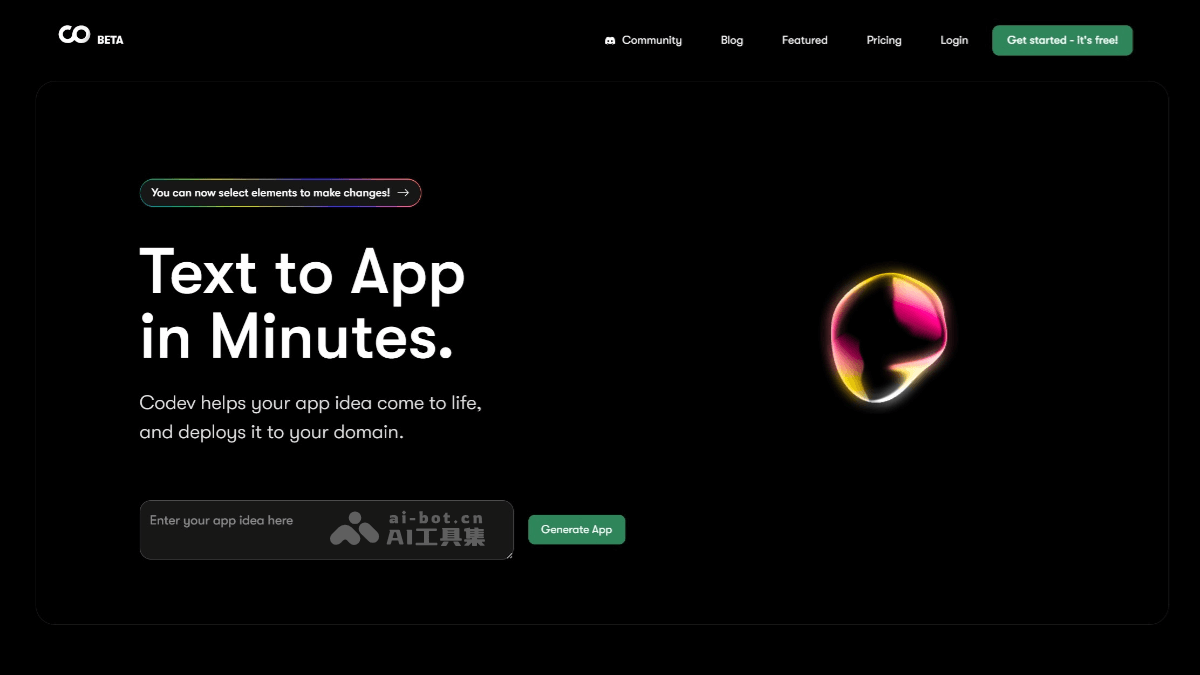
Codev – AI应用开发平台,自然语言描述需求生成全栈代码
Codev是 AI 驱动的全栈应用开发平台,帮助用户快速将想法转化为实际的 Web 应用。用户只需通过自然语言描述需求,平台可自动生成基于 Next.js 和 Supabase 的现代化全栈代码。适合非技术用户快速构建应用,开发者快速搭建基础架构并进行定制开发。
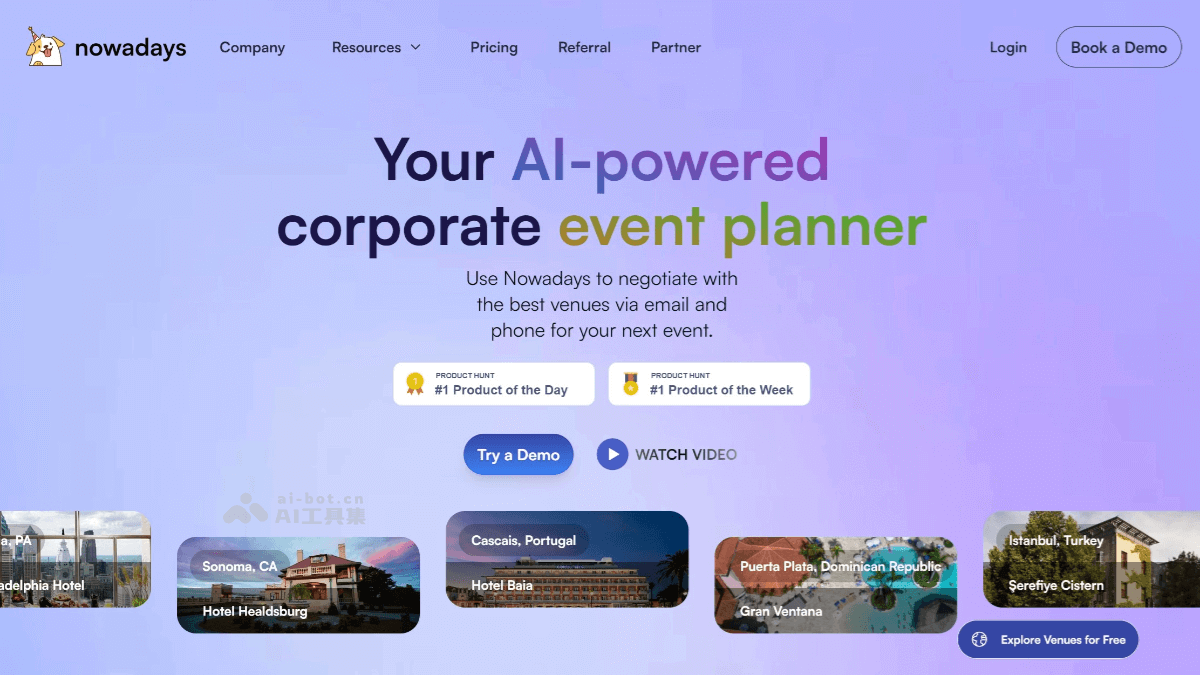
nowadays – AI活动规划平台,自动完成场地搜索、报价收集、合同签署全流程服务
nowadays 是 AI 驱动的企业活动规划平台,基于自主开发的 AI 技术和 40 万全球场地数据库,为预算超过 2 万美元的活动提供全流程自动化策划服务。用户只需输入活动细节,AI 可与场地方进行协商,完成场地搜索、报价收集和合同签署等流程。
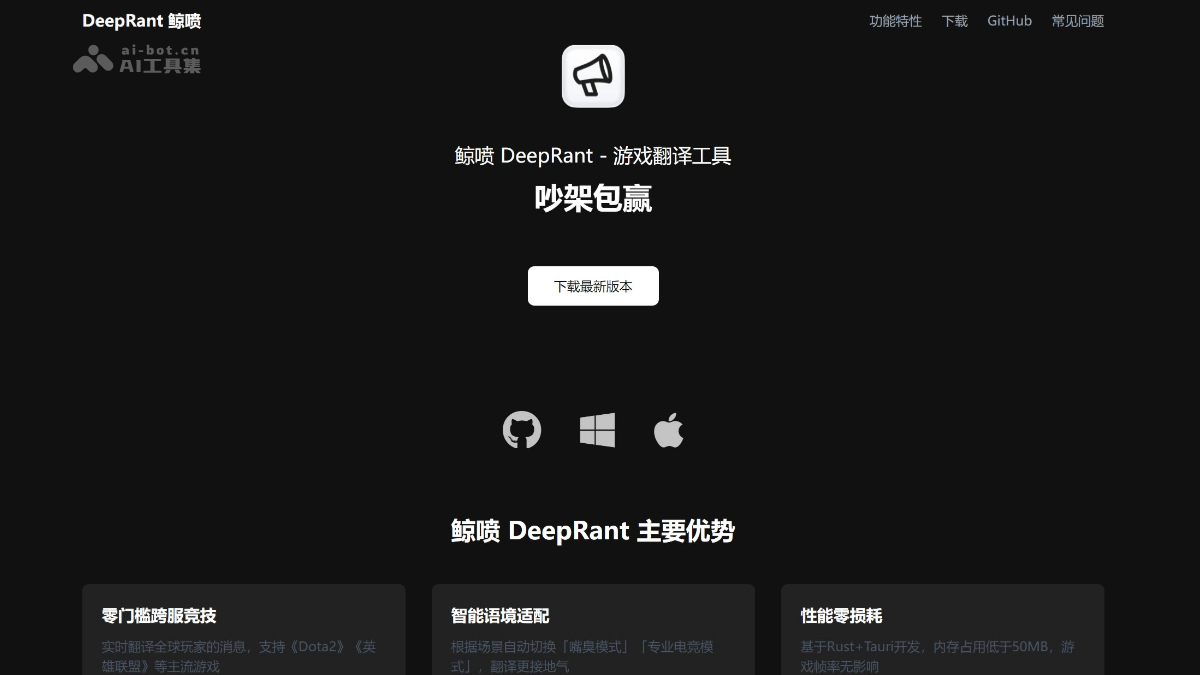
DeepRant 鲸喷 – 专为游戏玩家设计的多语言快捷翻译开源工具
DeepRant(中文名:鲸喷)是专为游戏玩家设计的多语言快捷翻译工具。DeepRant能够帮助玩家在国际服务器中快速进行文字交流,消除语言障碍。玩家在游戏中选中文字后按下快捷键,翻译结果自动复制到剪贴板,方便在游戏中直接使用。
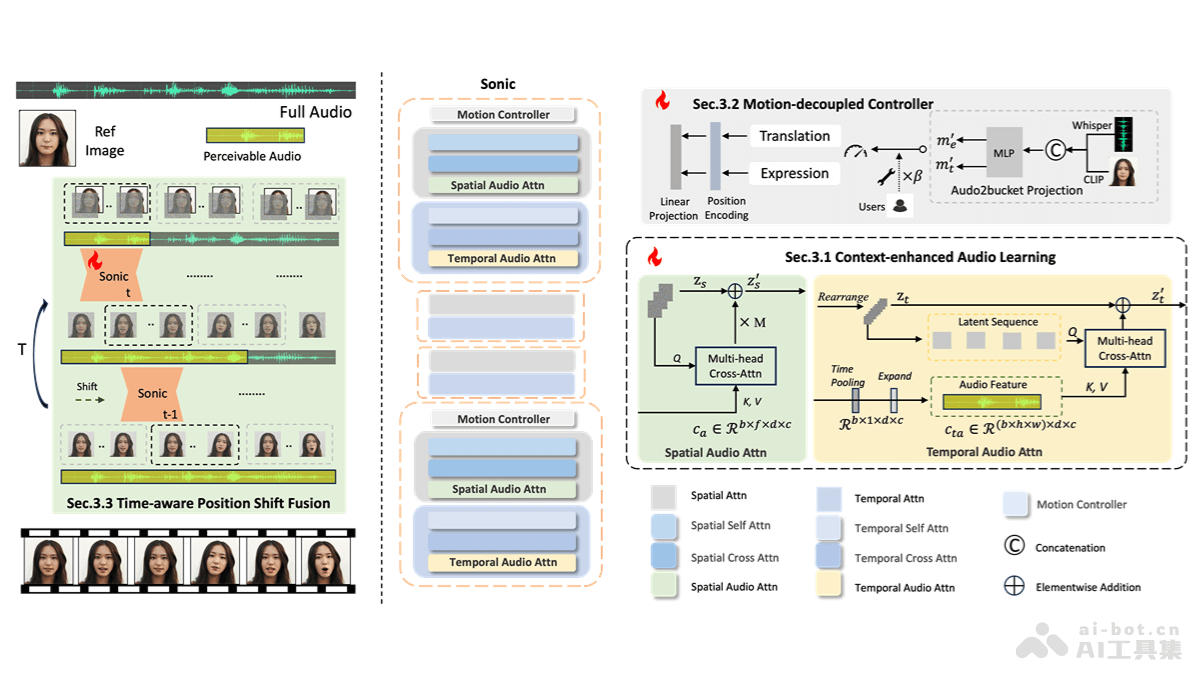
Sonic – 腾讯联合浙大推出的音频驱动肖像动画框架
Sonic是腾讯和浙江大学推出的音频驱动肖像动画框架,基于全局音频感知生成逼真的面部表情和动作。Sonic基于上下文增强音频学习和运动解耦控制器,分别提取音频片段内的长期时间音频知识和独立控制头部与表情运动,增强局部音频感知能力。
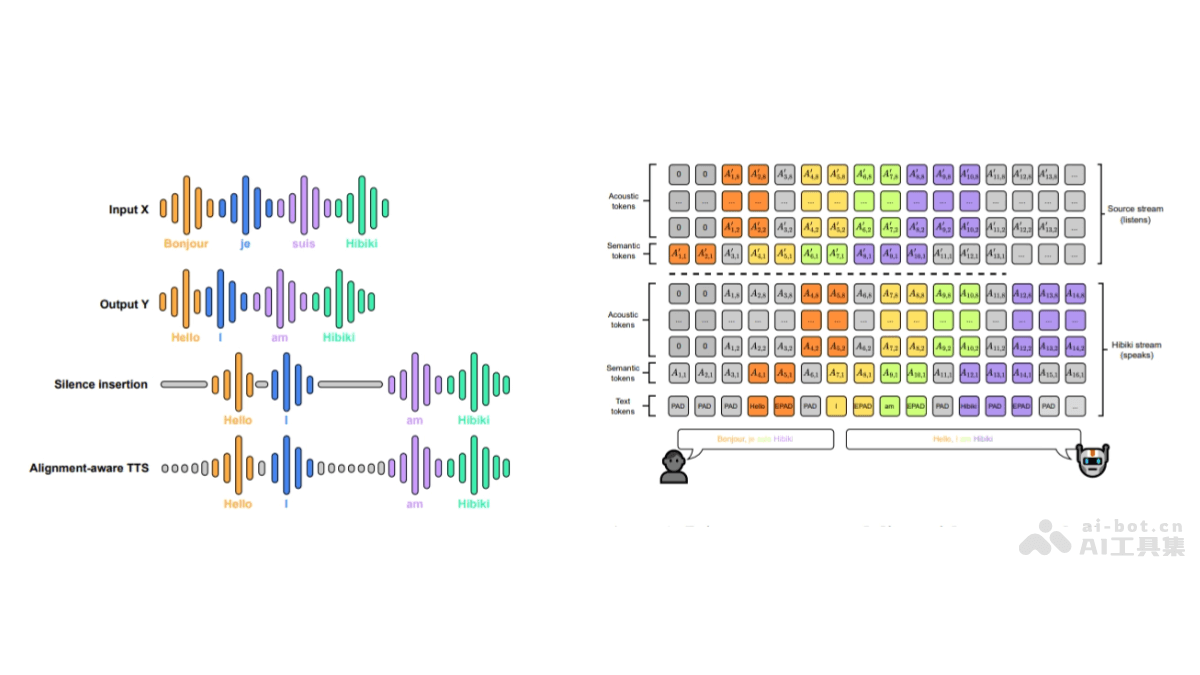
Hibiki – Kyutai Labs 推出的实时语音翻译模型
Hibiki是Kyutai Labs开源的用在同时语音翻译的解码器模型,能实时将一种语言的语音翻译成另一种语言的语音或文本。Hibiki基于多流语言模型架构,同步处理源语音和目标语音,联合生成文本和音频标记,实现语音到语音(S2ST)和语音到文本(S2TT)的翻译功能。
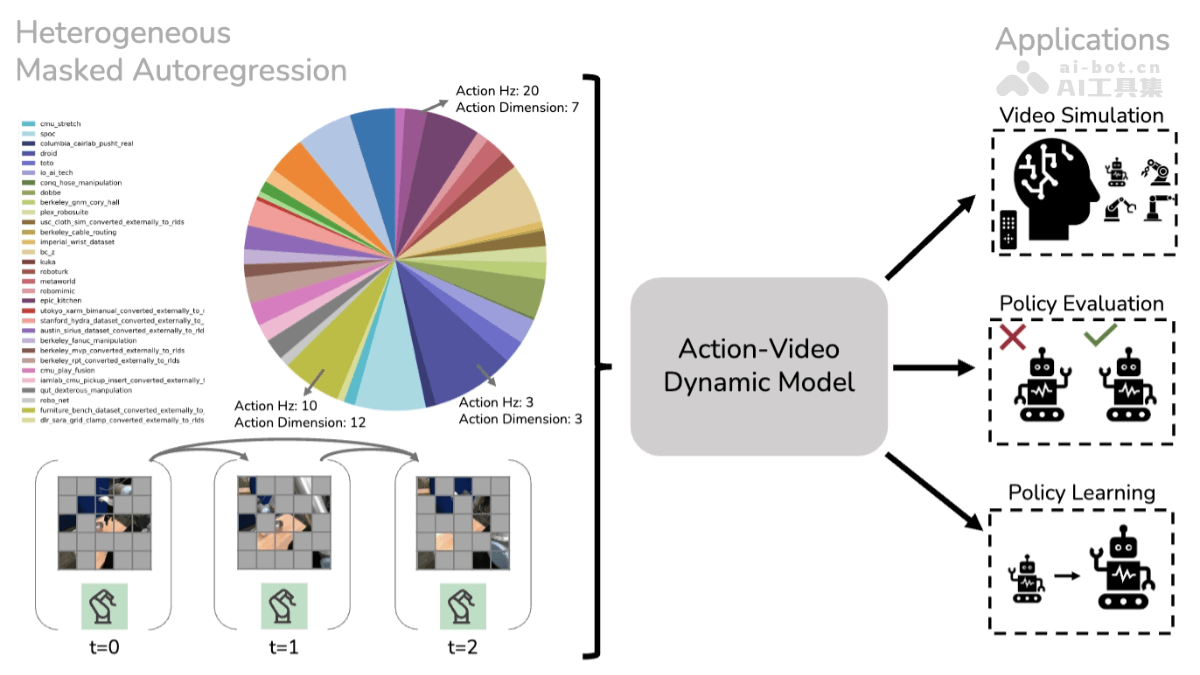
HMA – MIT联合Meta等推出的机器人动作视频动态建模方法
HMA(Heterogeneous Masked Autoregression)是麻省理工学院、Meta和伊利诺伊大学香槟分校开源的,用在建模机器人动作视频动态的方法。HMA基于异构预训练,用不同机器人实体、领域和任务中的观测和动作序列,结合掩码自回归技术生成视频预测。
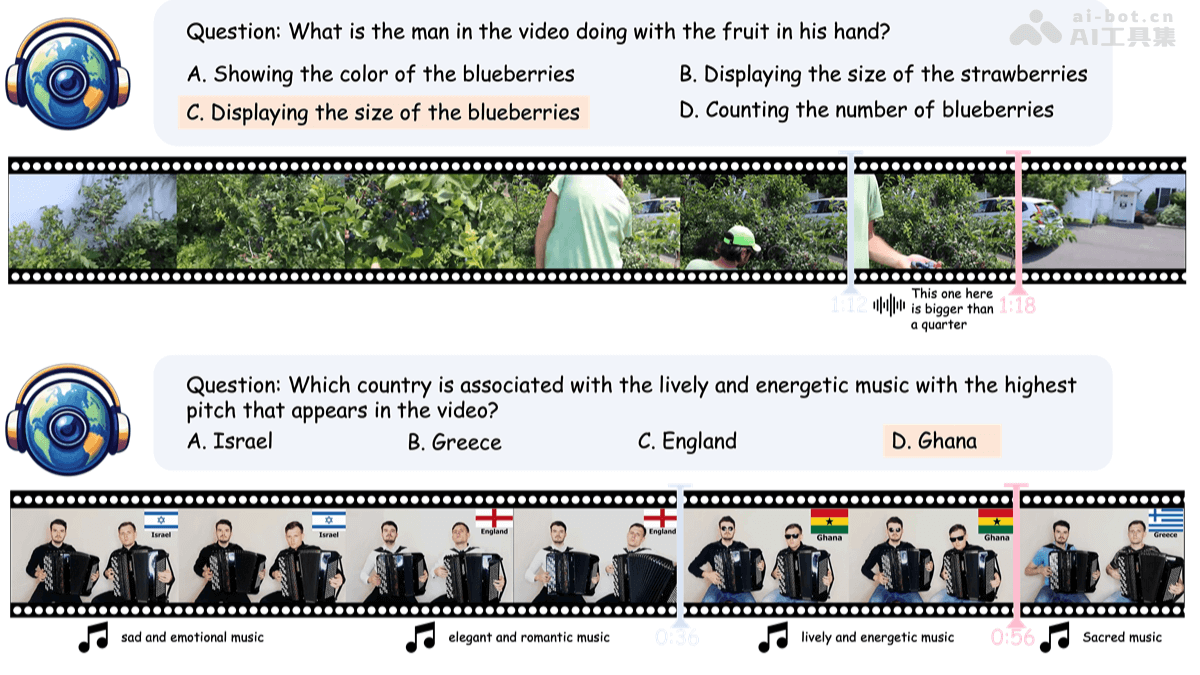
WorldSense – 小红书联合上海交大推出的多模态全面评测新基准
WorldSense是小红书和上海交通大学推出的,用在评估多模态大型语言模型(MLLMs)在现实世界场景中对视觉、听觉和文本输入的综合理解能力的基准测试。WorldSense包含1662个音频-视频同步的多样化视频,覆盖8个主要领域和67个细分子类别,及3172个多项选择问答对,涉及26个不同的认知任务。
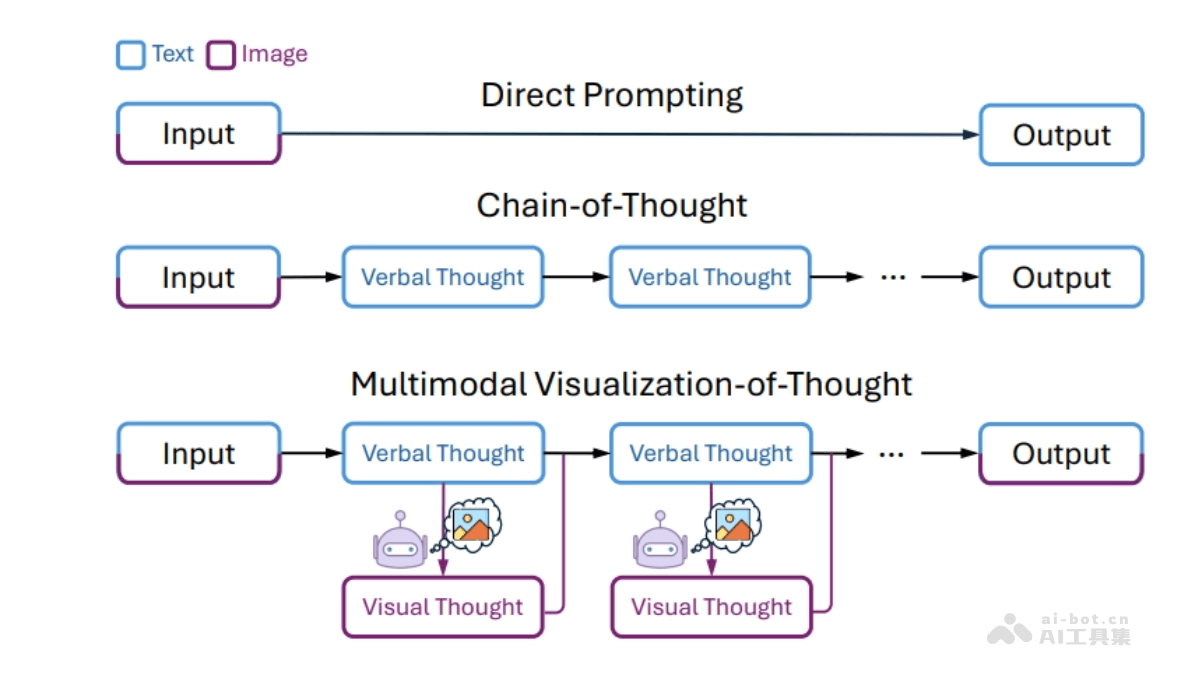
MVoT – 微软联合剑桥和中科院推出的多模态推理可视化框架
MVoT(Multimodal Visualization-of-Thought)是微软研究院、剑桥大学语言技术实验室、中国科学院自动化研究所推出的新型多模态推理范式,基于生成图像可视化推理痕迹增强多模态大语言模型(MLLMs)在复杂空间推理任务中的表现。
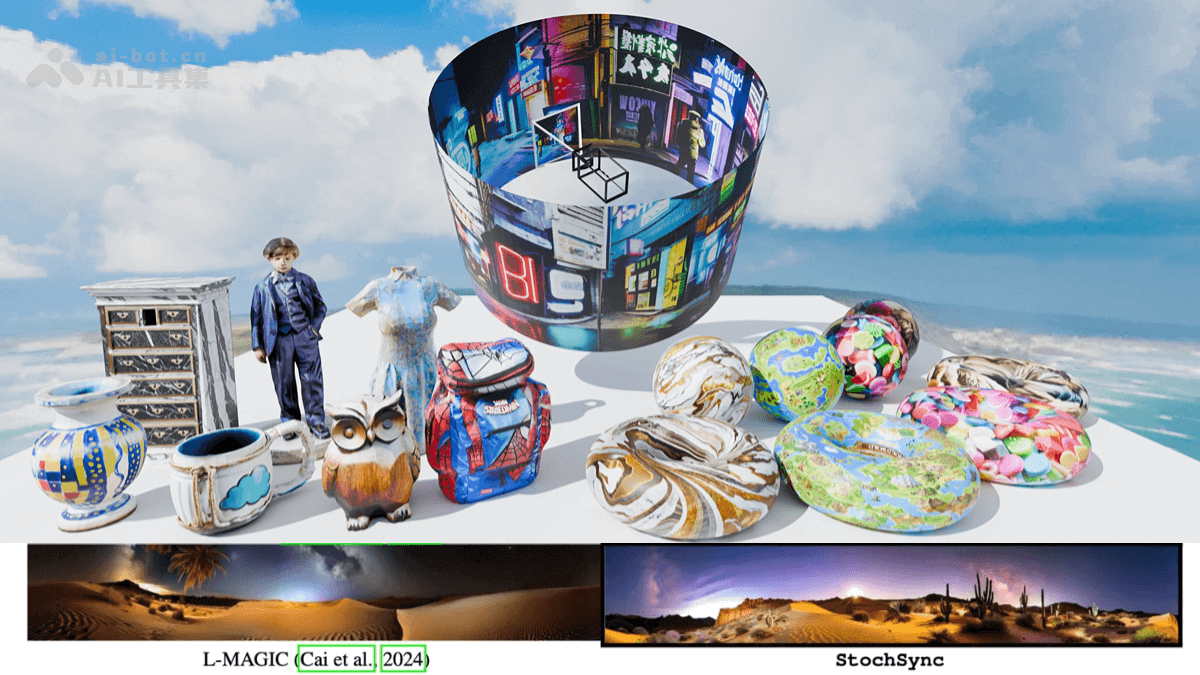
StochSync – AI图像生成技术,为360°全景图和3D网格纹理生成高质量图像
StochSync(Stochastic Diffusion Synchronization)是创新的图像生成技术,专门用于在复杂空间(如360°全景图或3D表面纹理)中生成高质量图像。结合了扩散同步(DS)和分数蒸馏采样(SDS)的优势,通过在扩散模型的逆生成过程中引入最大随机性,兼顾图像细节与连贯性。