
AI文章
读懂模型与应用的新进展,找到值得尝试的 AI 实践。
7,595篇文章,持续更新
文章列表
AnythingLLM – 开源的全栈 AI 客户端,支持本地部署和API集成
AnythingLLM 是开源免费且支持多模态交互的全栈 AI 客户端。AnythingLLM支持文本、图像和音频等多种输入方式,将任何文档或内容转化为上下文,供各种语言模型(LLM)在对话中使用。AnythingLLM支持本地运行和远程部署,提供多用户管理、工作区隔离、丰富的文档格式支持以及强大的 API 集成。
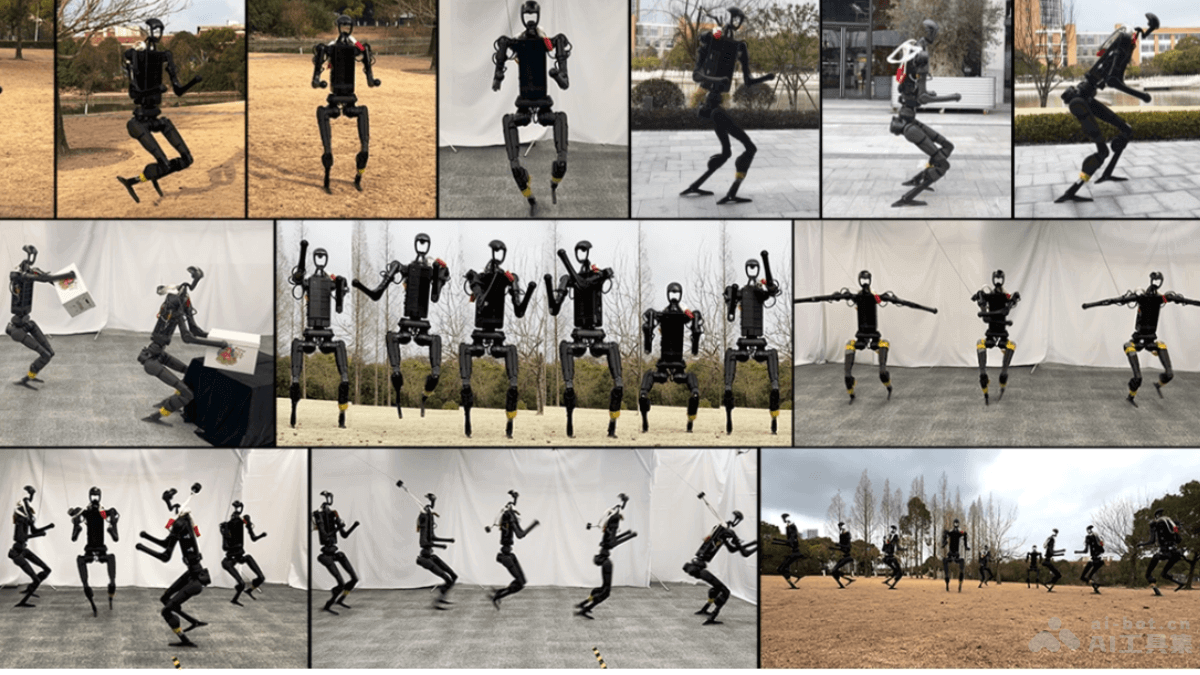
HUGWBC – 上海交大联合上海 AI Lab 推出的人形机器人全身控制器
HUGWBC(Humanoid Unified and General Whole-Body Controller)是上海交通大学、上海AI Lab联合推出的人形机器人全身控制器,能实现精细的运动控制。HUGWBC基于扩展的命令空间和先进的训练技术,让机器人执行多种自然步态(如行走、跑步、跳跃、站立和单脚跳),支持实时外部上肢控制信号,实现复杂的运动操作任务。
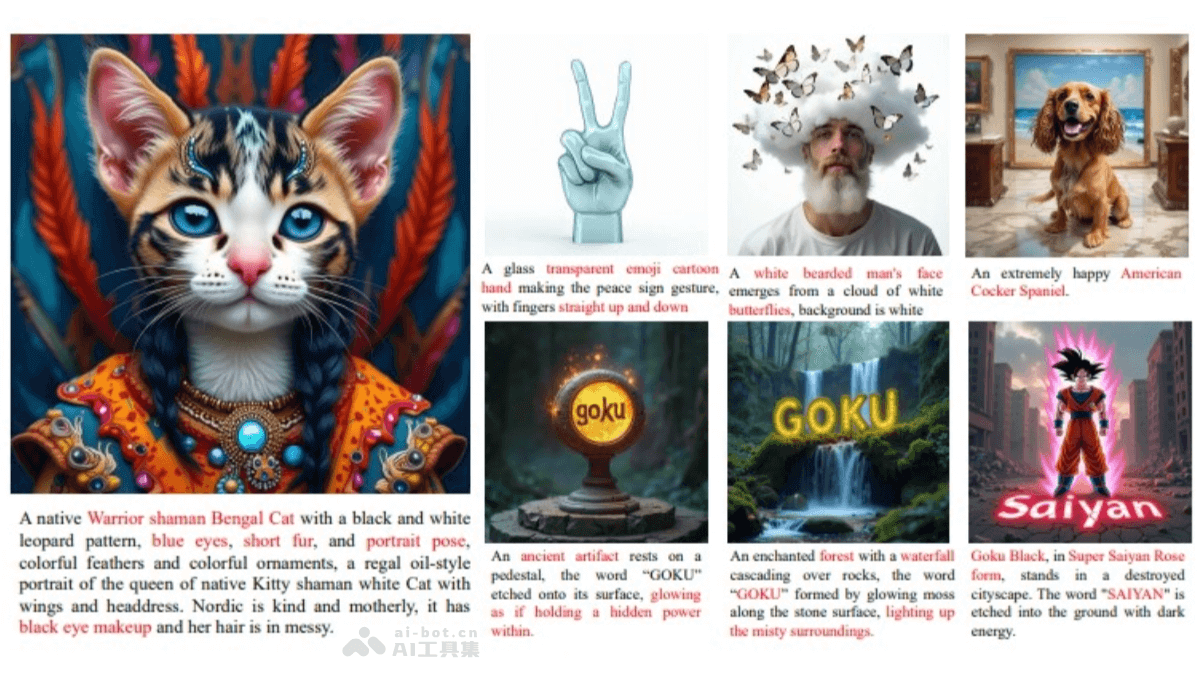
Goku – 港大和字节联合推出的最新视频生成模型
Goku是香港大学和字节跳动联合发布的最新视频生成模型,专为图像和视频的联合生成设计。基于先进的rectified flow Transformer框架,支持文生视频、图生视频及文生图等多种模式。Goku的核心优势包括高质量的视频生成能力、极低的广告视频制作成本(比传统方法低100倍)。
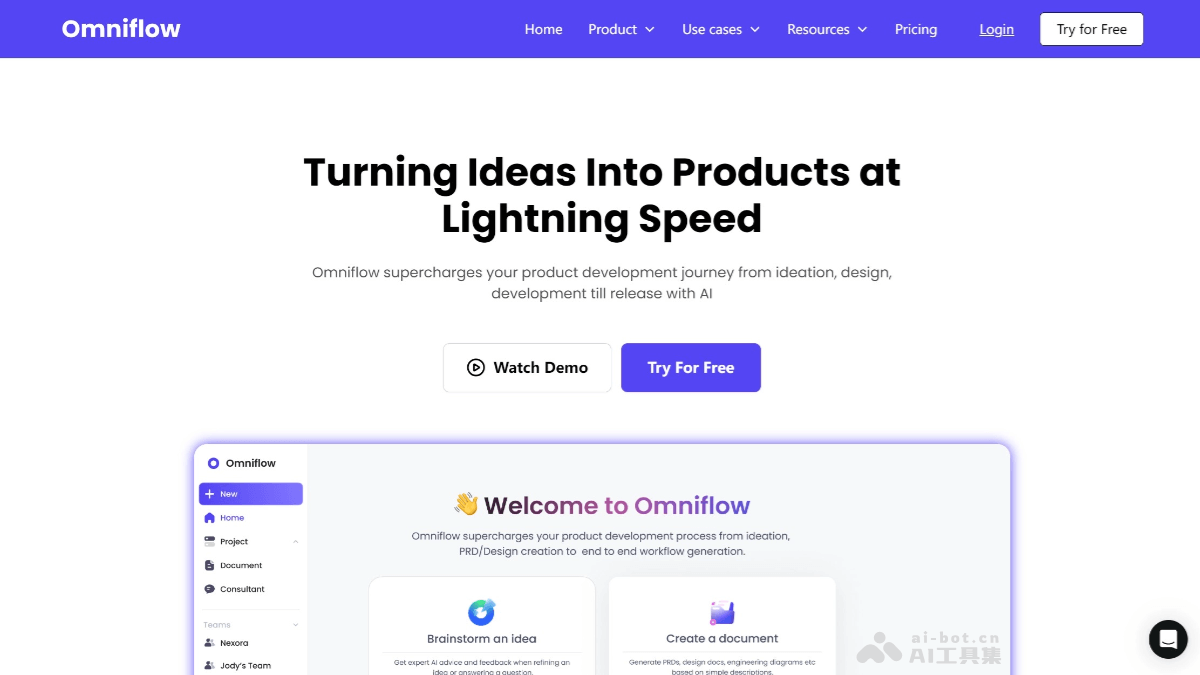
Omniflow – AI产品开发平台,提供从创意到发布的全流程支持
Omniflow 是专注于帮助用户将创意快速转化为产品的AI工具。通过 AI 技术简化产品开发流程,提供从创意到发布的全流程支持。Omniflow 的核心功能包括 IdeaFlow、DocFlow 和 DevFlow。IdeaFlow 可通过 AI 聊天提供创意反馈和协助,DocFlow 能自动生成产品需求文档、技术设计文档等,DevFlow 能自动创建任务、估算工作量并规划资源。
Satori – 开源的大语言推理模型,具备自回归搜索和自我纠错能力
Satori 是 MIT、哈佛大学等机构研究者推出的 7B 参数的大型语言模型,专注于提升推理能力。基于Qwen-2.5-Math-7B,Satori通过小规模的格式微调和大规模的增强学习实现了最先进的推理性能。采用行动思维链(COAT)机制,通过强化学习优化模型性能,具备强大的自回归搜索和自我纠错能力。
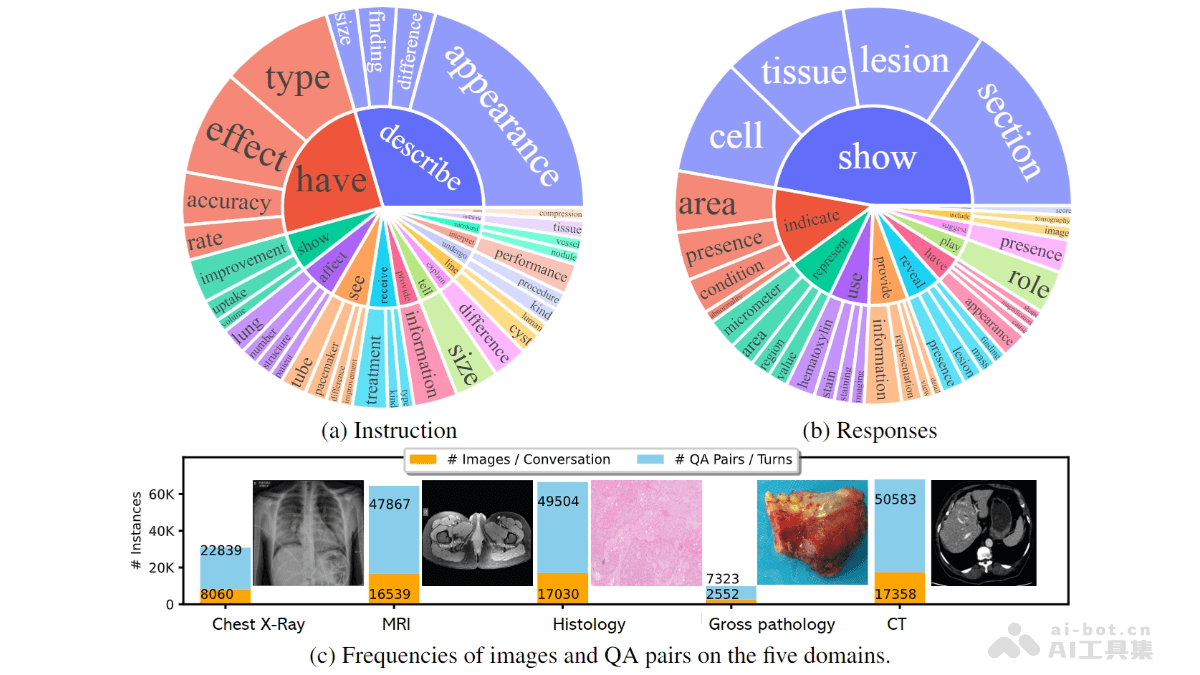
LLaVA-Rad – 微软推出的小型多模态模型,专注于临床放射学报告生成
LLaVA-Rad是微软研究院推出的小型多模态模型,专注于临床放射学报告生成。是LLaVA-Med项目的分支,特别是胸部X光(CXR)成像。基于LLaVA-Med的基础架构和训练方法,针对放射学领域的特定需求进行了优化。
DeepSeek润色指令,AI故事创作和角色塑造技巧
本篇文章是关于使用DeepSeek进行故事创作和角色塑造的润色指令,帮助创作者通过一系列具体的写作技巧和方法,提升故事的吸引力、深度和感染力。包含全面的创作指南,涵盖背景设定、情节设计、角色塑造、情感表达、故事节奏与结构以及语言风格等多个方面。
Fireflies.ai
Fireflies.ai 是 AI 会议助手,能为用户提供高质量的会议转录、总结和分析服务。工具支持 100 多种语言,转录准确率高达 95%,具备自动识别发言人、自动语言检测等功能。
Music Muse – AI音乐创作平台,简单描述生成多种风格的音乐作品
Music Muse 是AI音乐创作平台。基于先进的AI技术,帮助用户快速生成各种风格的音乐作品。 用户可以通过简单的描述(如音乐风格、情绪、节奏等)来指导AI创作出符合需求的音乐,无需具备专业的音乐知识。
Aidge – 阿里国际推出的 AI 电子商务运营服务平台
Aidge 是阿里巴巴国际数字商业集团旗下的 AI 电子商务运营服务平台,全称为AI for Digital and Global Entrepreneurship(用AI驱动全球数字商业),基于先进的 AI 技术简化全球电商运营。Aidge提供多种功能,包括大语言模型翻译、虚拟模特生成和图像处理等,帮助商家降低成本、提升转化率并加速产品上市。
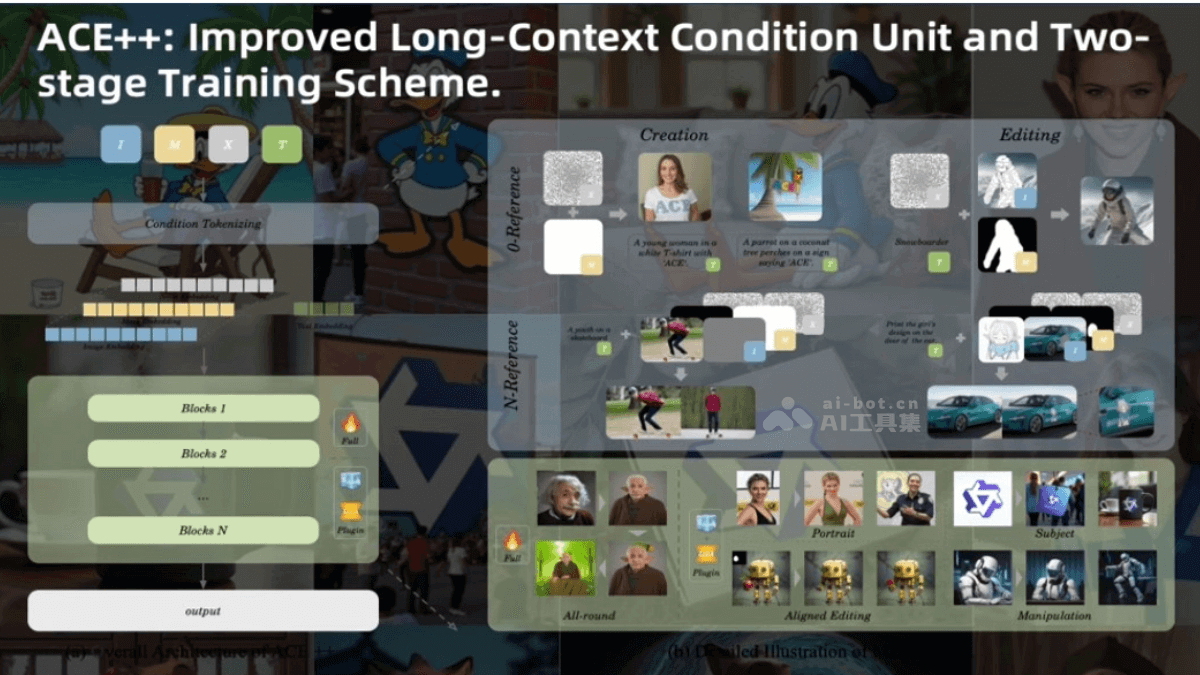
ACE++ – 阿里通义推出的升级版图像生成与编辑模型
ACE++是阿里巴巴通义实验室推出的先进的图像生成与编辑工具,通过指令化和上下文感知的内容填充技术,实现了高质量的图像创作和编辑功能。
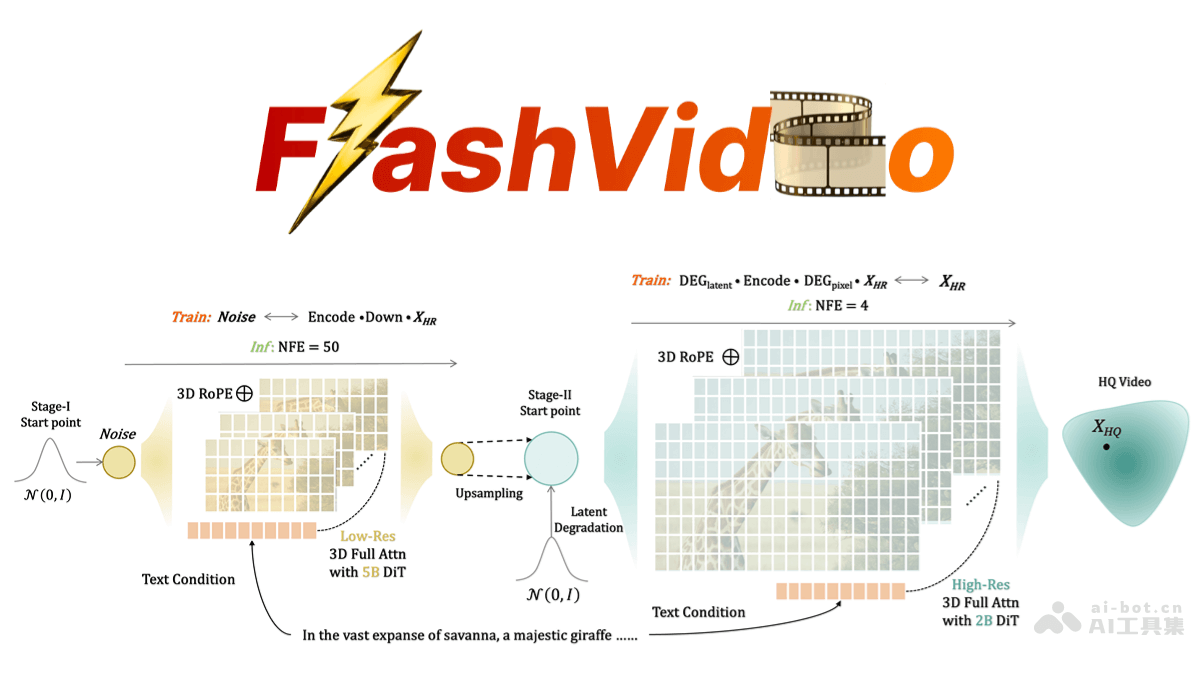
FlashVideo – 字节联合港大推出的高分辨率视频生成框架
FlashVideo是字节跳动团队提出的高效的高分辨率视频生成框架,通过两阶段方法解决了传统单阶段扩散模型在高分辨率视频生成中面临的巨大计算成本问题。在第一阶段,FlashVideo 使用 50 亿参数的大型模型在低分辨率(270p)下生成与文本提示高度一致的内容和运动,基于参数高效微调(PEFT)技术确保计算效率。
VisoMaster – AI换脸和编辑软件,支持图片和视频高质量换脸
VisoMaster 是基于 AI 技术的换脸和编辑软件,功能强大操作简便。支持图片、视频以及直播换脸,能生成自然逼真的换脸效果,应用于娱乐、影视制作等领域。支持多种输入输出格式,可通过 GPU 加速处理,大幅提升效率。
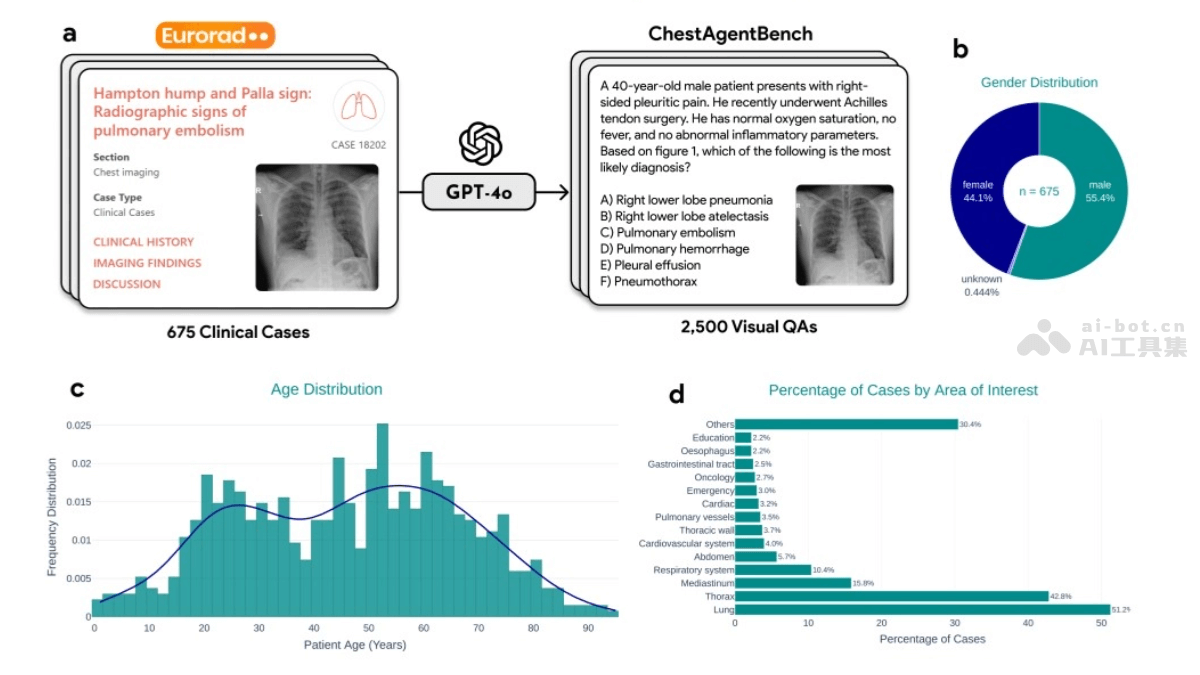
MedRAX – AI医学推理Agent,用于胸部X光检查和解决复杂医学问题
MedRAX(Medical Reasoning Agent for Chest X-ray)是专门用于胸部X光检查的医学推理AI代理。通过整合最先进的胸部X光分析工具和多模态大型语言模型,形成一个统一的框架,能动态用这些模型来解决复杂的医学查询问题,无需额外的训练。
PDFtoPDF – AI PDF转换工具,保留原文件排版格式
PDFtoPDF是基于AI技术的PDF转换工具,基于OCR技术将PDF扫描件或图像文件转换为可编辑的文本格式。PDFtoPDF高精度的OCR技术,能实现高达99.5%的识别准确率,且保留原始文档的格式。用户无需手动输入和排版,提高了文档处理效率。
GenSFX – 免费 AI 音效生成工具,输入文本描述秒级生成高质量音效
GenSFX 是免费的在线 AI 音效生成工具,能将文本描述快速转化为高质量音效。用户只需输入详细的文本指令,比如“森林中清晨的鸟鸣声”或“科幻飞船起飞的声音”,AI 在几秒内生成对应的音效。支持多种音效类型,包括环境音、动物叫声、机械声等,满足不同场景需求。
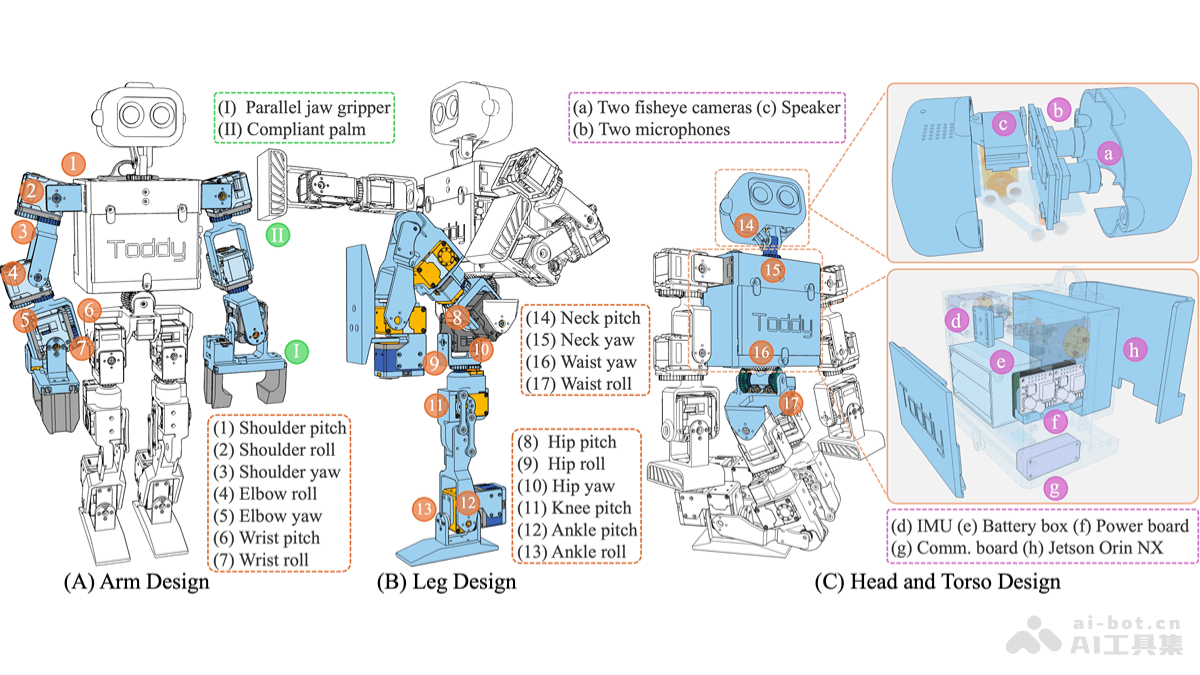
ToddlerBot – 斯坦福大学开源的机器学习与人形机器人平台
ToddlerBot是斯坦福大学开源的用在运动操作的开源机器学习与人形机器人平台,为高效收集大规模、高质量的训练数据设计。ToddlerBot具备30个主动自由度,用Dynamixel电机,总成本控制在6000美元以内。基于数字孪生技术和零点校准,ToddlerBot能实现模拟到现实的零样本转移,且远程操作设备支持高效现实世界数据收集。
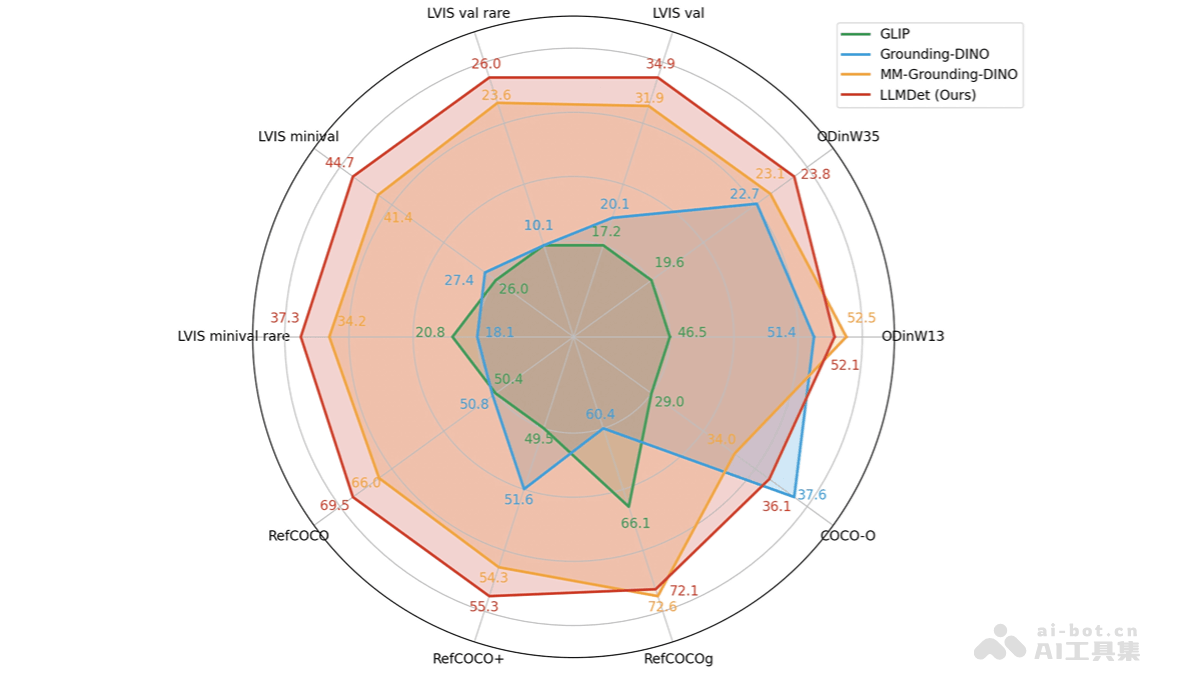
LLMDet – 阿里通义联合中山大学等机构推出的开放词汇目标检测模型
LLMDet是阿里巴巴集团通义实验室、中山大学计算机科学与工程学院、鹏城实验室等机构推出的开放词汇目标检测器,基于与大型语言模型(LLM)协同训练提升目标检测性能。LLMDet能收集包含图像、定位标签和详细图像级描述的数据集(GroundingCap-1M),用LLM生成的长描述丰富视觉特征,基于标准的定位损失和描述生成损失进行训练。