
工具 · 模型 · 行业动态
AI文章
发现新工具,了解新进展。让每一次阅读,都离用好 AI 更近一步。
7,595篇文章,持续更新
最新文章
第 229 / 422 页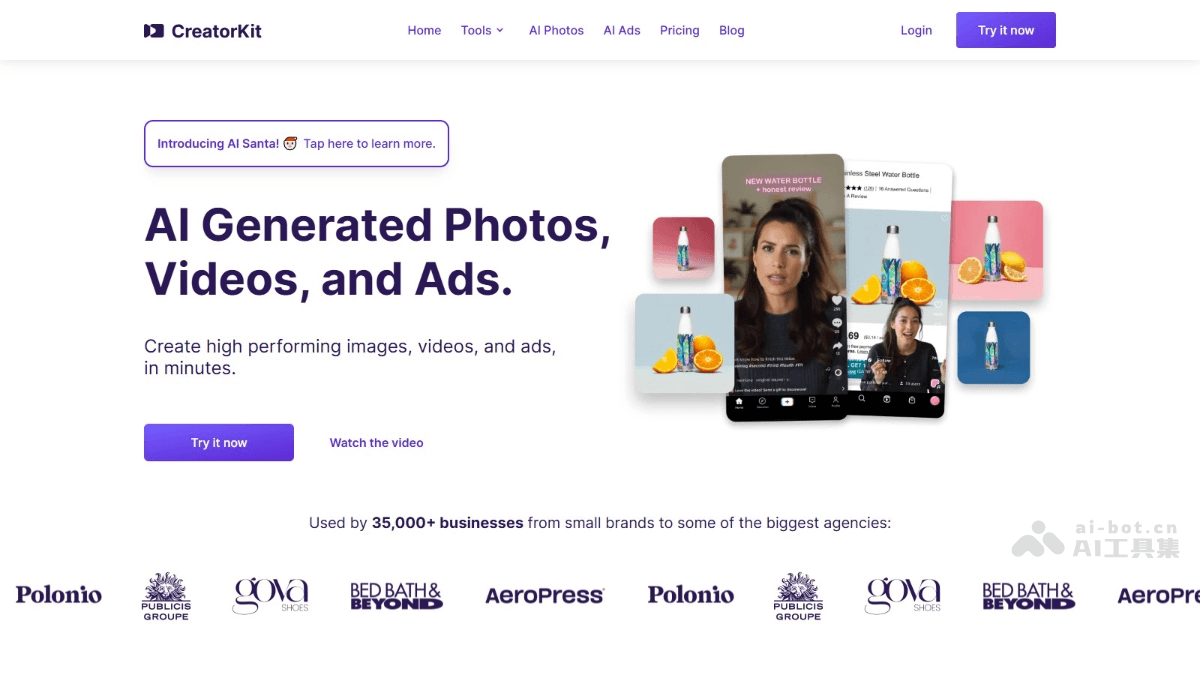
CreatorKit – AI内容创作工具,一键生成产品图片和视频
CreatorKit 是强大的AI内容创作工具,能生成高质量的图片、视频和广告,广泛应用于电商领域。CreatorKit基于AI技术,帮助用户快速创建产品图片、视频广告等视觉内容,支持一键生成广告、产品视频,与Shopify深度集成,优化内容适配多平台。
阅读全文
清华大学《AIGC发展研究报告3.0》(PDF文件) – AI教程资料
《AIGC发展研究报告3.0》由清华大学新闻与传播学院新媒体研究中心和人工智能学院联合发布,聚焦于人工智能生成内容(AIGC)技术的发展现状与未来趋势。报告从AI哲学思辨出发,探讨了AIGC对经典哲学理论的冲击与革新,如怀疑论、主体间性、儒家“信”的思想等,分析了国内外大模型的演进,包括OpenAI的o1模型、Grok 2、Llama 3.2等,探讨了生成机制、AI幻觉问题以及不同模型的应用场景。
阅读全文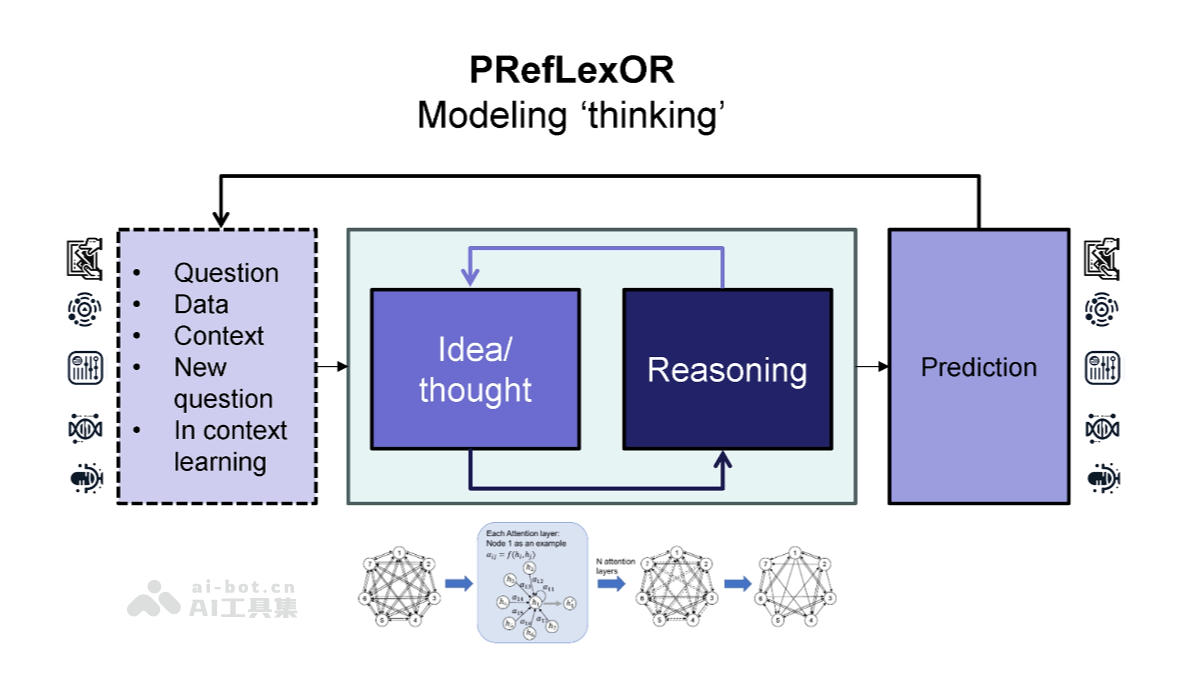
PRefLexOR – MIT 团队推出的新型自学习AI框架
PRefLexOR(Preference-based Recursive Language Modeling for Exploratory Optimization of Reasoning)是MIT团队提出的新型自学习AI框架,结合了偏好优化和强化学习(RL)的概念,模型能通过迭代推理改进自我学习。框架的核心是递归推理算法,模型在训练和推理阶段会进行多步推理、回顾和改进中间步骤,最终生成更准确的输出。
阅读全文
CogView4 – 智谱开源的AI文生图模型,支持生成汉字
CogView4 是智谱推出的开源文生图模型,具有60亿参数,支持原生中文输入和中文文字生成。模型在 DPG-Bench 基准测试中综合评分排名第一,达到开源文生图模型的最先进水平(SOTA)。
阅读全文
Microsoft Dragon Copilot – 微软推出的医疗 AI 语音助手
Microsoft Dragon Copilot 是微软推出的面向医疗行业的AI语音助手,帮助临床医生简化临床文档处理、信息检索和任务自动化。Microsoft Dragon Copilot 结合 Dragon Medical One 的语音识别能力和 DAX Copilot 的环境感知AI技术,支持多语言语音笔记创建、自动化任务、个性化格式、信息检索等功能。
阅读全文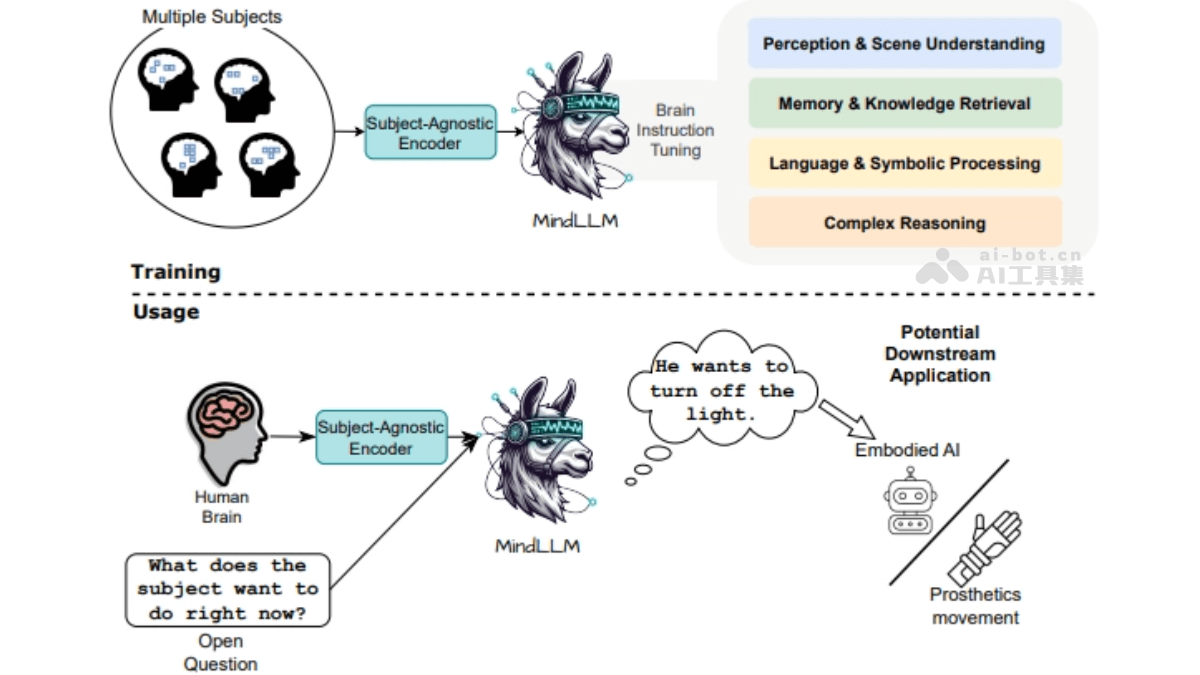
MindLLM – 耶鲁联合剑桥等机构推出的医疗领域 AI 模型
MindLLM 是耶鲁大学、达特茅斯学院和剑桥大学联合推出的AI模型,能将脑部功能性磁共振成像(fMRI)信号解码为自然语言文本。MindLLM基于一个主体无关(subject-agnostic)的 fMRI 编码器和一个大型语言模型(LLM)实现高性能解码,引入脑指令调优(Brain Instruction Tuning,BIT)技术,捕捉 fMRI 信号中的多样化语义信息。
阅读全文
UX Pilot – AI设计助手,文本提示快速生成高保真设计界面
UX Pilot 是 AI 驱动的 UX/UI 设计工具,基于AI技术简化和加速设计流程。UX Pilot 根据文本提示快速生成从低保真线框图到高保真界面的设计,支持智能调整视觉风格、生成多样化的界面变体及跨平台的原型开发。
阅读全文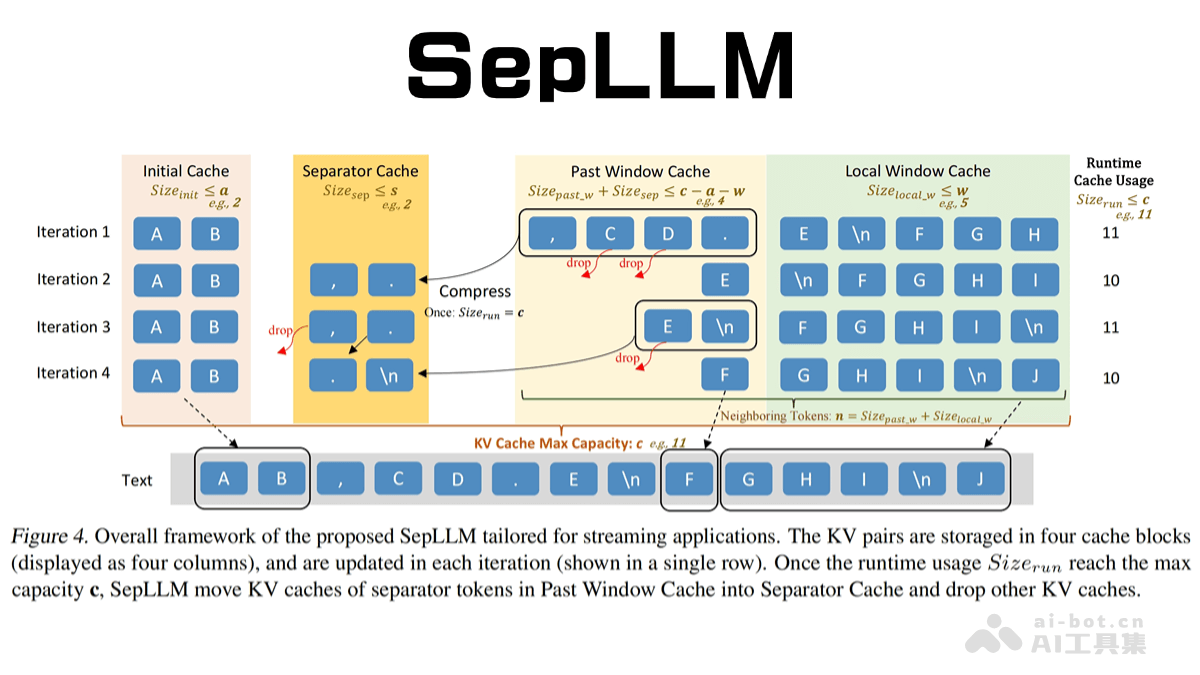
SepLLM – 基于分隔符压缩加速大语言模型的高效框架
SepLLM是香港大学、华为诺亚方舟实验室等机构联合提出的用于加速大语言模型(LLM)的高效框架,通过压缩段落信息并消除冗余标记,显著提高了模型的推理速度和计算效率。SepLLM的核心是利用分隔符(如标点符号)对注意力机制的贡献,将段落信息压缩到这些标记中,减少计算负担。
阅读全文
Spark-TTS – AI文本转语音工具,支持中英零样本语音克隆
Spark-TTS 是SparkAudio 团队开源的基于大型语言模型(LLM)的高效文本转语音(TTS)工具, 无需额外的生成模型,直接从 LLM 预测的编码中重建音频,实现零样本文本到语音的转换。Spark-TTS 支持中英双语,具备跨语言合成能力,可通过参数调整(如性别、音调、语速)生成虚拟说话者的声音,满足多样化需求。
阅读全文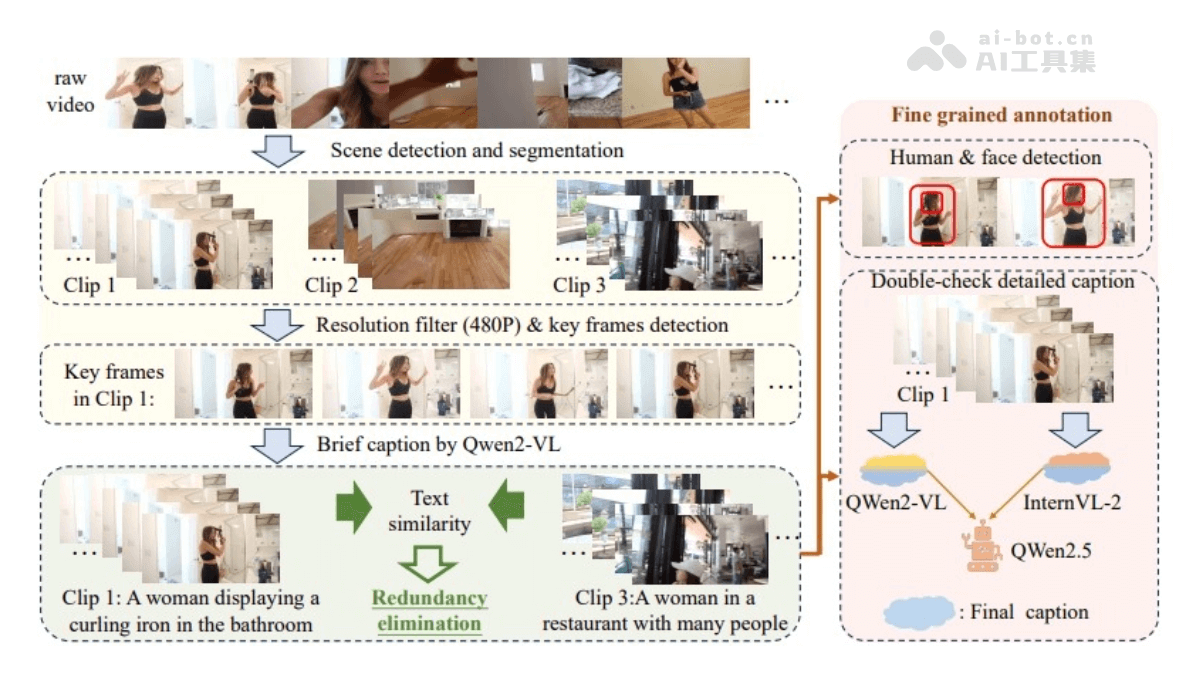
HumanOmni – 阿里通义等推出专注人类中心场景的多模态大模型
HumanOmni 是专注于人类中心场景的多模态大模型,视觉和听觉模态融合而成。通过处理视频、音频或两者的结合输入,能全面理解人类行为、情感和交互。模型基于超过240万视频片段和1400万条指令进行预训练,采用动态权重调整机制,根据不同场景灵活融合视觉和听觉信息。
阅读全文
Shandu – AI研究工具,自动进行多层次信息挖掘和分析
Shandu 是开源的 AI 研究自动化工具,结合了 LangChain 和 LangGraph 技术,能自动化地进行多层次信息挖掘和分析,生成结构化的研究报告。Shandu 的核心功能包括递归探索、多引擎搜索、智能网页爬取以及报告生成。
阅读全文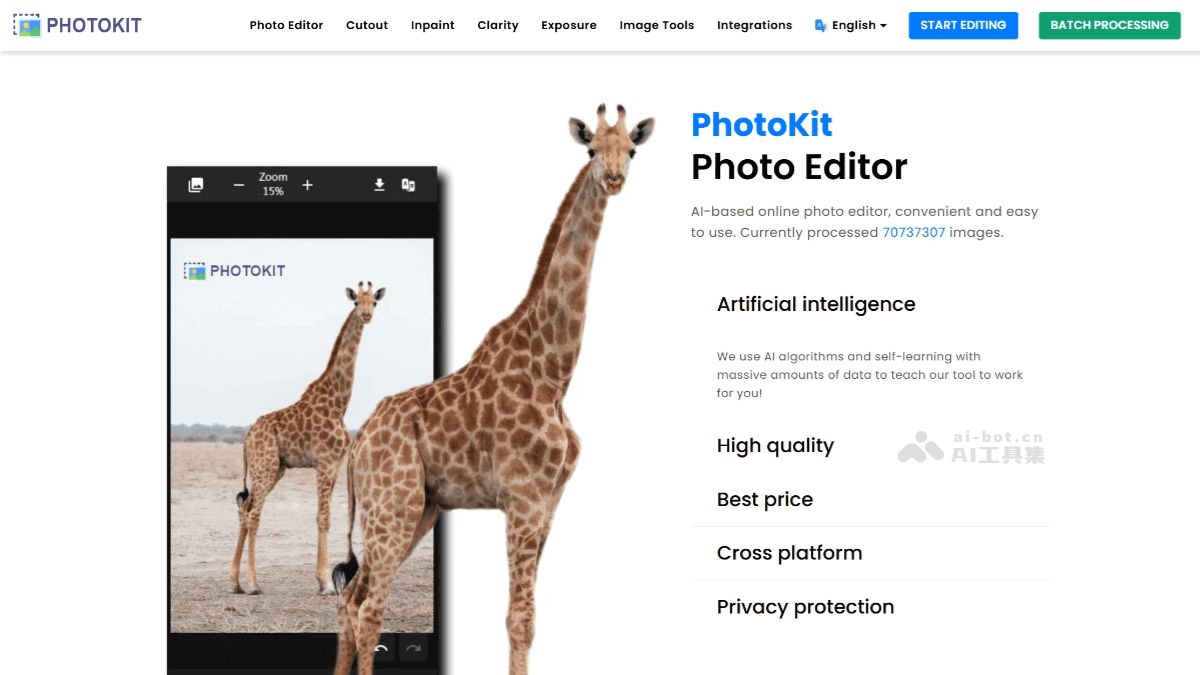
PhotoKit – AI图片编辑工具,一键识别分离主体与背景
PhotoKit是基于AI技术的在线图片编辑工具,支持一键AI抠图,能快速识别去除背景,通过智能笔刷修复照片、消除瑕疵或移除不需要的元素。PhotoKit提供画质增强、曝光修复等功能,可优化图片清晰度和明暗对比。
阅读全文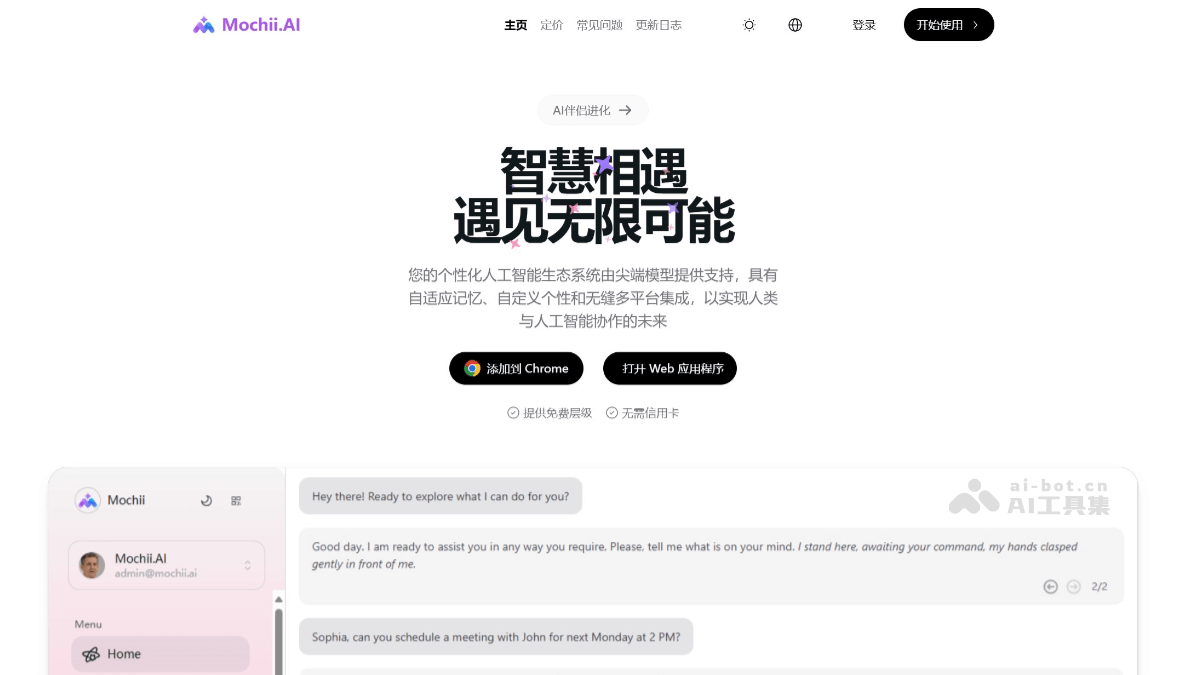
Mochii AI – 多功能 AI 助手,提供智能对话、文档分析、网页总结等
Mochii AI 是多功能的智能AI助手,通过先进的人工智能技术提升用户的生产力和创造力。支持多种高级AI模型,如GPT-4、Claude 3.5和Gemini,能提供智能对话、语音交互、文档分析以及网页总结等功能。
阅读全文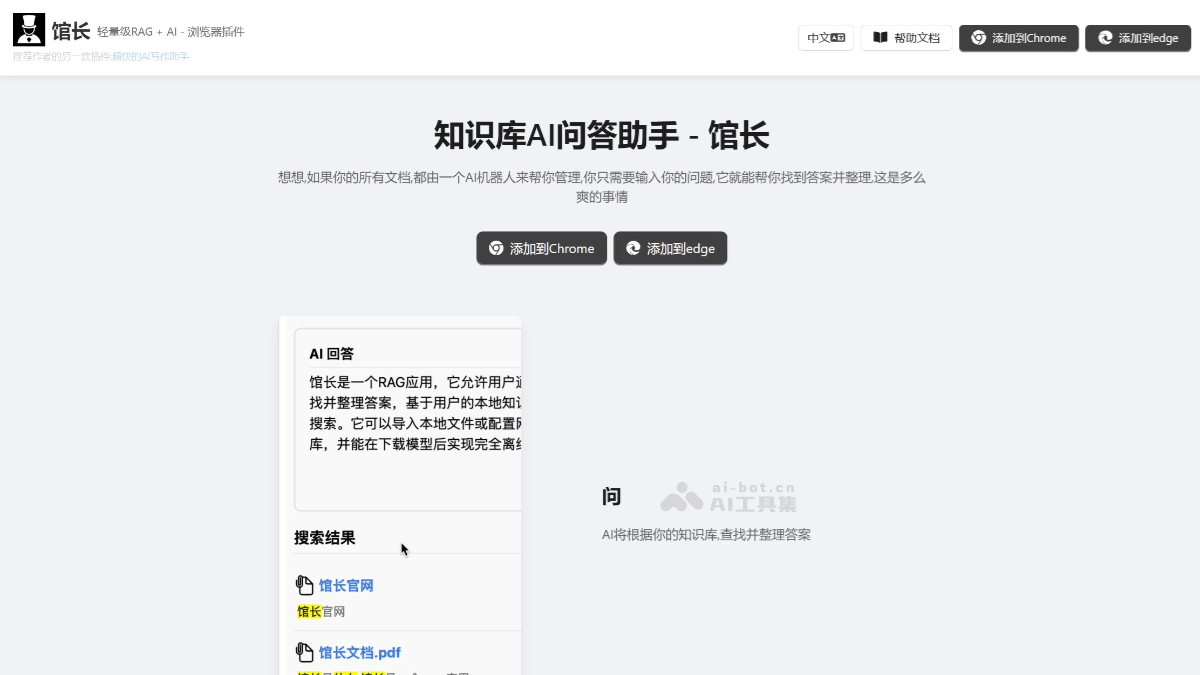
馆长 – 知识库AI问答助手,分析文档提供精准答案
馆长是轻量级的RAG(检索增强生成)知识库AI问答助手,以浏览器插件的形式为用户提供知识整理与查询服务。支持将本地文件(如PDF、Word、TXT等)、网页内容或浏览器书签导入知识库,通过语义搜索和AI分析,快速提供精准答案。
阅读全文
Buildin.AI – AI知识管理平台,支持智能写作、内容生成和数据分析
Buildin.AI 是集成了 AI 功能的云端知识管理和协作平台,专为高效团队和个人设计。支持多人实时协作,涵盖文档编辑、项目管理、笔记记录等多种功能,配备强大的 AI 助手,可实现智能写作、内容生成和数据分析。
阅读全文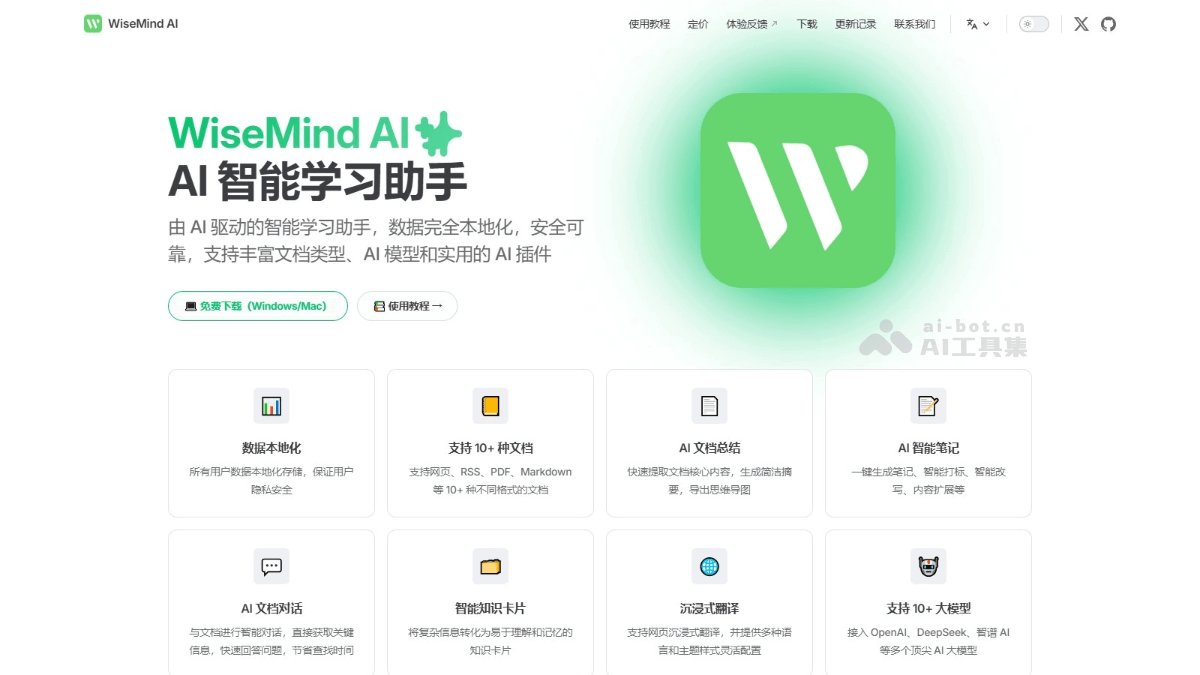
WiseMind AI – AI智能学习助手,支持文档总结、思维导图、海报生成等
WiseMind AI 是 AI 驱动的智能学习助手,专注于为用户提供高效的学习与知识管理体验。WiseMind AI 支持网页、PDF、Markdown 等 10+ 种文档格式,快速提取文档核心内容生成摘要、思维导图和智能笔记,将复杂信息转化为知识卡片,便于理解和记忆。
阅读全文
ARTalk – 东京大学等机构推出的3D头部动画生成框架
ARTalk是东京大学和日本理化学研究所推出的新型语音驱动3D头部动画生成框架,基于自回归模型实现实时、高同步性的唇部动作和自然的面部表情及头部姿势生成。ARTalk用多尺度运动码本和滑动时间窗口技术,结合语音输入生成高质量的动画序列。
阅读全文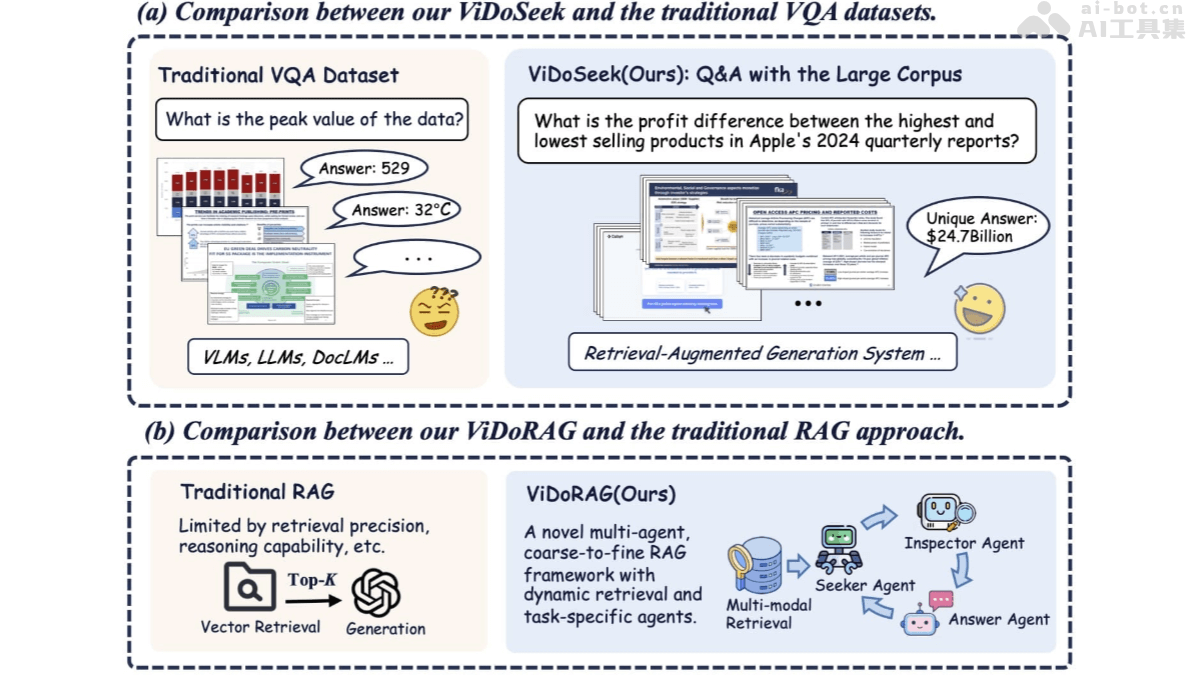
ViDoRAG – 通义联合中科大、上交大推出的视觉文档检索增强生成框架
ViDoRAG是阿里巴巴通义实验室联合中国科学技术大学和上海交通大学推出的视觉文档检索增强生成框架。基于多智能体协作和动态迭代推理,解决传统方法在处理复杂视觉文档时的检索和推理局限性。ViDoRAG用高斯混合模型(GMM)的多模态混合检索策略,动态调整检索结果数量,优化文本和视觉信息的整合。
阅读全文