
工具 · 模型 · 行业动态
AI文章
发现新工具,了解新进展。让每一次阅读,都离用好 AI 更近一步。
7,595篇文章,持续更新
最新文章
第 228 / 422 页
GPTExcel – AI电子表格助手,自动化脚本编写、SQL 查询生成
GPTExcel 是基于人工智能的电子表格助手工具,帮助用户高效处理 Excel、Google Sheets 等电子表格任务。通过智能化功能,如公式生成、自动化脚本编写、SQL 查询生成等,简化了复杂的数据处理流程。
阅读全文
小荷AI医生 – 字节旗下小荷健康推出的 AI 医疗助手
小荷AI医生是字节跳动旗下小荷健康推出的医疗健康AI大模型产品,基于豆包大模型推出,提供免费的健康咨询服务。小荷AI医生基于人机对话形式,为用户提供诊前信息收集、分诊导诊、健康咨询回复、报告解读、AI用药助手等功能。
阅读全文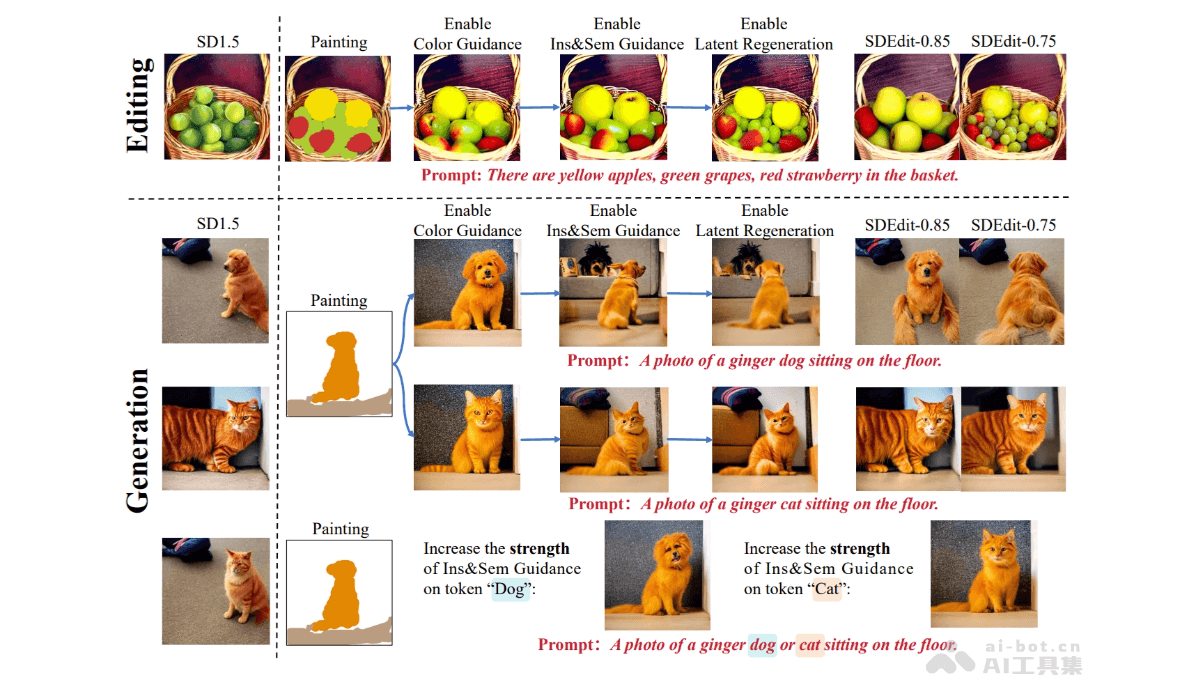
DiffBrush – 北邮联合清华等机构推出的图像生成与编辑框架
DiffBrush是北京邮电大学、清华大学、中国电信人工智能研究所和西北工业大学推出的,无需训练的图像生成与编辑框架,支持用户基于手绘草图直观地控制图像生成。DiffBrush用预训练的文本到图像(T2I)模型,基于颜色引导、实例与语义引导及潜在空间再生等技术,精准控制生成图像的颜色、语义和实例分布。
阅读全文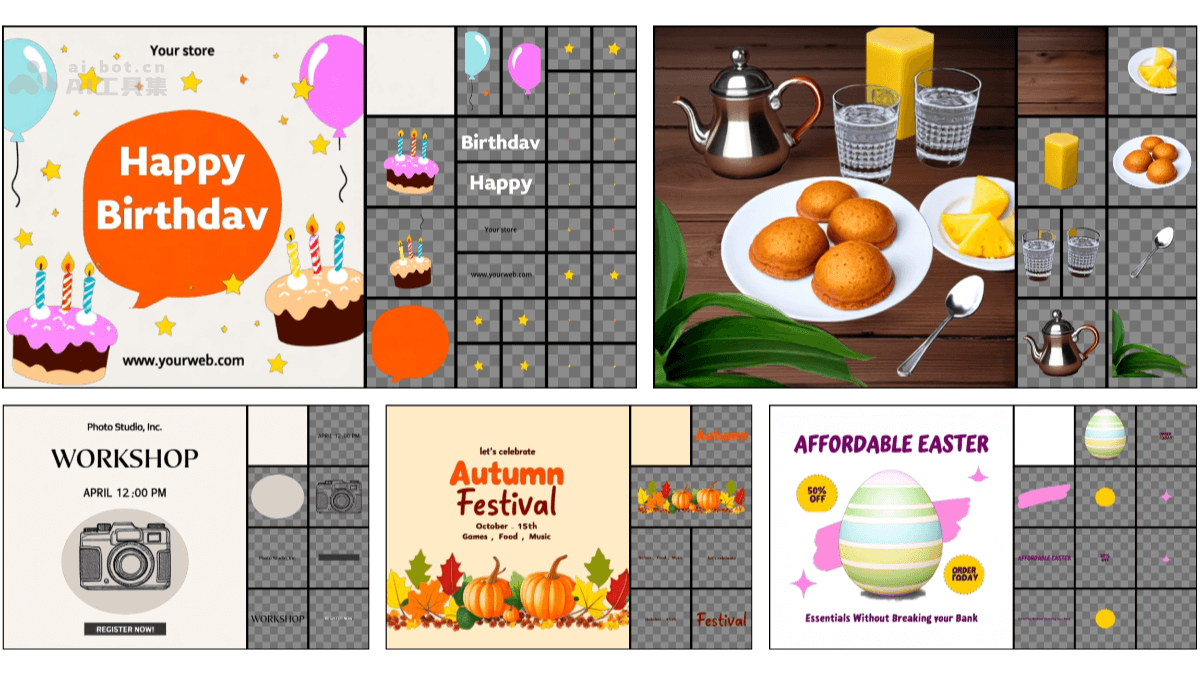
ART – 微软联合清华和北大等推出的多层透明图像生成技术
ART(Anonymous Region Transformer) 是新型的多层透明图像生成技术,能根据全局文本提示和匿名区域布局直接生成多个独立的透明图层(支持 RGBA 格式),图层可以单独编辑、组合或叠加。
阅读全文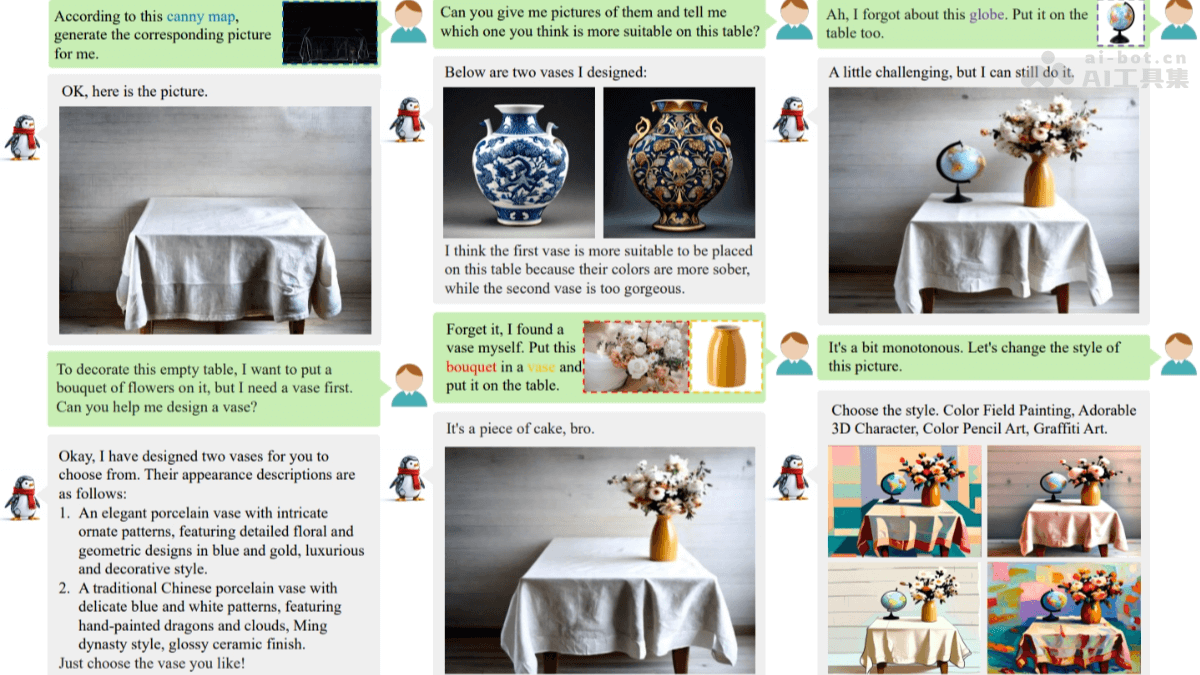
WeGen – 中科大联合上海交大等推出的统一多模态生成模型
WeGen 是中国科学技术大学联合上海交通大学、微信团队、中国科学院等机构推出的统一多模态生成模型,基于自然对话实现多样化的视觉生成任务。WeGen结合多模态大语言模型(MLLM)和扩散模型,处理文本到图像生成、条件驱动生成、图像编辑、风格迁移等多种任务。
阅读全文
NextGenAI – OpenAI 推出的教育联盟,联合15家顶尖大学和机构
NextGenAI是OpenAI推出的全球性联盟,基于AI技术推动教育和研究的进步。NextGenAI联合包括哈佛大学、麻省理工学院、牛津大学等在内的15所顶尖大学和机构,OpenAI为其提供5000万美元的资金支持、计算资源和API接口。各成员机构基于AI技术在医疗、教育、图书馆等领域展开创新应用,例如缩短罕见病诊断时间、开发先进学习模型、数字化罕见文献等。
阅读全文
Asyncflow v1.0 – Podcastle 推出的 AI 文本转语音模型
Asyncflow v1.0 是播客平台 Podcastle 推出的 AI 文本转语音模型。支持超过 450 种语音选项,能为文本内容生成高质量的语音朗读,适用于多种语言和风格。
阅读全文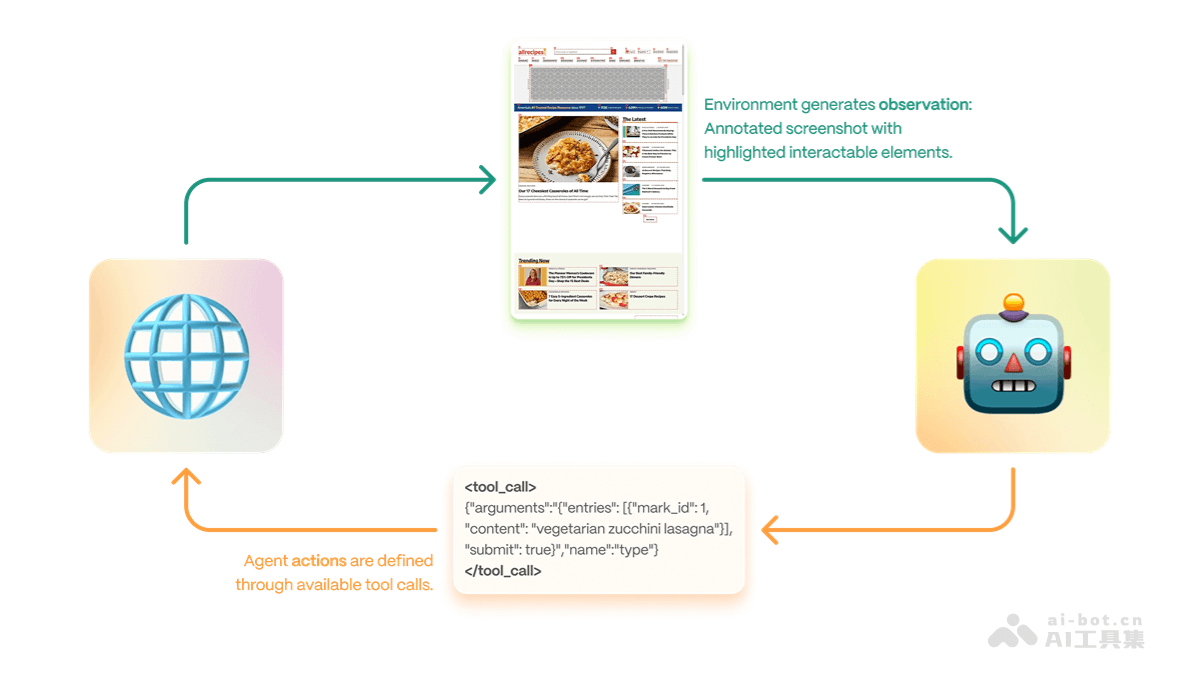
Proxy Lite – 开源视觉语言模型,支持自动化网页任务
Proxy Lite 是开源的轻量级视觉语言模型(VLM),参数量为3B,支持自动化网页任务。Proxy Lite 能像人类一样操作浏览器,完成网页交互、数据抓取、表单填写等重复性工作,显著降低自动化成本。Proxy Lite用“观察-思考-工具调用”的三步决策机制,具备强大的泛化能力和低资源占用,支持在消费级GPU上高效运行。
阅读全文
Granite 3.2 – IBM 开源的多模态系列 AI 模型
Granite 3.2 是IBM开源的多模态AI模型系列,具备强大的推理、视觉理解和预测能力。Granite 3.2包含多个版本, Granite 3.2 Instruct 提供实验性链式推理能力,显著提升复杂指令执行性能;Granite Vision 3.2 2B 是首个视觉语言模型,专注于文档理解,性能媲美更大规模模型。
阅读全文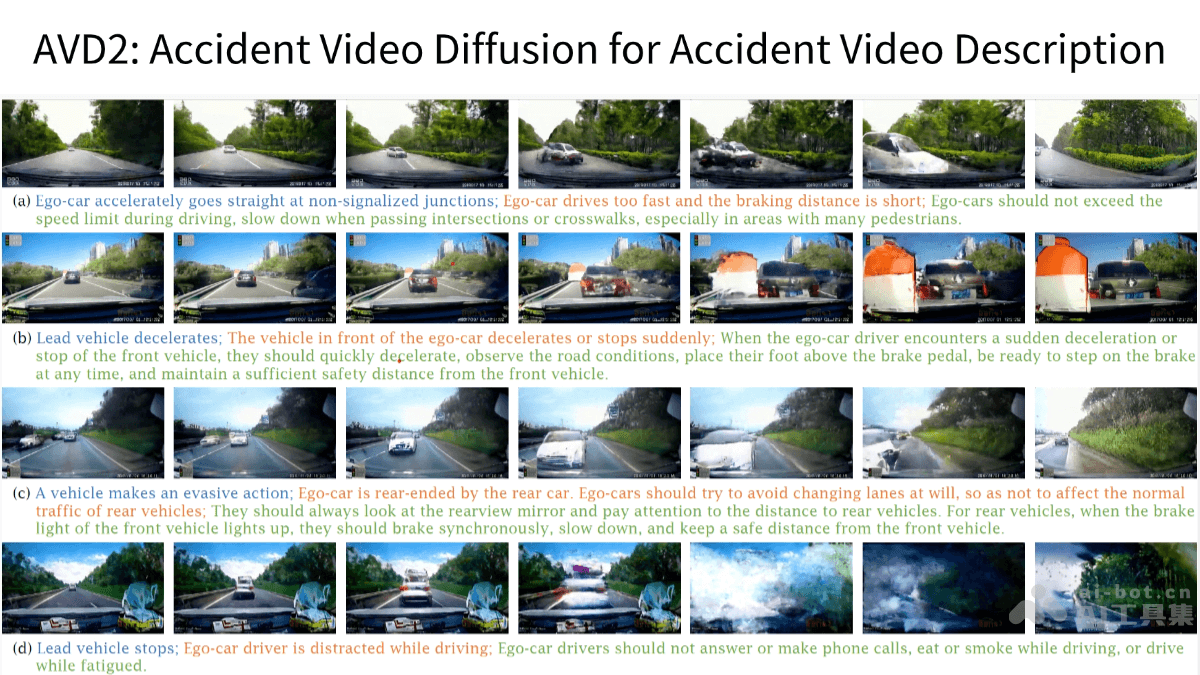
AVD2 – 清华联合复旦等机构推出的自动驾驶事故视频理解与生成框架
AVD2(Accident Video Diffusion for Accident Video Description)是清华大学联合香港科技大学、吉林大学、南京理工大学、北京理工大学、复旦大学等机构推出的,用在自动驾驶事故视频理解的创新框架。基于生成与详细自然语言描述和推理对齐的事故视频,显著提升对复杂事故场景的理解能力。
阅读全文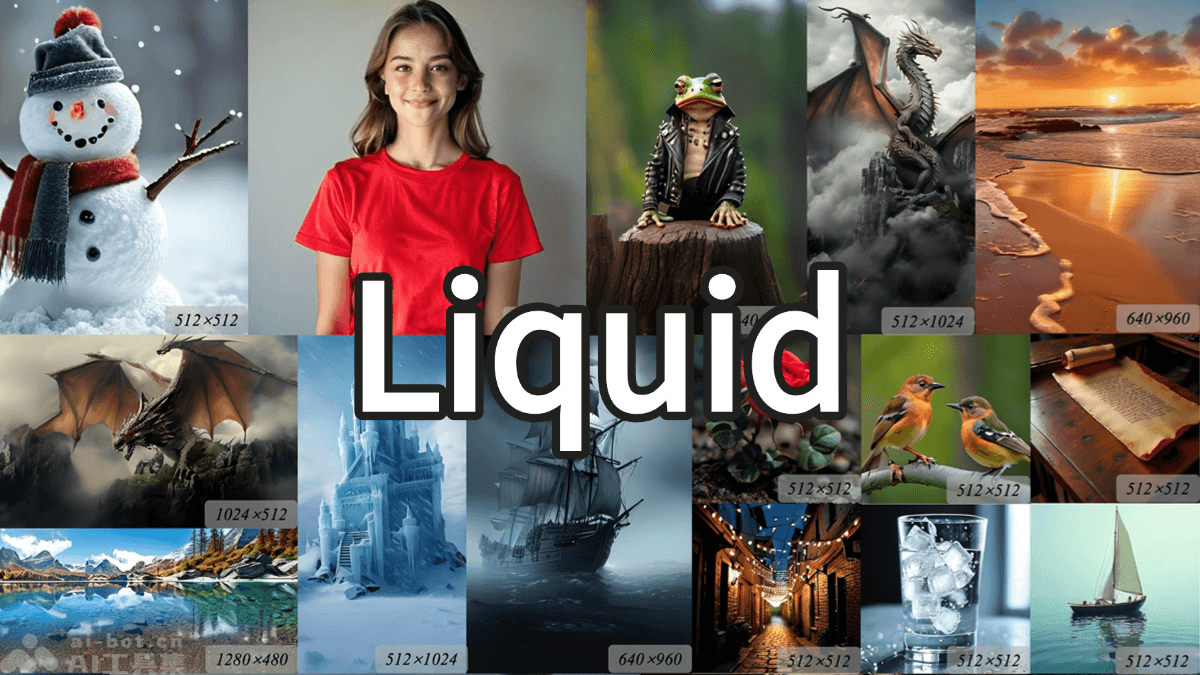
Liquid – 华中科技、字节、港大联合推出的统一多模态生成框架
Liquid是华中科技大学、字节跳动和香港大学联合推出的极简统一多模态生成框架。基于VQGAN将图像编码为离散的视觉token,与文本token共享同一词汇空间,让大型语言模型(LLM)无需修改结构实现视觉生成与理解。
阅读全文
Image-01 – MiniMax 推出的文本到图像生成模型
Image-01 是 MiniMax 推出的先进文本到图像生成模型,具备卓越的图像生成能力。能将用户输入的文本描述精准转化为高质量图像,支持多种纵横比和高分辨率输出,适合从社交媒体到专业商业项目的广泛应用。
阅读全文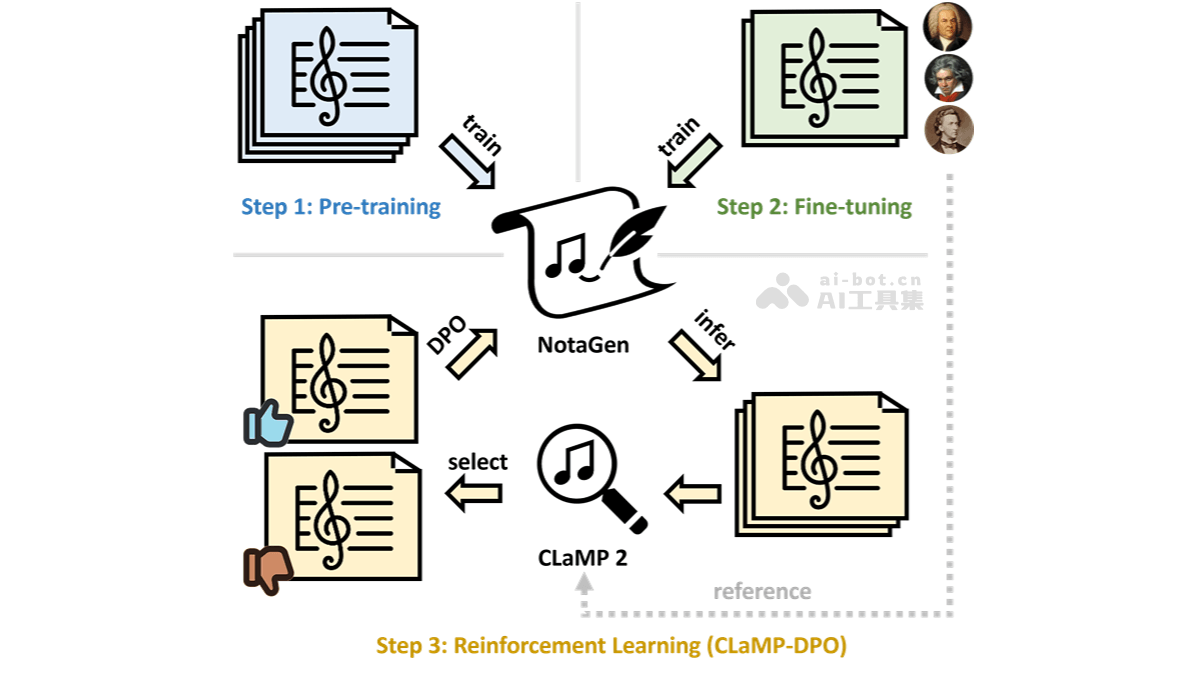
NotaGen – 中央音乐学院联合北航、清华等推出的音乐生成模型
NotaGen 是中央音乐学院、北京航空航天大学、清华大学等机构推出的音乐生成模型,基于模仿大型语言模型(LLM)的训练范式生成高质量的古典乐谱。NotaGen 基于预训练、微调和强化学习相结合的方法,预训练阶段用超过160万首乐曲,微调阶段基于约9000首高质量古典作品,基于“时期-作曲家-乐器”提示进行条件生成。
阅读全文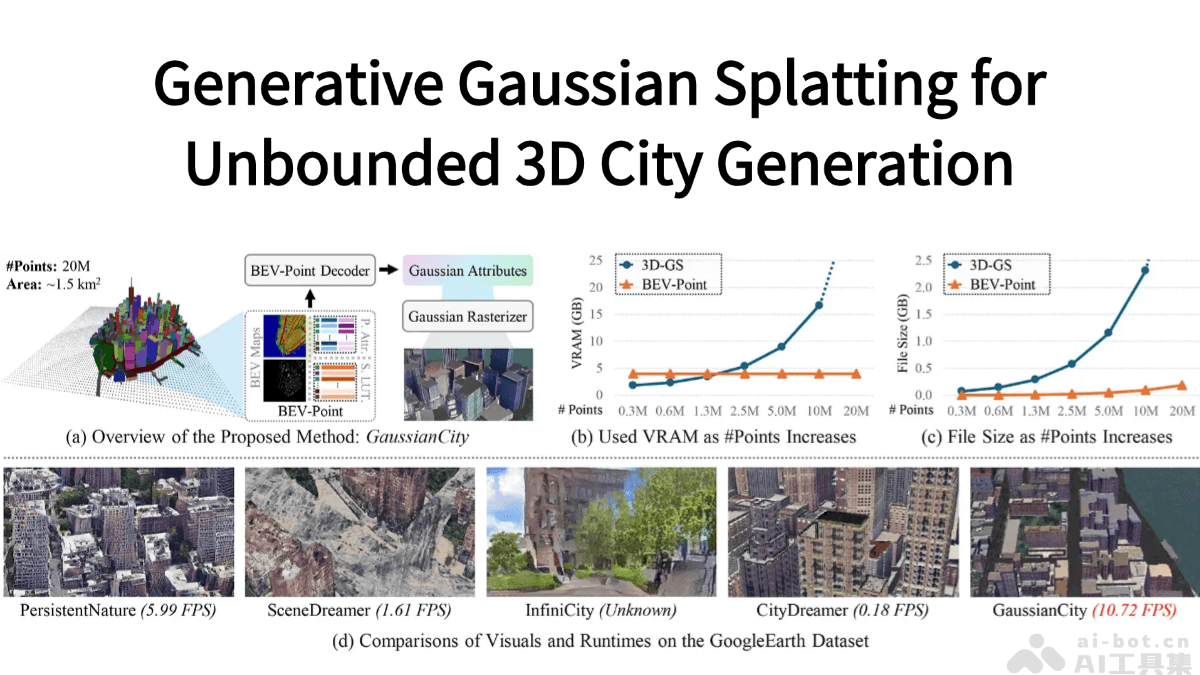
GaussianCity – 南洋理工大学 S-Lab 团队推出的 3D 城市生成框架
GaussianCity 是南洋理工大学 S-Lab 团队推出的高效无边界3D城市生成框架,基于3D高斯绘制(3D-GS)技术。引入紧凑的 BEV-Point 表示方法,将场景的显存(VRAM)使用量保持在恒定水平,解决大规模场景生成中显存和存储需求过高的问题。
阅读全文
SpeciesNet – Google 开源的动物物种识别 AI 模型
SpeciesNet 是 Google 开源的人工智能模型,通过分析相机陷阱拍摄的照片来识别动物物种。基于超过 6500 万张图像训练而成,能识别超过 2000 种标签,包括动物物种、分类单元以及非动物对象。
阅读全文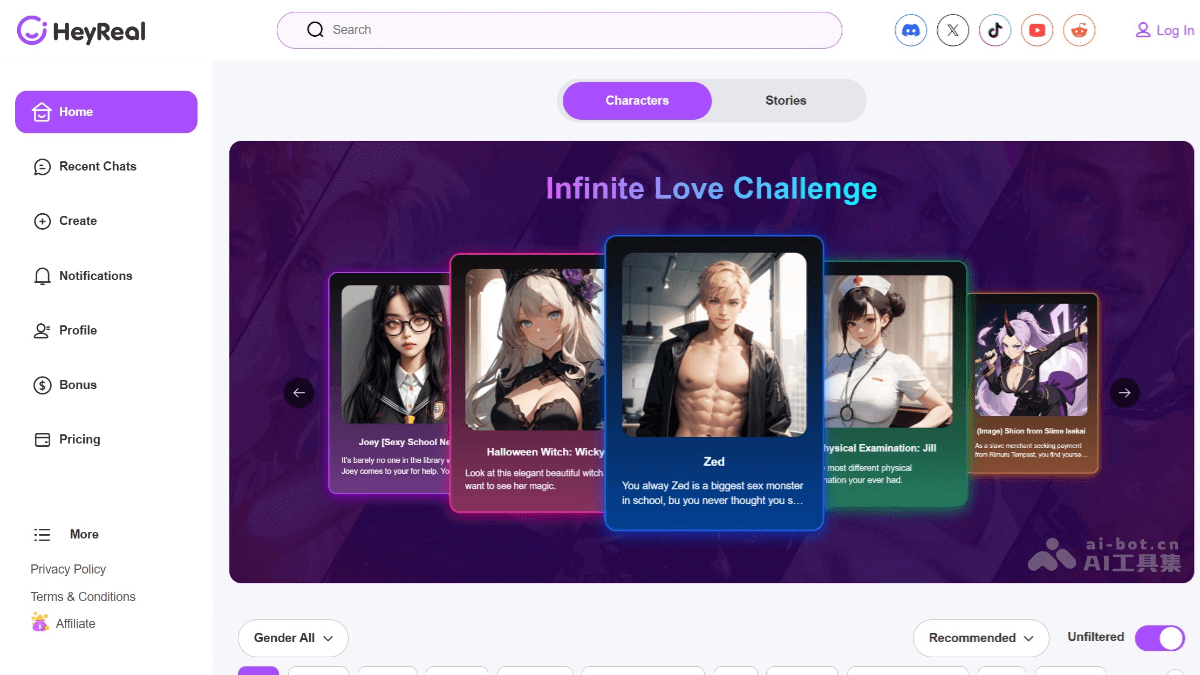
HeyReal – AI虚拟角色创建平台,支持兴趣和需求定制 AI 角色
HeyReal 是专注于个性化虚拟角色互动的创新平台,用户可以创建定制独一无二的虚拟角色,包括外貌、性格和背景故事。平台支持无限制的 NSFW(成人向)内容,为用户提供高度自由的聊天体验。
阅读全文
Sourcetable – AI驱动的电子表格和数据分析工具
Sourcetable 是基于人工智能技术的电子表格和数据分析工具,通过 AI 功能简化数据管理任务。支持数据清理、公式生成、图表创建、实时数据同步和语音交互等功能。用户可以快速分析文件、生成可视化图表。
阅读全文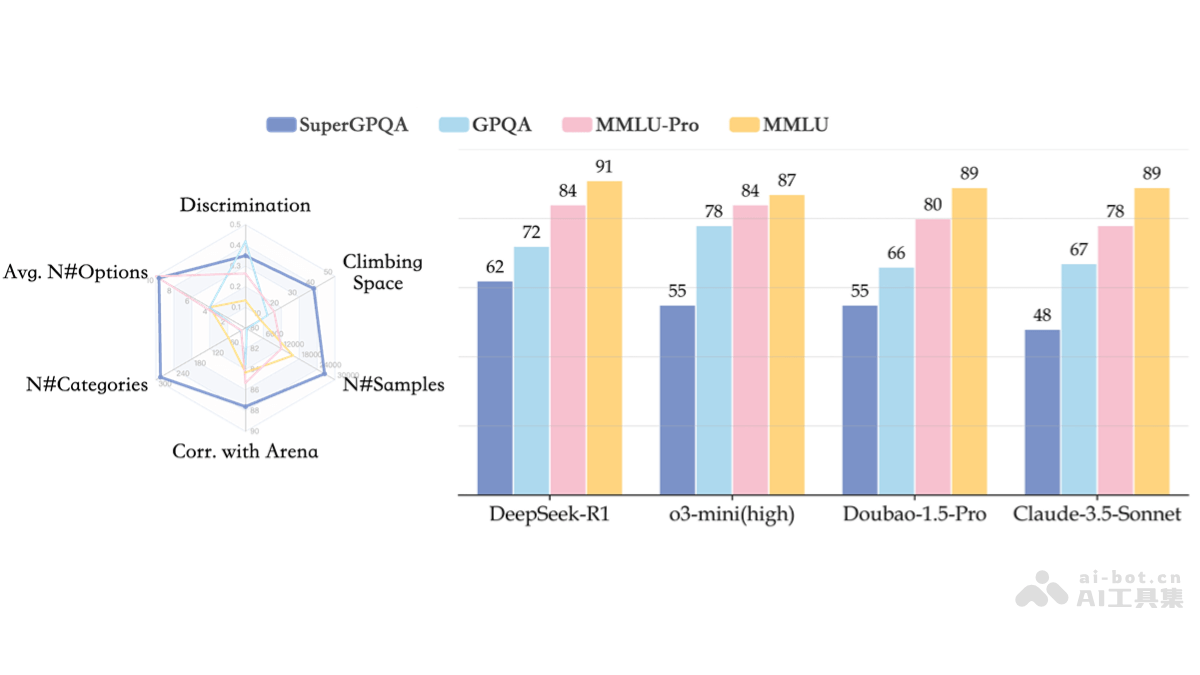
SuperGPQA – 豆包大模型联合 M-A-P 开源的知识推理基准测试集
SuperGPQA 是字节跳动豆包大模型团队联合 M-A-P 推出的全面覆盖 285 个研究生级学科、包含 26529 道专业题目的知识推理基准测试集。解决传统评测基准学科覆盖不全、题目质量存疑和评测维度单一的问题,基于专家与大语言模型协同构建,确保题目的高质量和高难度。
阅读全文