
工具 · 模型 · 行业动态
AI文章
发现新工具,了解新进展。让每一次阅读,都离用好 AI 更近一步。
7,595篇文章,持续更新
最新文章
第 416 / 422 页
GPT-SoVITS – 开源的声音克隆项目,只需少量数据即可合成声音
GPT-SoVITS是一个开源的声音克隆项目,该语音合成工具结合了GPT模型和SoVITS变声器技术,仅需通过少量的样本数据实现高质量的语音克隆和文本到语音转换。该工具特别适用于需要快速生成特定人声的场景,可以帮助用户在没有或只有少量目标说话人语音样本的情况下,训练出能够模仿该说话人声音的模型。
阅读全文
VideoPrism – 谷歌研究团队推出的通用视频编码器
VideoPrism是一个由谷歌研究团队开发的通用视频编码器,旨在通过一个单一的冻结模型来处理多种视频理解任务。该模型能够从视频中提取丰富的语义表示,使其能够在不同的视频理解任务中实现高性能和准确率,例如视频分类、定位、检索、描述生成和问答等。
阅读全文
YOLOv9 – 新一代高效的实时目标检测系统
YOLOv9是一个由台北中研院和台北科技大学等机构的研究团队推出的新一代先进的目标检测系统,是YOLO(You Only Look Once)算法系列的最新版本。YOLOv9在前代版本的基础上进行了改进,旨在解决深度学习中信息丢失的问题,并提高模型在各种任务上的性能。
阅读全文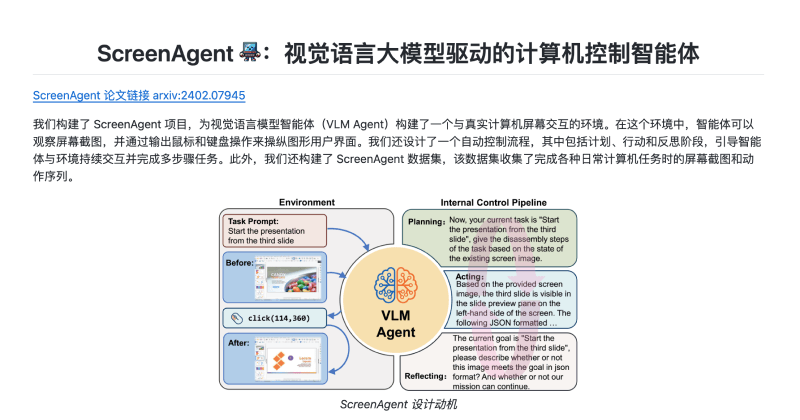
ScreenAgent – 基于视觉语言模型的计算机控制智能体
ScreenAgent是一个由吉林大学人工智能学院的研究团队开发的计算机控制智能体,该智能体是基于视觉语言模型(VLM)构建的,能够与真实计算机屏幕进行交互。ScreenAgent的核心功能是通过观察屏幕截图,并输出相应的鼠标和键盘动作来操纵图形用户界面(GUI),从而执行多步骤的复杂任务。
阅读全文
ConsiStory – 免训练实现主题一致性的文生图方法
ConsiStory是由NVIDIA和特拉维夫大学的研究人员共同开发的一种无需训练的文本生成图像的方法,可以实现让图像在保持风格和主题不变的情况下,遵循不同的文本提示快速且自然地扩展到不同的场景下。
阅读全文
Stable Diffusion 3 – Stability AI推出的新一代图像生成模型
Stable Diffusion 3 是由 Stability AI 开发的一款先进的文本到图像生成模型,是 Stable Diffusion 系列模型的最新迭代,旨在通过文本提示生成高质量的图像。该模型相较于上代模型在多个关键方面(如文本渲染能力、多主题提示能力、图像质量等)进行了改进。
阅读全文
SDXL-Lightning – 字节跳动推出的文本到图像生成模型
SDXL-Lightning是由字节跳动的研究团队推出的一种基于扩散模型的文本到图像生成技术,旨在解决传统扩散模型在图像生成速度和计算成本上的局限性。该模型基于 SDXL(Stable Diffusion XL)架构,通过结合渐进式和对抗式蒸馏方法,实现了在一步或少数几步内快速生成1024像素分辨率的高质量图像。
阅读全文
VideoPoet – 谷歌推出的AI视频生成模型
VideoPoet是由谷歌的研究团队开发的一种基于大模型的AI视频生成方案,支持从文本、图像或视频输入中合成高质量的视频内容,并生成匹配的音频。VideoPoet的核心优势在于其多模态大模型的设计,无需特定数据集或扩散模型。
阅读全文
DiT – 基于Transfomer架构的扩散模型
DiT(Diffusion Transformers)是一种新型的扩散模型,由William Peebles(Sora的研发负责人之一) 与纽约大学助理教授谢赛宁提出,结合了去噪扩散概率模型(DDPMs)和Transformer架构。DiT的核心思想是使用Transformer作为扩散模型的骨干网络,而不是传统的卷积神经网络(如U-Net),以处理图像的潜在表示。近期伴随OpenAI视频生成模型Sora的大热,DiT被视为Sora背后的技术基础之一而广受关注。
阅读全文
Boximator – 字节推出的控制视频生成中对象运动的框架
Boximator是有字节跳动的研究团队开发的一种视频合成技术,旨在生成丰富且可控的运动,以增强视频合成的质量和控制性。该技术通过引入两种类型的约束框(硬框和软框)来实现对视频中对象位置、形状或运动路径的精细控制。
阅读全文
V-JEPA:Meta推出的视觉模型,可以通过观看视频来学习理解物理世界
V-JEPA是由Meta的研究人员推出的一种新型的视频自监督学习方法,它专注于通过特征预测来学习视频的视觉表示。这种方法的核心思想是让模型能够预测视频中一个区域(称为目标区域y)的特征表示,这个预测基于另一个区域(称为源区域x)的特征表示。
阅读全文
MetaGPT – 多个AI智能体协作分工的框架
MetaGPT是一个创新的元编程框架,结合了大语言模型和多智能体协作系统,旨在通过模拟人类工作流程来解决复杂问题。该框架的核心在于将标准化操作程序(SOPs)编码成提示序列,以便在多智能体系统中实现更高效的工作流程和减少错误。
阅读全文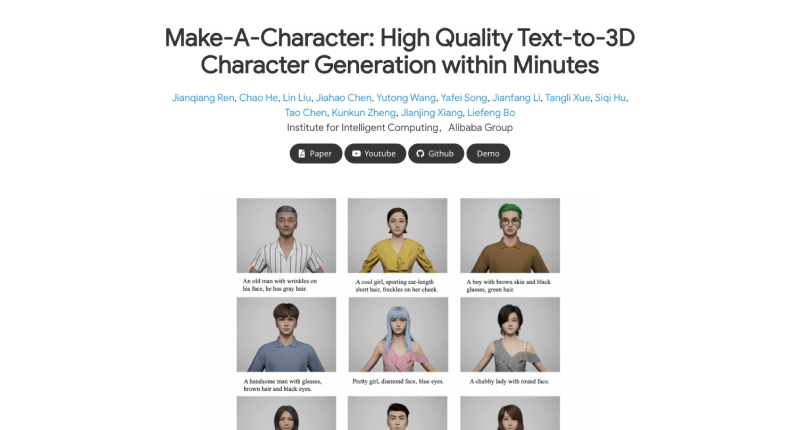
Make-A-Character:阿里开源的AI 3D数字人生成框架
Make-A-Character(简称Mach)是一个由阿里巴巴集团智能计算研究院开发的一个人工智能3D数字人生成框架,旨在通过文本描述快速创建逼真的3D角色。该系统特别适用于满足人工智能代理和元宇宙中对个性化和富有表现力的3D角色的需求。
阅读全文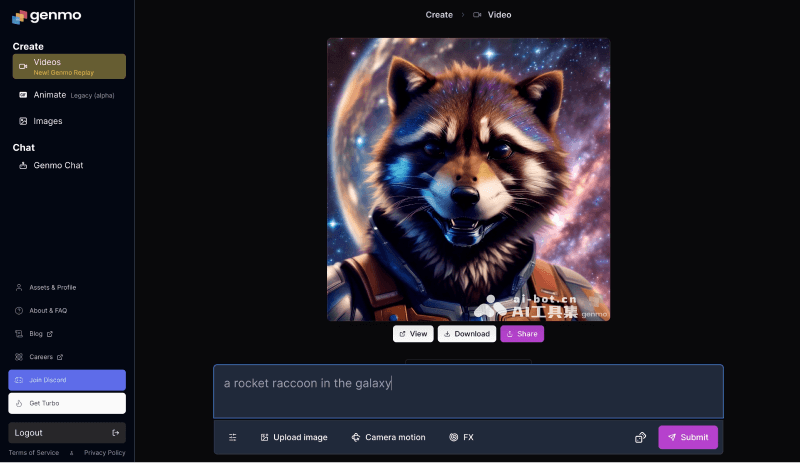
Genmo – AI生成视频、图片和动画的平台
Genmo是一个专注于人工智能的创意平台,用户可以在 Genmo 上创建视频、动画、图像等。该平台提供了一系列的工具和服务,旨在帮助用户通过AI技术轻松创作和分享各种形式的艺术和媒体内容,让内容创作更加便捷和高效,同时激发用户的想象力和创造力。
阅读全文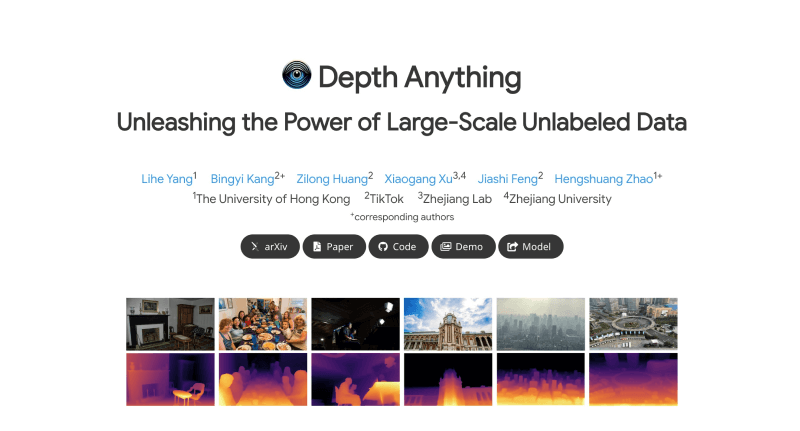
Depth Anything – Tiktok等推出的单目深度估计模型
Depth Anything是由来自Tiktok、香港大学和浙江大学的研究人员推出的一个为单目深度估计设计的深度学习模型,旨在处理各种情况下的图像并估计其深度信息。该模型的核心特点是利用大规模的未标注数据来增强模型的泛化能力,使其能够在没有人工标注深度信息的情况下,对各种场景的图像进行准确的深度预测。
阅读全文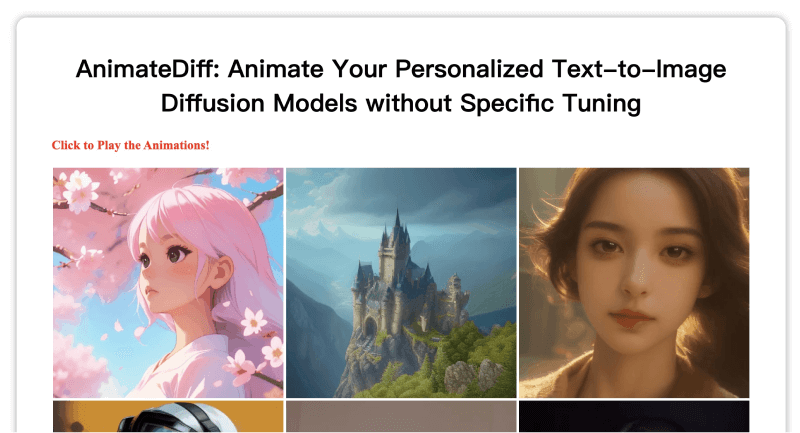
AnimateDiff – 扩展文生图模型生成动画的框架
AnimateDiff是由上海人工智能实验室、香港中文大学和斯坦福大学的研究人员推出的一款将个性化的文本到图像模型扩展为动画生成器的框架,其核心在于它能够利用从大规模视频数据集中学习到的运动先验知识,可以作为 Stable Diffusion 文生图模型的插件,允许用户将静态图像转换为动态动画。
阅读全文
MotionCtrl – 腾讯等推出的视频生成模型的运动控制器
MotionCtrl是由来自腾讯和香港大学等机构的研究人员推出的一个为视频生成模型设计的统一且灵活的运动控制器,能够独立地控制视频中的相机运动和物体运动视角。该系统由两个主要模块组成:相机运动控制模块和物体运动控制模块,可以与潜在视频扩散模型协同工作,以实现对生成视频中运动视角的精确控制。
阅读全文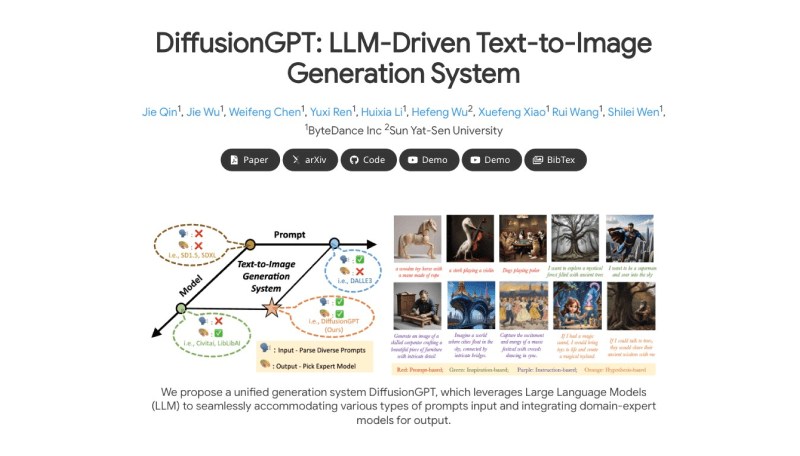
DiffusionGPT – 开源的大模型驱动的文本到图像生成系统
DiffusionGPT是由来自字节跳动与中山大学的研究人员推出的一个开源的大模型(LLM)驱动的文本到图像生成系统,旨在解决文生图领域无法处理不同的输入或者仅限于单一模型结果的挑战。该系统利用思维树和优势数据库的技术能够处理多种类型的文本提示,并将这些提示与领域专家模型相结合,以生成高质量的图像。
阅读全文