
AI文章
读懂模型与应用的新进展,找到值得尝试的 AI 实践。
7,595篇文章,持续更新
文章列表
ChatMLX – 高性能MacOS聊天应用,基于MLX框架实现与数据实时交互
ChatMLX是一个基于大型语言模型(LLM)的高性能MacOS聊天应用,基于MLX框架实现与数据的交互。应用通过自然语言处理技术,让用户与数据进行对话,支持文本文档、PDF文件和YouTube视频。ChatMLX支持多种语言,包括中文、英语、法语、德语、印地语、意大利语、日语、韩语、西班牙语、土耳其语和越南语,使全球用户方便使用。
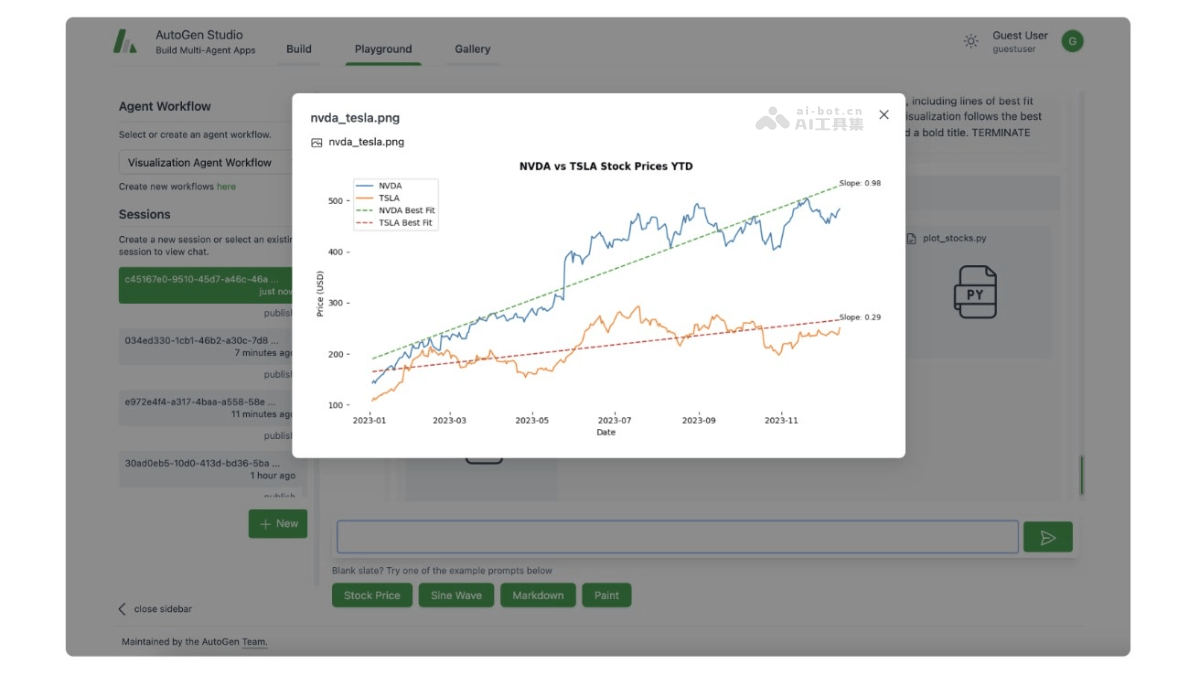
AutoGen Studio – 微软开源的零代码构建多智能体系统的AI工具
AutoGen Studio 是微软研究院推出的一款开源界面工具,旨在简化多智能体系统的构建、调试和评估过程。AutoGen Studio提供一个基于 Web 的交互式界面和 Python API,支持用户拖放和声明式规范定义智能体及工作流,无需编写代码。
Laminar – 分析与优化LLM应用程序的开源平台
Laminar是一个开源的可观测性和分析平台,专为大型语言模型(LLM)应用程序设计。Laminar提供一套完整的工具追踪、评估、注释和分析LLM数据,使开发者深入理解并优化应用程序。Laminar的核心功能包括自动追踪LLM调用和数据库交互,事件驱动的分析,直观的仪表板展示。
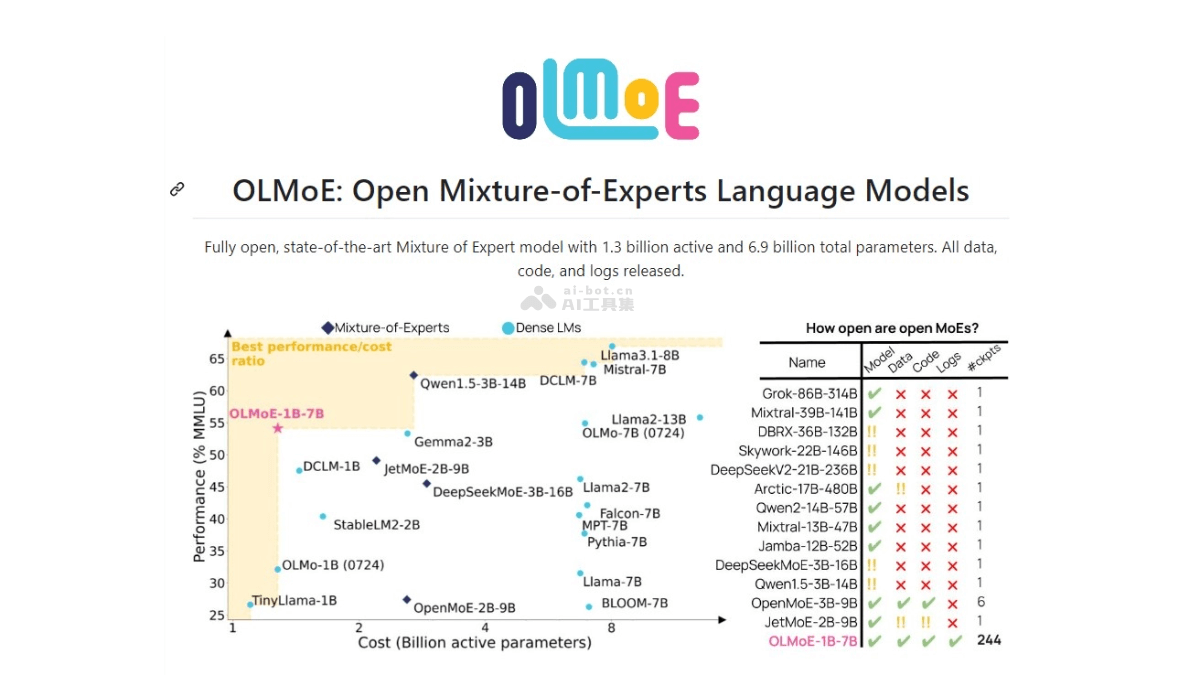
OLMoE – 完全开源的大语言模型,基于混合专家(MoE)架构
OLMoE(Open Mixture-of-Experts Language Models)是一个完全开源的大型语言模型,基于混合专家(MoE)架构。OLMoE基于5万亿个token进行预训练,拥有70亿总参数和10亿活跃参数。
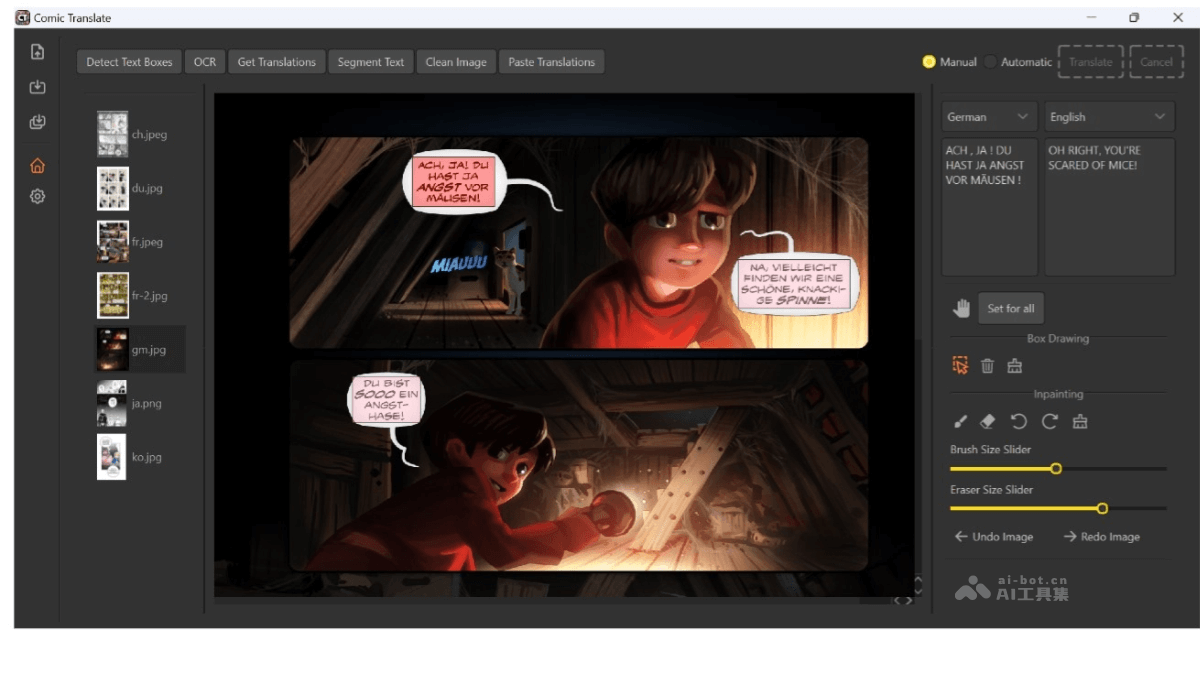
Comic Translate – 开源的漫画翻译工具,自动翻译主流漫画阅读语言
Comic Translate 是一个开源的漫画翻译工具,由开发者 ogkalu2 推出。帮助用户自动翻译全球各地的漫画,支持英语、韩语、日语、法语、简体中文、繁体中文、俄语、德语、荷兰语、西班牙语和意大利语等多种语言。
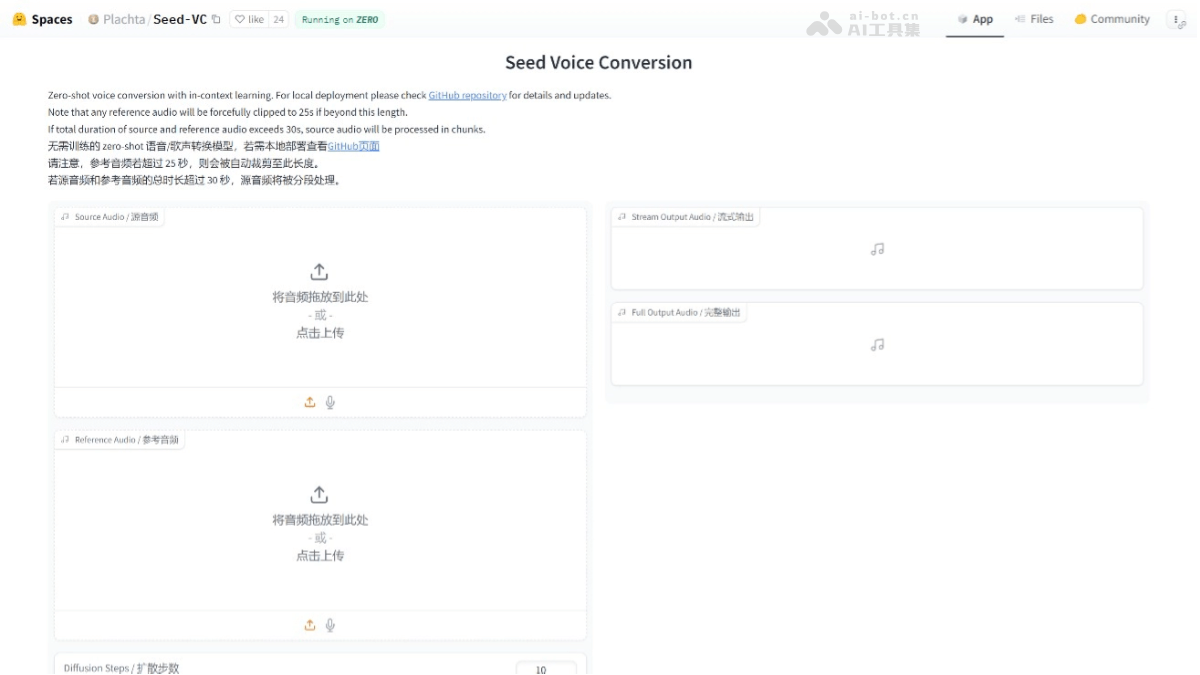
Seed-VC – 零样本实现声音克隆和转换的技术
Seed-VC 是一种零样本声音转换技术,基于上下文学习实现高质量的音频输出和音色相似度。用户无需进行特定训练,只需提供1到30秒的参考语音样本,实现声音的克隆和转换。
CDial-GPT – 清华推出的大型中文短文本对话数据集和对话生成模型
CDial-GPT是清华大学研究团队推出的大型中文短文本对话数据集LCCC及基于数据集的预训练对话生成模型。LCCC数据集经过严格的清洗流程,包含基础版(LCCC-base)和扩展版(LCCC-large),旨在提升对话模型的质量。
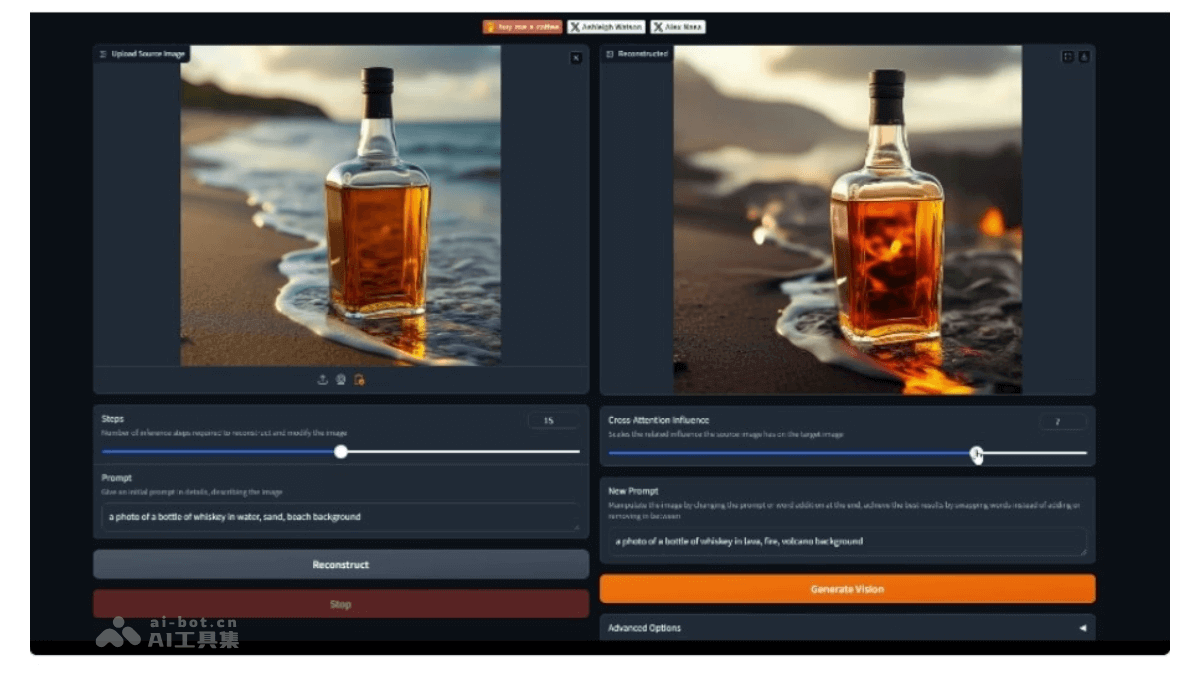
OutofFocus – 文本驱动图像生成或编辑的AI工具
OutofFocus是一个基于AI技术的图像编辑工具,基于Gradio平台为用户提供一个直观的界面操作和编辑图片。工具的核心功能是接受用户的文本提示,运用自然语言处理(NLP)技术理解提示,结合扩散逆过程重建技术修改图像。
PearAI – 开源的AI代码编辑器,基于VSCode开发直接与代码库对话
PearAI 是一个开源的 AI 驱动的代码编辑器,基于 Visual Studio Code (VSCode) 开发。PearAI 集成AI技术,减少编程工作量提高开发效率。PearAI 支持开发者直接与代码库对话,提出问题或生成代码,支持选择特定文件夹、在线文档、终端内容和文件等。
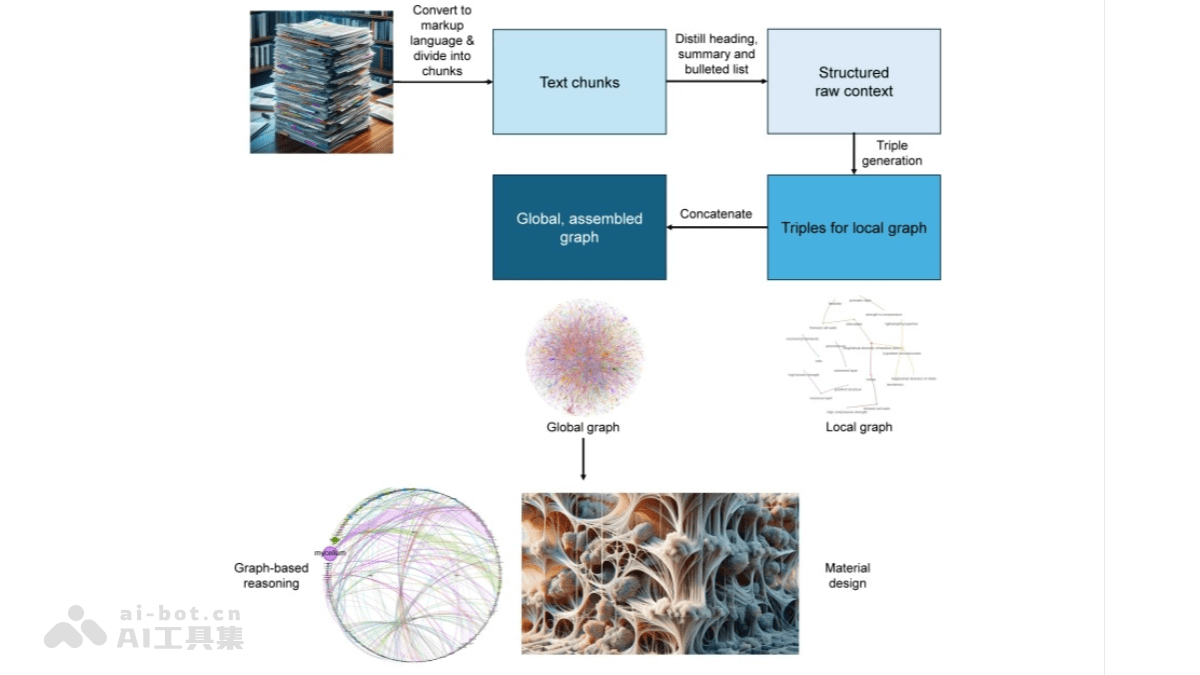
GraphReasoning – 将科学论文转换成知识图谱的AI应用框架
GraphReasoning是一种基于人工智能技术将大量科学论文转换成知识图谱的方法。通过结构化分析,计算节点度、识别社区及其连通性,评估关键节点的中心性,来揭示知识的架构。方法基于图的属性,如传递性和同构性,来发现跨学科的新颖联系,用于回答问题、识别知识空白、提出创新的材料设计和预测材料行为。
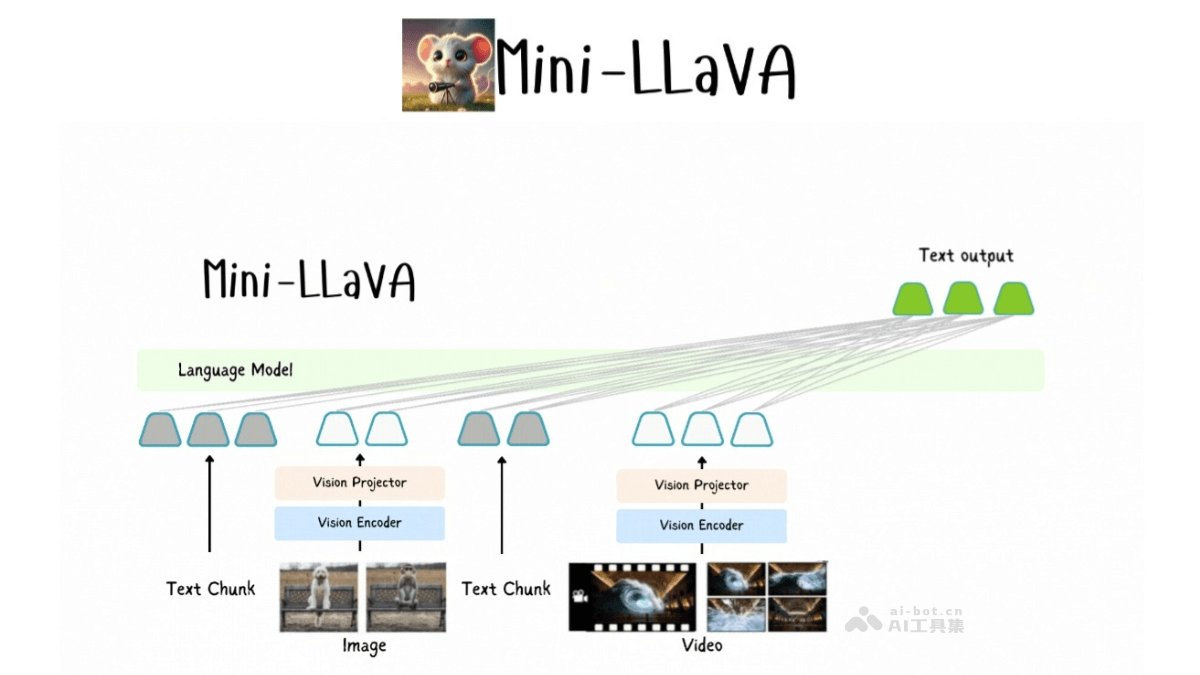
Mini-LLaVA – 基于Llama 3.1的轻量级多模态大语言模型
Mini-LLaVA是一款轻量级的多模态大语言模型,由清华大学和北京航空航天大学的研究团队联合开发。能处理图像、文本和视频输入,实现高效的多模态数据处理。Mini-LLaVA基于Llama 3.1模型,优化了代码结构,在单个GPU上即可运行,适合复杂的视觉-文本关联任务。
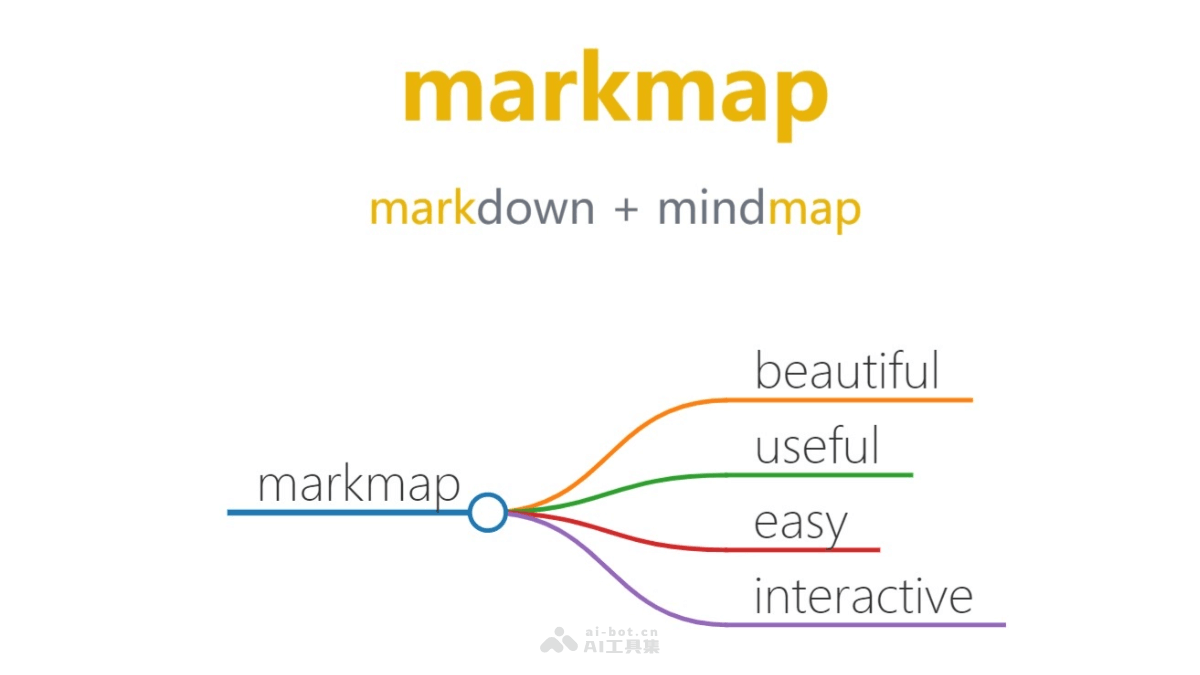
markmap – 解析Markdown生成可视化思维导图的工具
markmap 是一个将 Markdown 文本转换为思维导图的工具。基于 Markdown 的语法结构,实时生成可视化的思维导图,帮助用户直观的组织和展示信息。markmap 轻量且功能强大,支持与多种代码编辑器如 VS Code、Vim/Neovim、Emacs 集成,实现实时渲染和高度的可定制性。
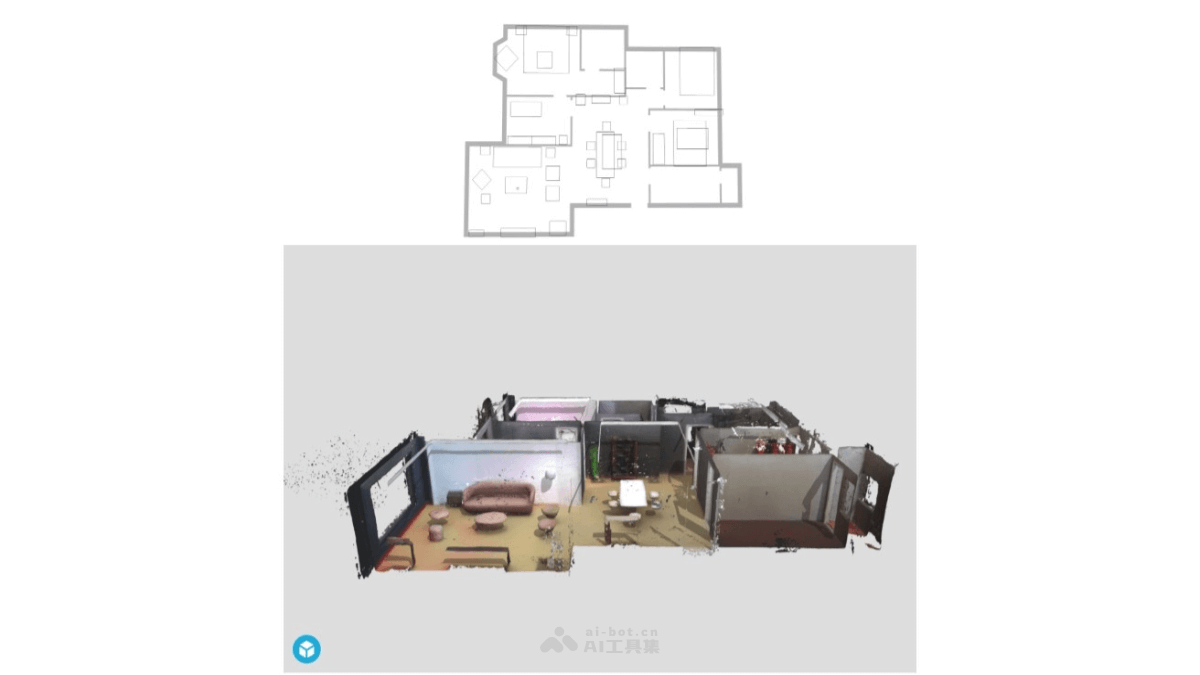
HouseCrafter – 东北大学和 Stability AI推出2D转换3D室内场景的技术
HouseCrafter 是由东北大学和 Stability AI 推出的先进技术,将二维平面图自动转换成三维室内场景。基于一个网络规模图像训练的2D扩散模型,生成一致的多视图彩色(RGB)和深度(D)图像。图像自回归地批量生成,确保全局一致性,重建出高质量的3D场景。
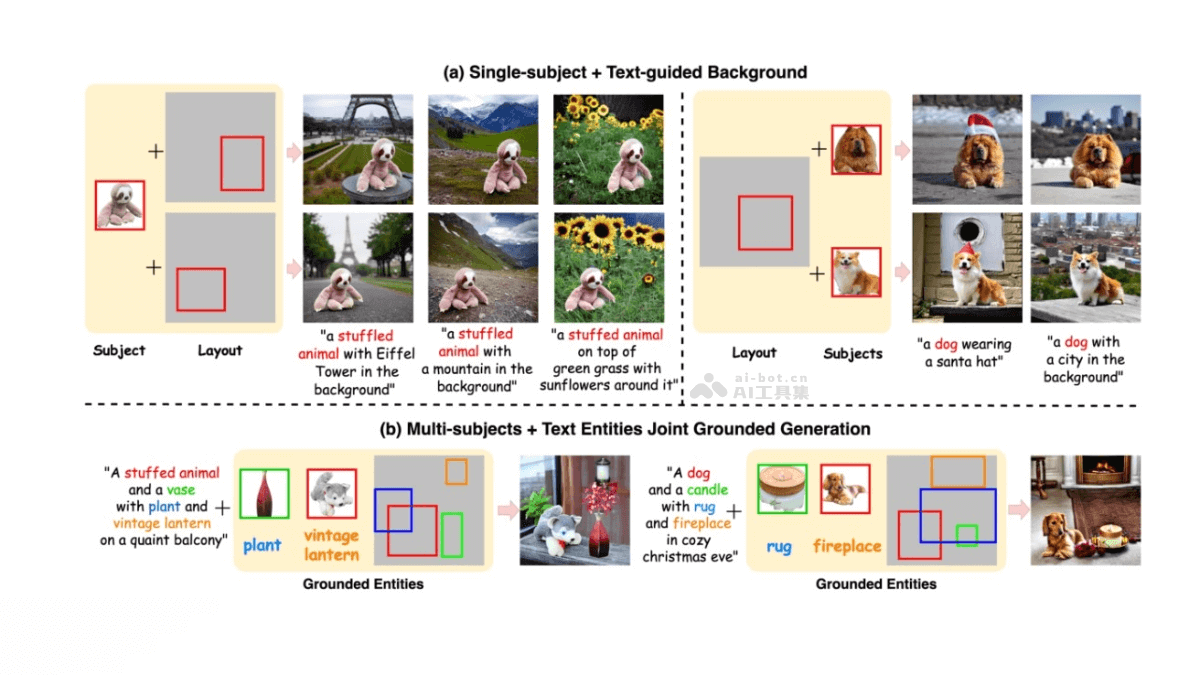
GroundingBooth – Adobe联合多所高校推出主题和文本到图像的定制框架
GroundingBooth 是一个先进的文本到图像定制框架,由华盛顿大学圣路易斯分校、Adobe和普渡大学的研究团队共同推出。基于文本-图像对齐模块和遮罩交叉注意力层,实现对前景主体和背景对象的精确空间对齐。
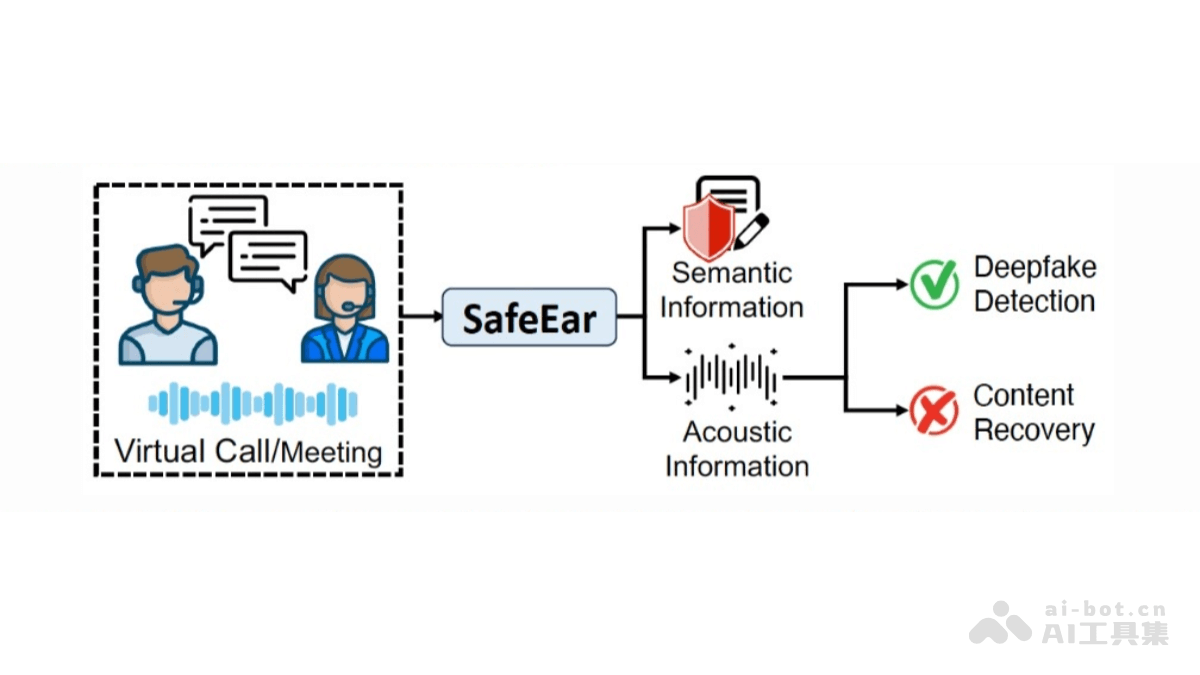
SafeEar – 浙大和清华联合开源的AI音频伪造检测框架
SafeEar是由浙江大学和清华大学联合开发的AI音频伪造检测框架,保护用户隐私的同时检测音频伪造。采用基于神经音频编解码器的解耦模型,分离语音的声学信息和语义信息,用声学信息进行检测,有效防止隐私泄露。
豆包向量化API – 字节跳动推出的语义向量化模型
豆包向量化API是由字节跳动研发的语义向量化模型,名为Doubao-embedding,主要面向向量检索的使用场景,支持中、英双语,能处理最长4K的上下文长度。
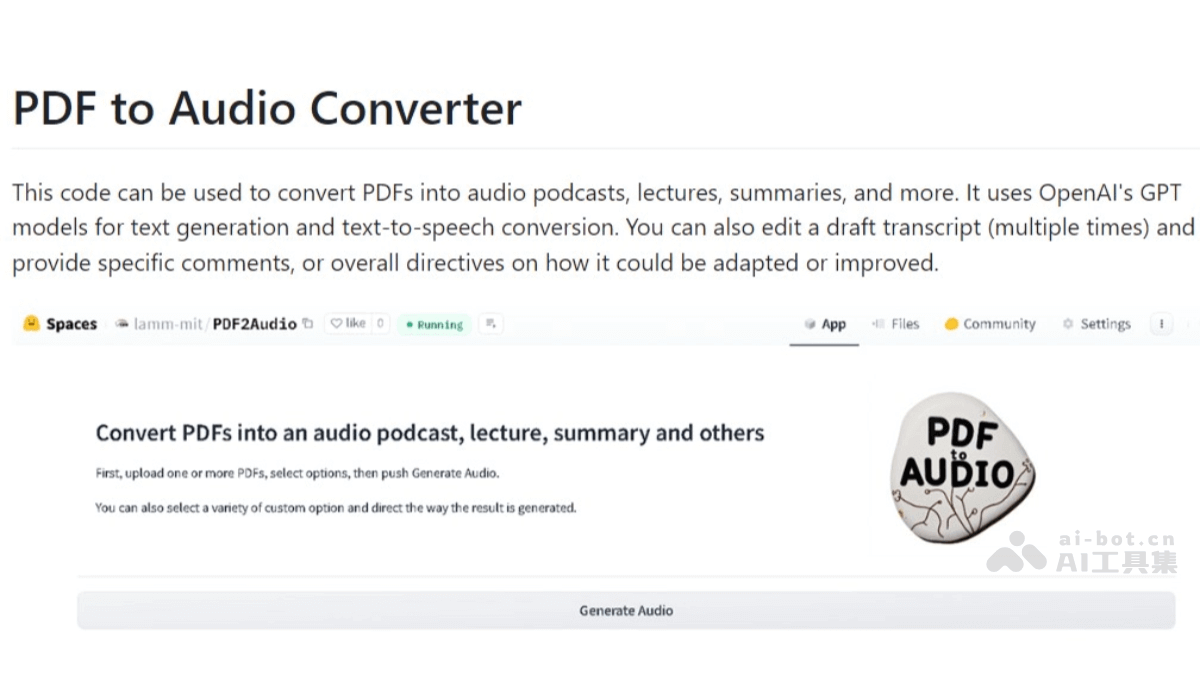
PDF2Audio – 将PDF文档转换成音频博客的开源工具
PDF2Audio 是一个开源工具,能将 PDF 文档转换成音频内容,适合制作播客、讲座或摘要。它基于 OpenAI 的 GPT 模型生成播客脚本,通过文本到语音技术转化为音频。
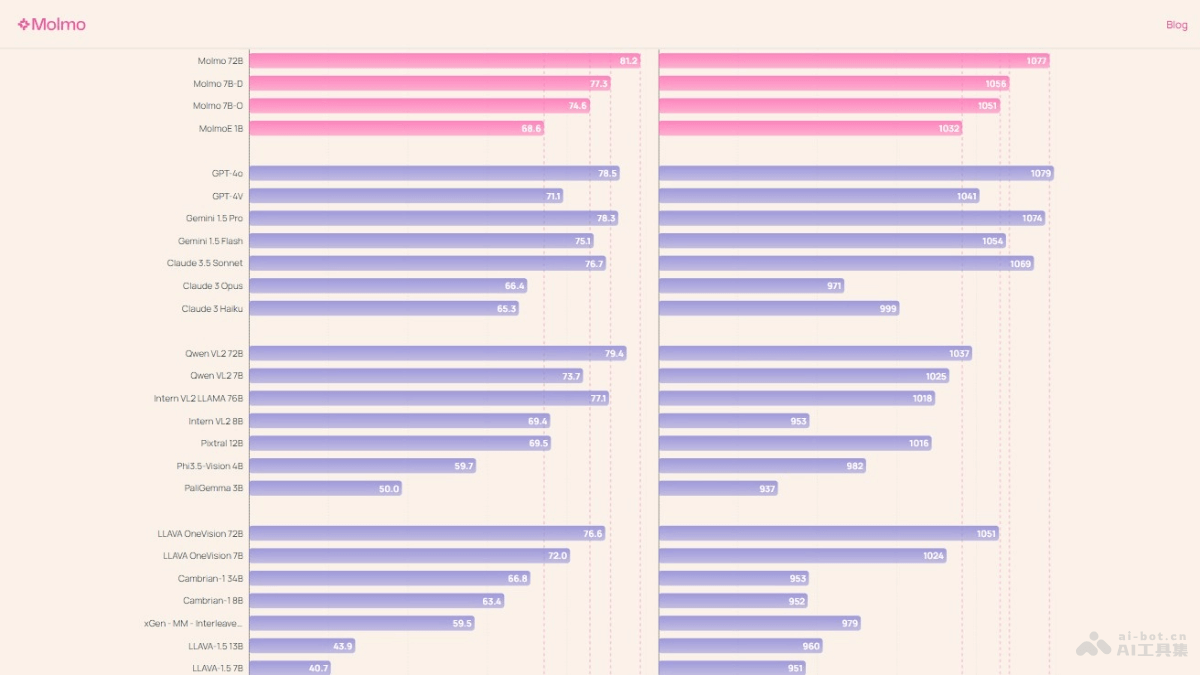
Molmo 72B – 开源的多模态AI模型,基于Qwen2-72B模型,超越Llama 3.2
Molmo 72B是由艾伦人工智能研究所(Ai2)推出的一个开源多模态AI模型,专门设计用于处理和理解图像和文本数据。基于Qwen2-72B模型,使用OpenAI的CLIP作为视觉编码器。Molmo 72B在多个学术基准测试中表现优异,击败包括Llama 3.2 90B在内的其他模型。