
AI文章
模型进展、开源项目和 AI 工具教程,读懂新东西能帮你做什么。
已收录 7,595 篇
文章列表,第 282 页
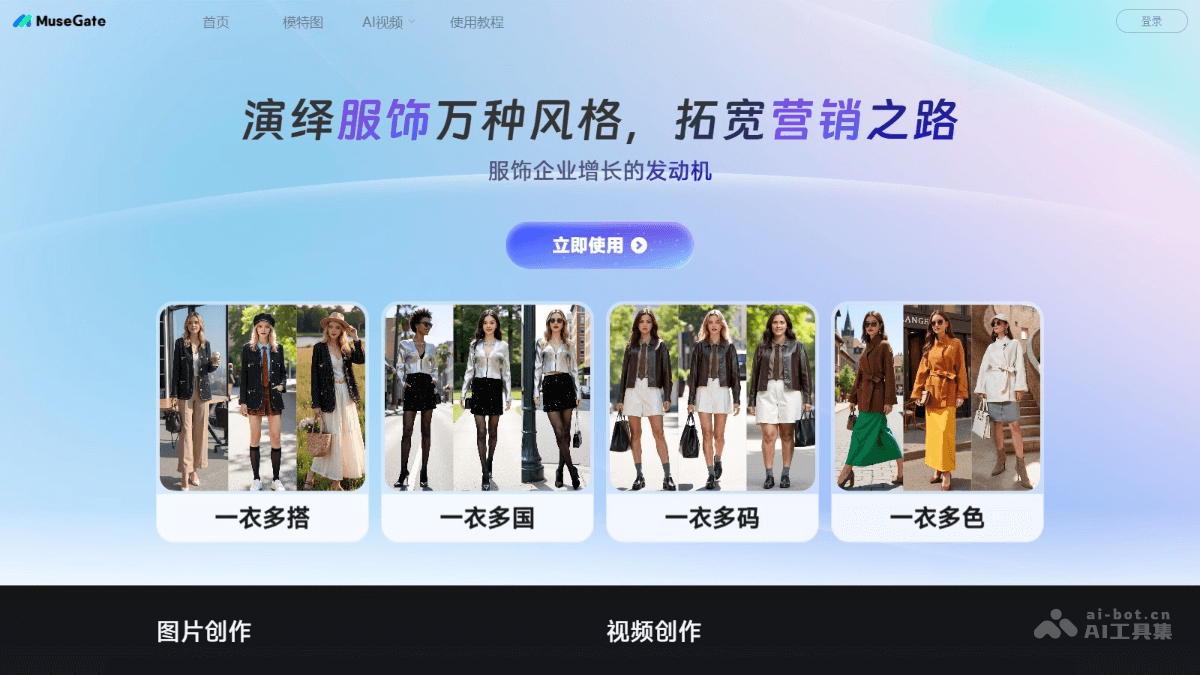
MuseGate – AI电商营销工具,支持模特和场景定制
MuseGate是杭州霖润智能科技推出的AI电商营销工具,专门服务于服饰企业。MuseGate基于生成式AI技术,能深度定制模特和场景,实现快速的服装搭配和尺寸变换,提供模特定制、场景定制、节点营销等服务。
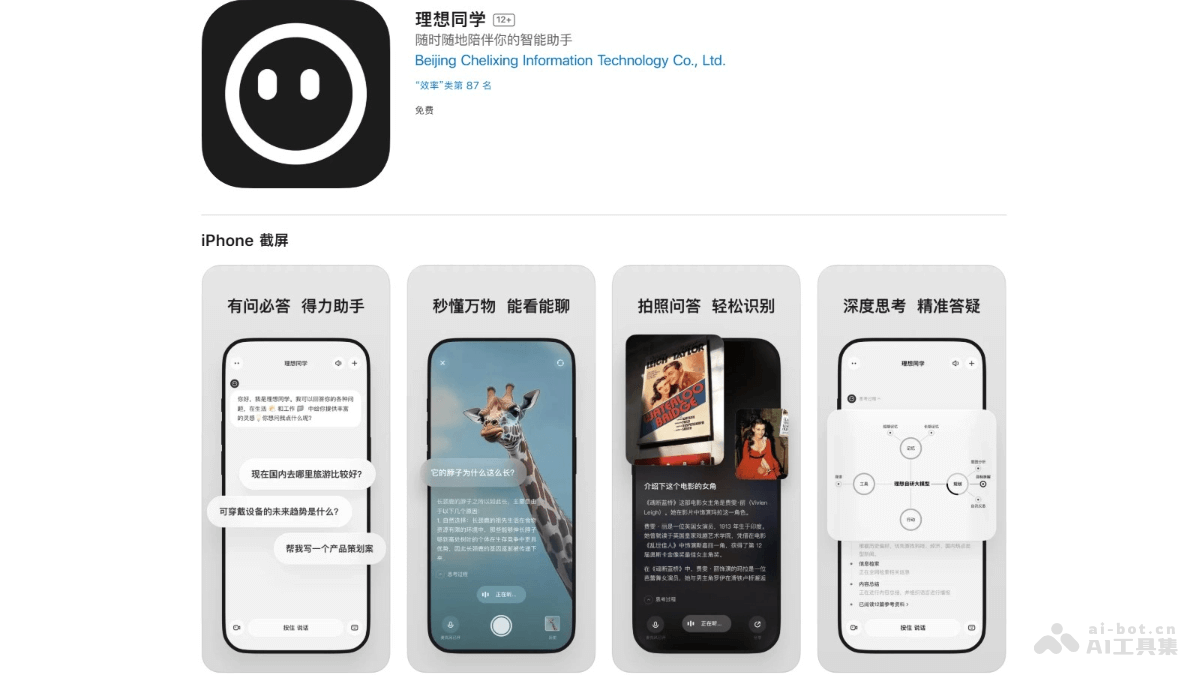
理想同学 – 理想汽车推出的 AI 智能助手
理想同学是理想汽车推出的AI智能助手,依托自研大模型开发,全面接入 DeepSeek R1和 MindGPT双模型。理想同学具备强大的知识问答能力,涵盖汽车、科技、财经等多个领域,进行英文翻译和文本生成。理想同学视觉感知功能帮助用户识别汽车、动植物等。
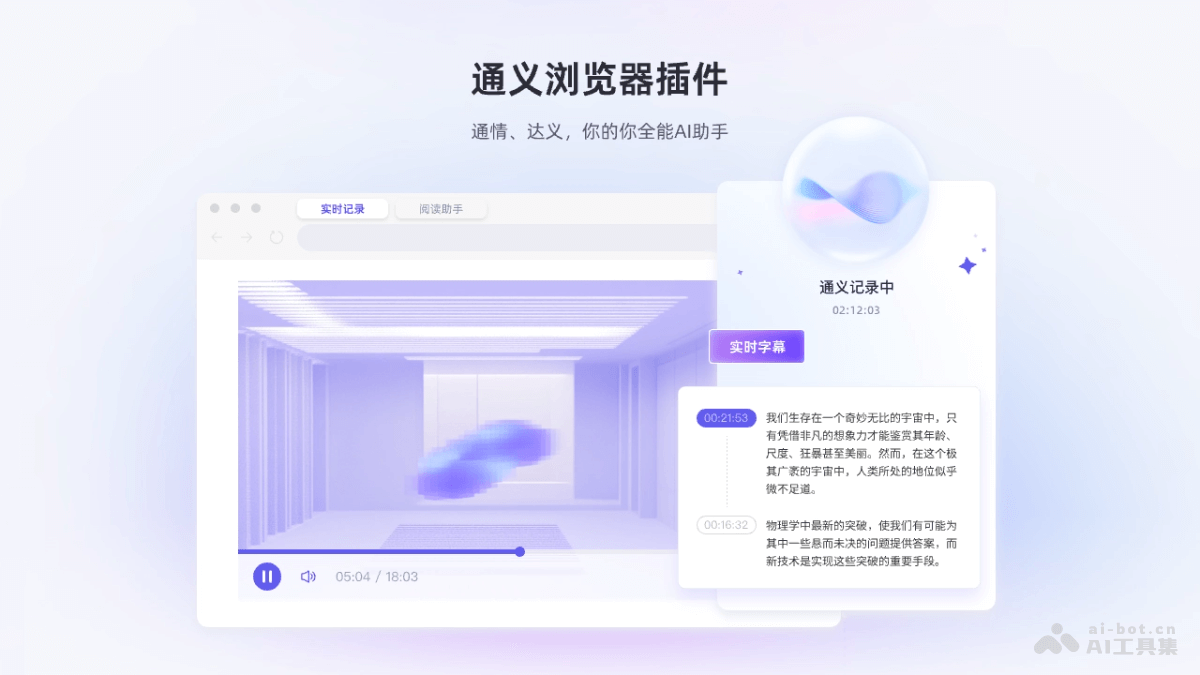
通义浏览器插件 – 阿里通义推出的全能办公和学习 AI 助手
通义浏览器插件是全能AI助手,提供实时语音识别、AI字幕翻译、智能总结等功能。适用于网课、追剧、线上会议等场景,帮助用户记录、翻译和总结信息。用户基于插件快速启动“实时记录”和“阅读助手”,轻松管理在线内容。
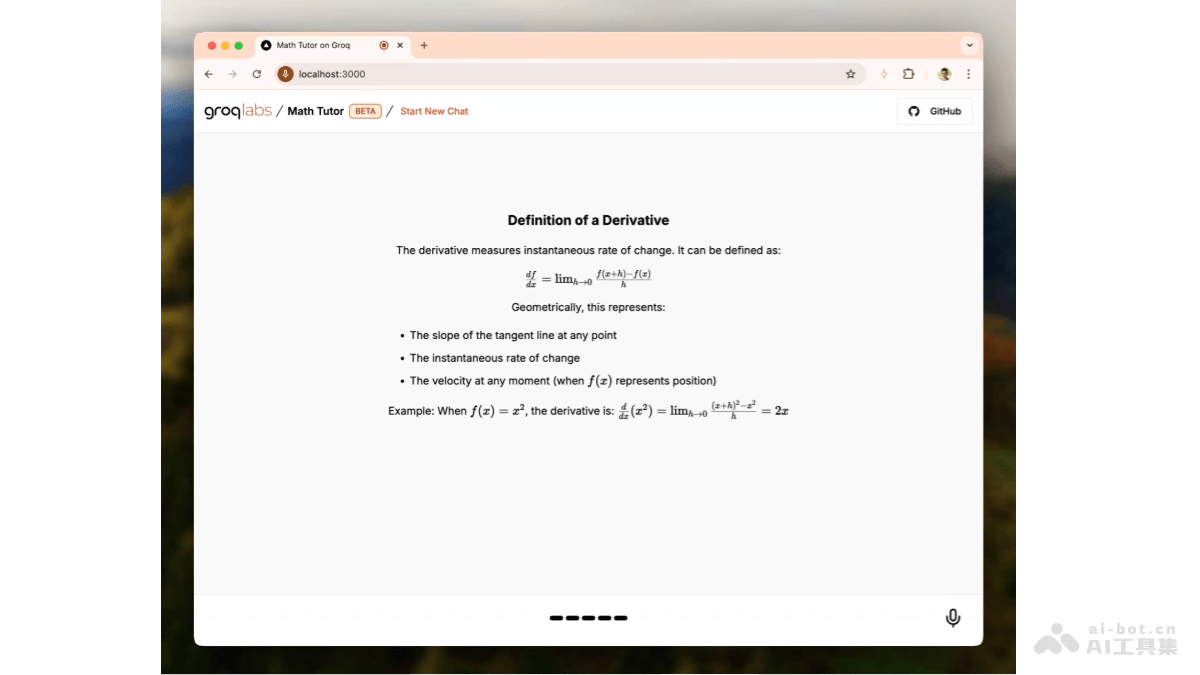
Mathtutor on Groq – AI数学辅导工具,支持用语音形式提出数学问题
Mathtutor on Groq 是基于 Groq 架构的AI数学辅导工具,基于语音识别功能,支持用户用语音形式提出数学问题。工具内置强大的数学引擎,能实时计算并用 LaTeX 格式渲染出详细的解题过程和答案,极大地提升学习效率和交互性。
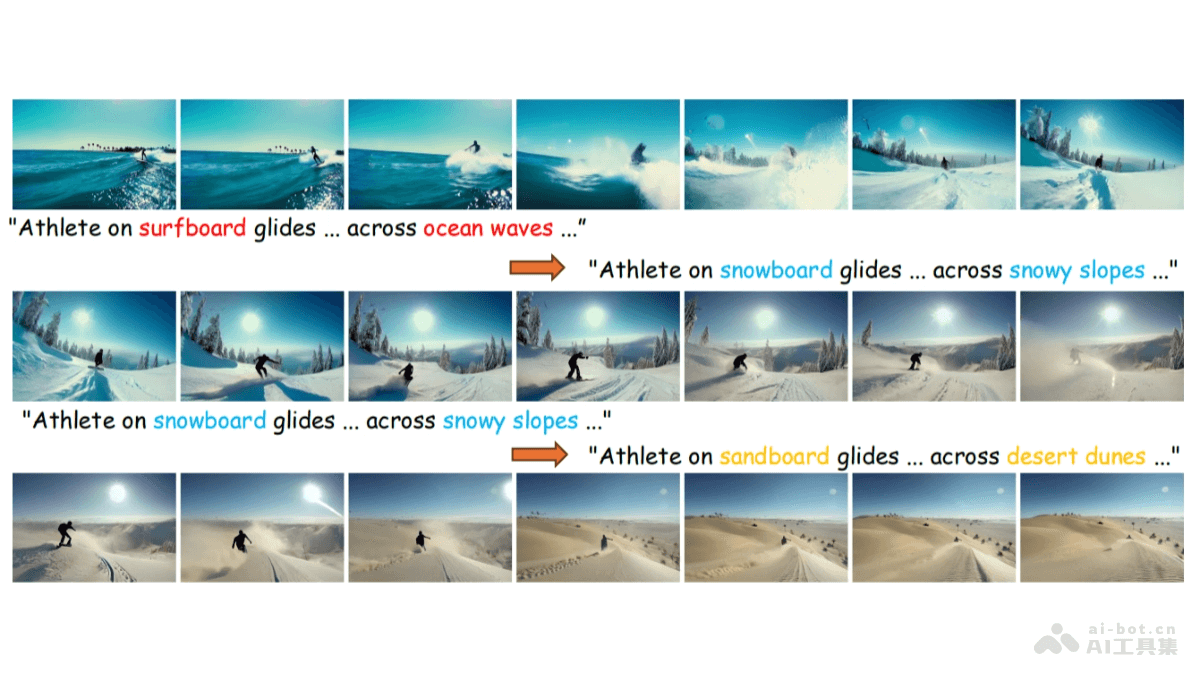
DiTCtrl – 港中文联合腾讯等机构推出的多提示视频生成方法
DiTCtrl是基于多模态扩散变换器(MM-DiT)架构的多提示视频生成方法,是香港中文大学和腾讯等机构联合推出的。DiTCtrl能在无需额外训练的情况下,实现多个文本提示之间的连贯视频生成,并保持内容和运动的一致性。
ZMO.AI – AI图像处理平台,支持文字描述或上传图片生成和编辑图像
Zmo.ai是集成多种功能的AI图像生成和编辑平台,支持用户用简单的文字描述或上传图片生成和编辑图像,无需任何美术与设计基础。平台提供AI照片生成器、AI动漫生成器、AI照片编辑器、AI背景更换器、AI视频生成器等多种工具,服务于电商宣传、营销产品、海报设计等领域。
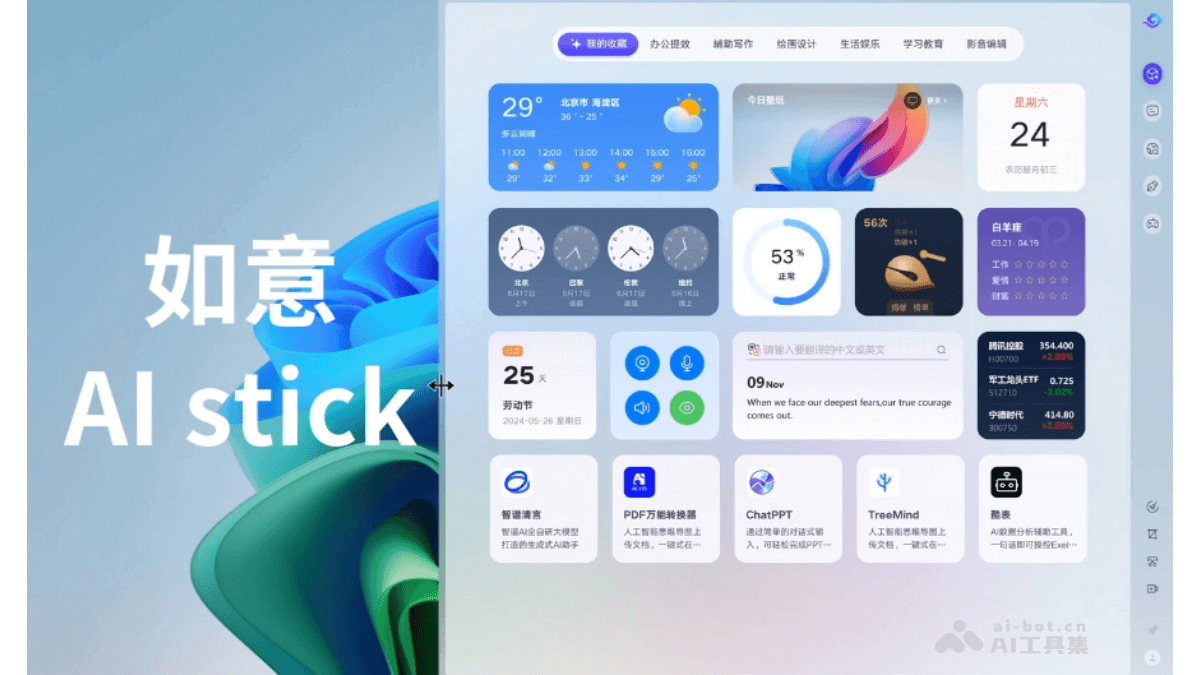
如意 AI Stick – 联想集团推出的 AI 桌面助手
AI Stick是联想集团推出的AI桌面助手“如意”,集成人工智能技术,AI Stick可以连接到多种设备上,如电脑、手机等。AI Stick搭载了豆包大模型,提供了AI搜索、AI写作和AI聊天等功能,用户可以直接在聊天界面获取知识解答,无需在多个应用间切换。
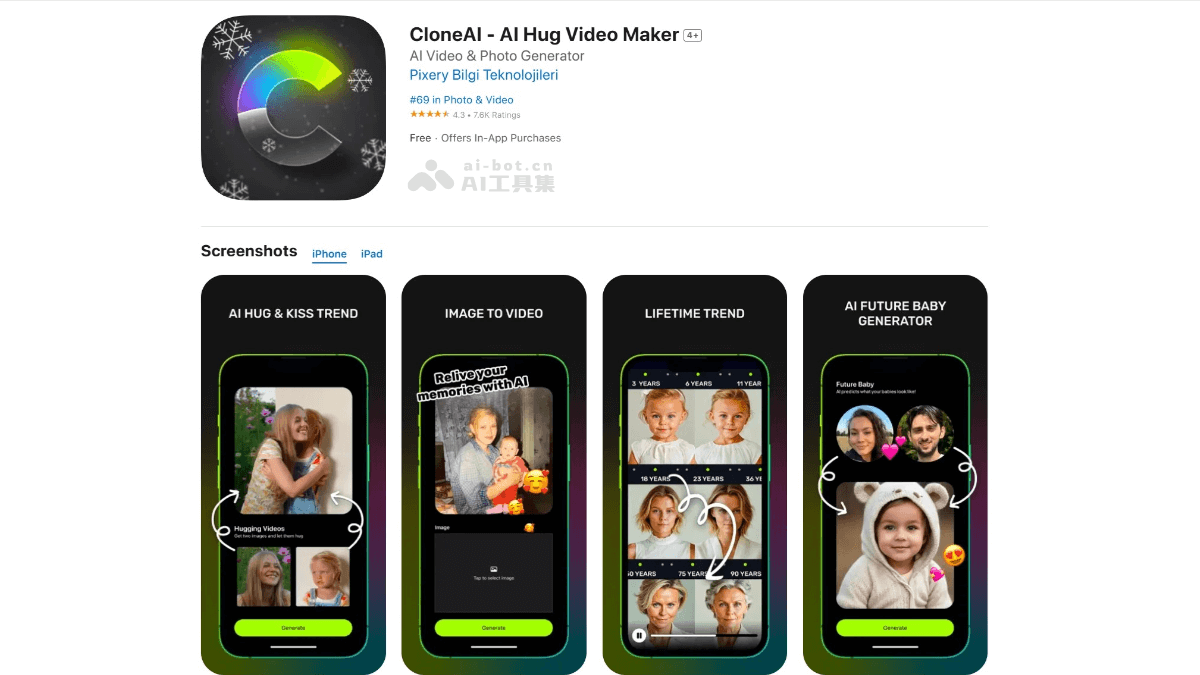
CloneAI – AI视频生成器,将普通视频创作成拥抱、老化、挤压效果等个性作品
CloneAI是AI视频生成器,基于人工智能技术将普通视频转换成具有艺术感和视觉冲击力的作品。用户可以上传视频,选择不同的AI风格效果,应用到视频中,快速生成具有独特视觉效果的内容。适合社交媒体内容创作者,制作出引人注目的视频,增加观众的参与度。
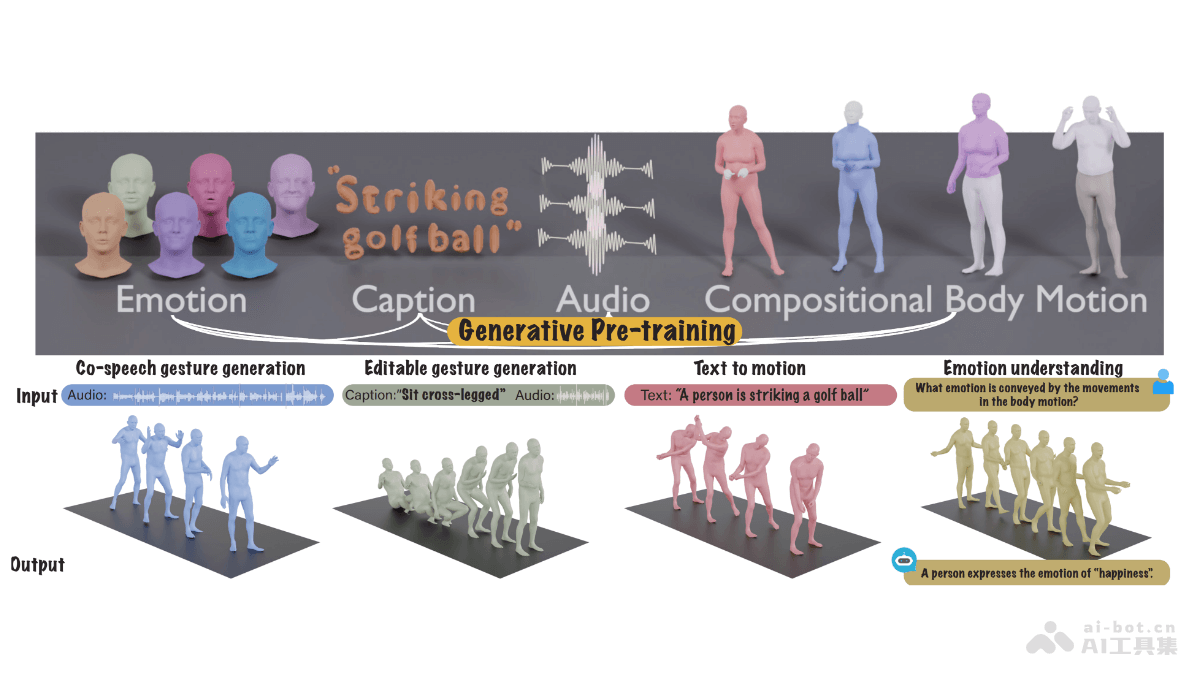
The Language of Motion – 斯坦福李飞飞团队推出的统一多模态语言模型
The Language of Motion是斯坦福大学李飞飞团队推出的多模态语言模型,能整合人类动作中的言语和非言语语言。模型能处理文本、语音和动作数据,生成对应的目标模态,对于创建自然交流的虚拟角色至关重要。
什么是上下文窗口(Context Window) – AI百科知识
上下文窗口指的是在自然语言处理(NLP)任务中,模型在处理一个特定输入时所考虑的上下文信息的范围。具体来说,它决定了模型在生成或理解文本时,可以同时看到和利用多少个词或字符的信息。
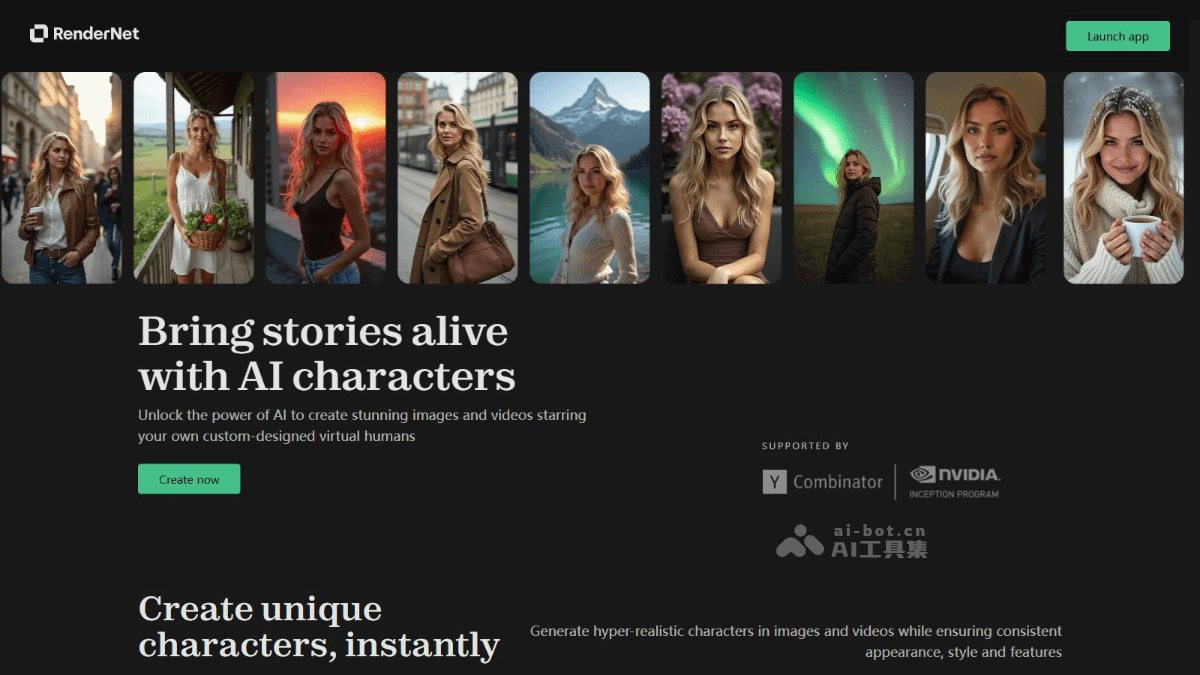
RenderNet – AI图像生成平台,支持面部锁定姿势控制确保角色一致性
RenderNet是创新的生成式 AI 平台,基于AI技术生成图像和视频。RenderNet提供一系列高级功能,包括FaceLock、ControlNet等技术,支持多模型生成,确保角色设计的一致性和高度定制化。用户能轻松创建AI角色,通过上传面部照片、用角色构建向导进行定制,并保存角色。
什么是奖励模型(Reward Model) – AI百科知识
奖励模型是强化学习中的一个核心概念,用于评估智能体在特定状态下的行为表现。在大型语言模型(LLMs)中,奖励模型通过对输入的问题和答案进行评分,指导模型生成更符合人类期望和安全标准的输出。
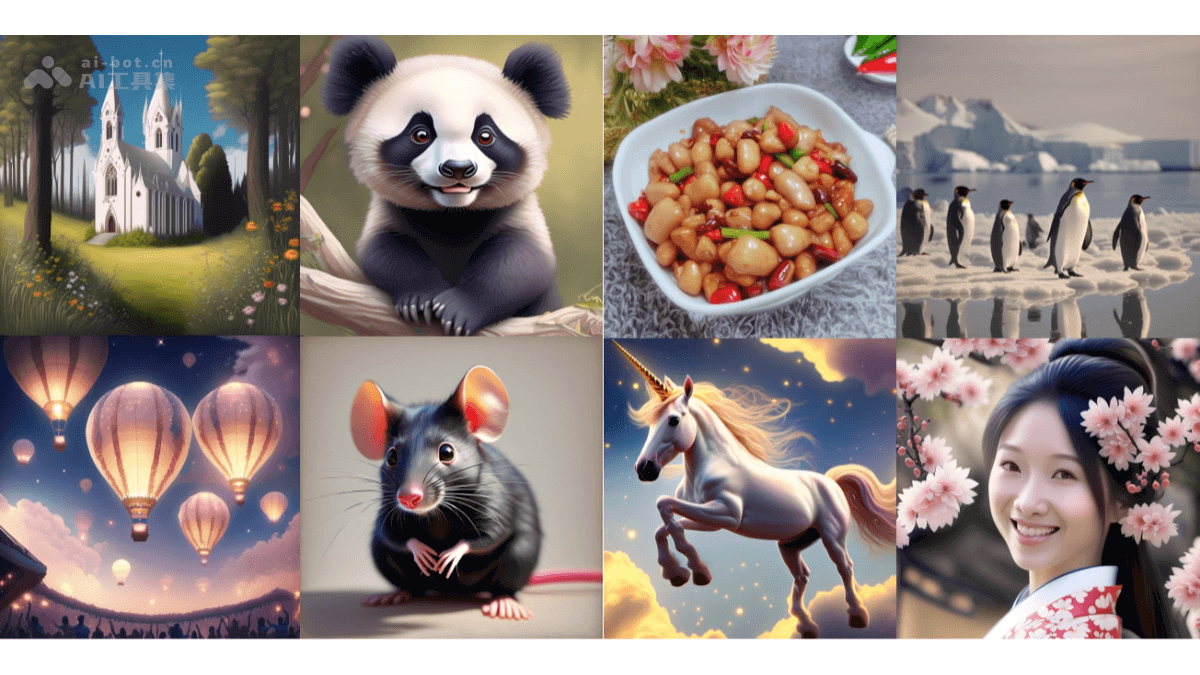
联通元景 – 中国联通AI开源的中文原生文生图模型
联通元景(UniT2IXL)是中国联通AI推出的中文原生文生图模型,完全在国产昇腾AI基础软硬件平台上实现训练和推理。模型采用复合语言编码模块,优化中文长文本和特色词汇理解,提升图像生成质量。
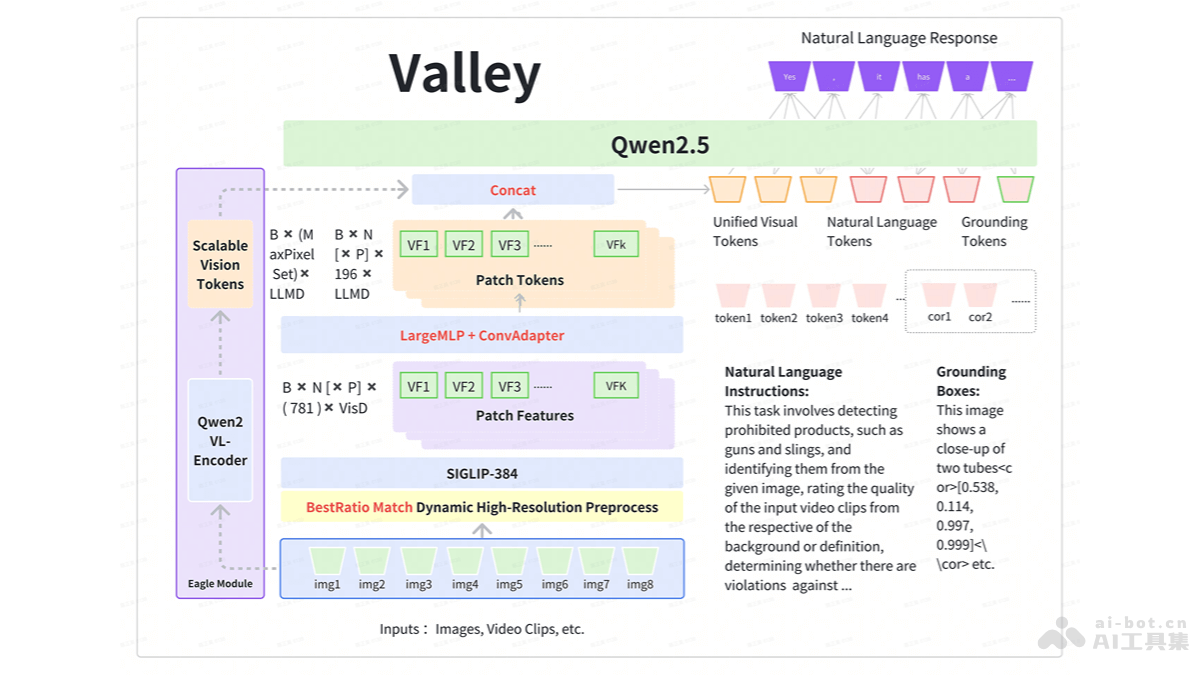
Valley – 字节跳动推出的多模态大模型
Valley是字节跳动推出的多模态大模型,用于处理涉及文本、图像和视频数据的多样化任务。Valley在内部电子商务和短视频基准测试中取得了最佳成绩,并在OpenCompass测试中展现出色性能,尤其是在小于10B参数规模的模型中排名第二。
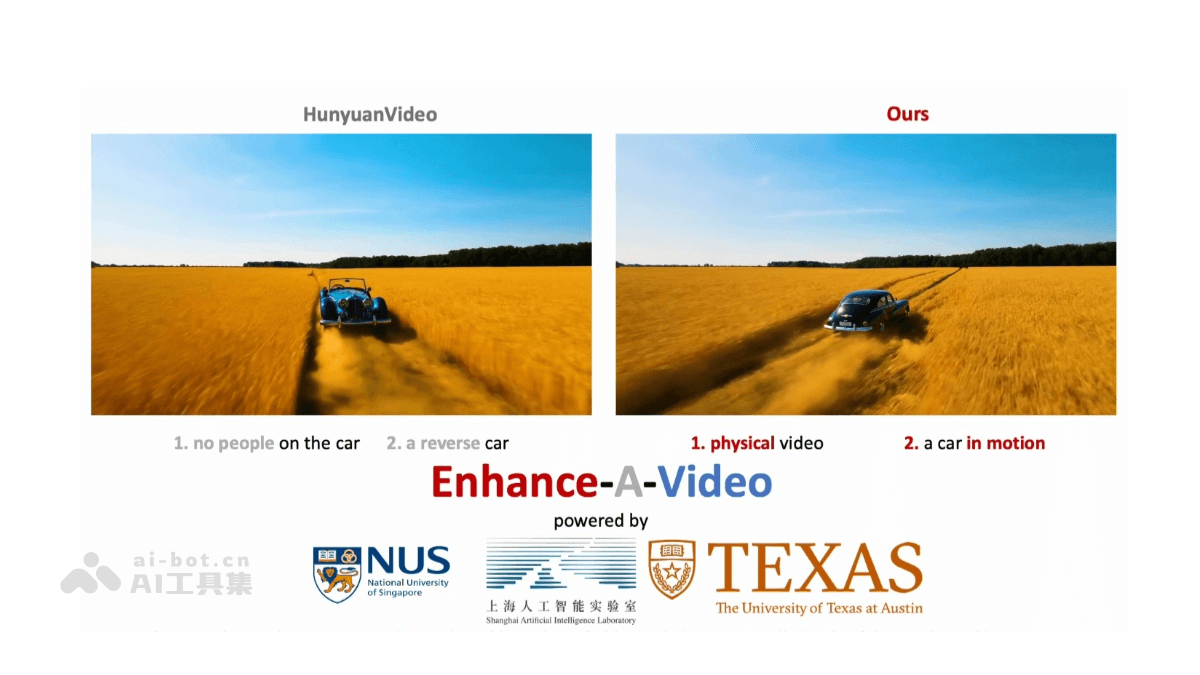
Enhance-A-Video – 上海AI Lab 联合新加坡国立等推出的视频生成质量增强算法
Enhance-A-Video 是新加坡国立大学、上海人工智能实验室和德克萨斯大学奥斯汀分校联合推出的视频生成增强算法。算法能够显著提升AI视频的生成质量,特别是在对比度、清晰度以及细节真实性上有显著改进。
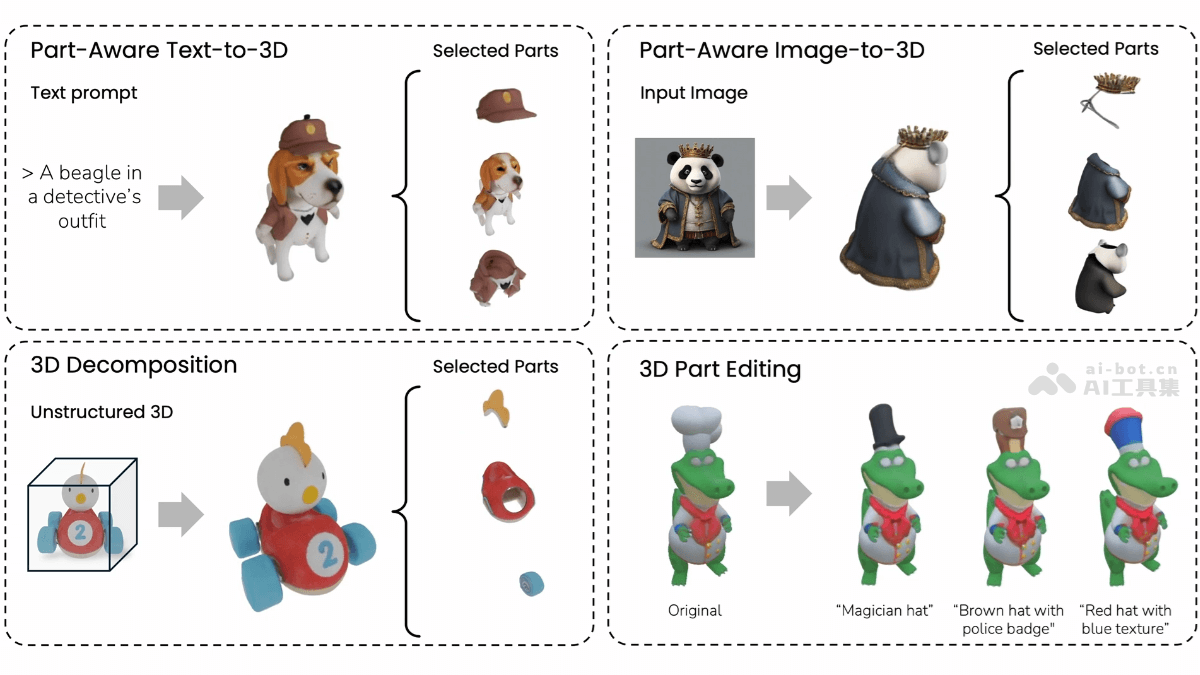
PartGen – 牛津大学联合 Meta AI 推出的3D对象生成和重建框架
PartGen是先进的3D对象生成和重建框架,是牛津大学的视觉几何小组和Meta AI共同推出的。PartGen能识别并生成由有意义部分组成的3D对象,3D对象能基于文本提示、图像或现有的3D模型生成。PartGen用多视图扩散模型自动提取和重建3D对象的各个部分,同时考虑上下文确保组件之间的正确配合。
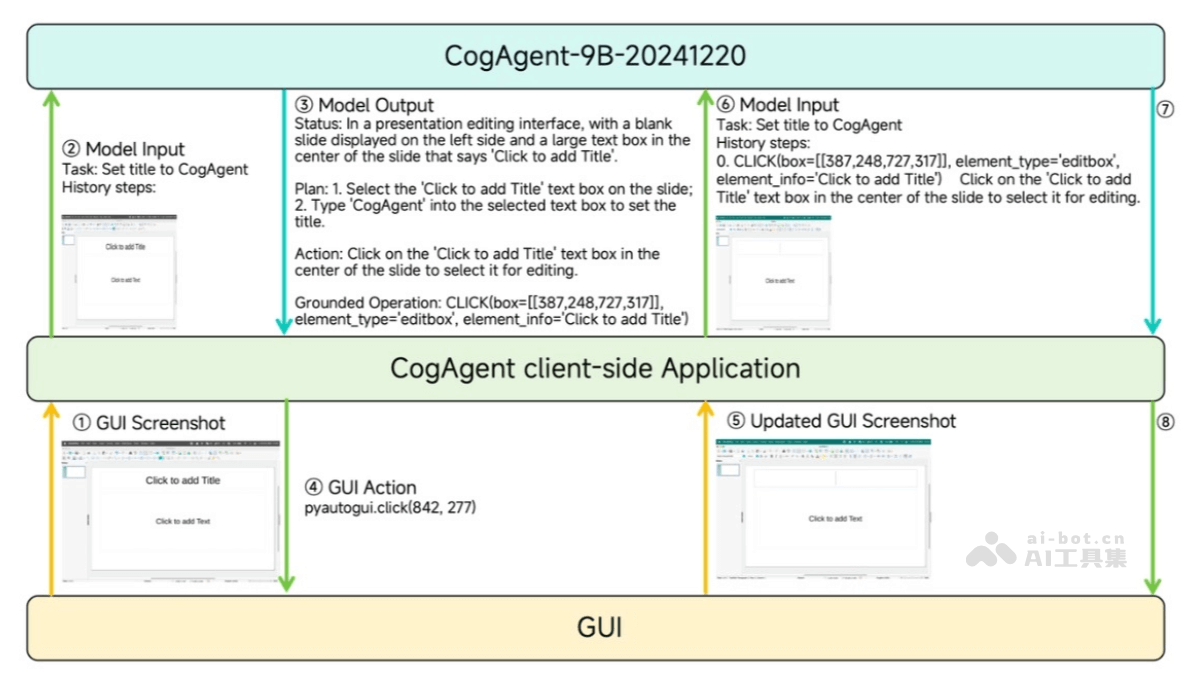
CogAgent-9B – 智谱AI开源 GLM-PC 的基座模型
CogAgent-9B是基于 GLM-4V-9B 训练的专用Agent任务模型,仅依赖屏幕截图作为输入,无需HTML等文本表征。CogAgent-9B支持高分辨率图像处理,具备双语(中英文)交互能力,能预测并执行GUI操作,实现自动化任务。
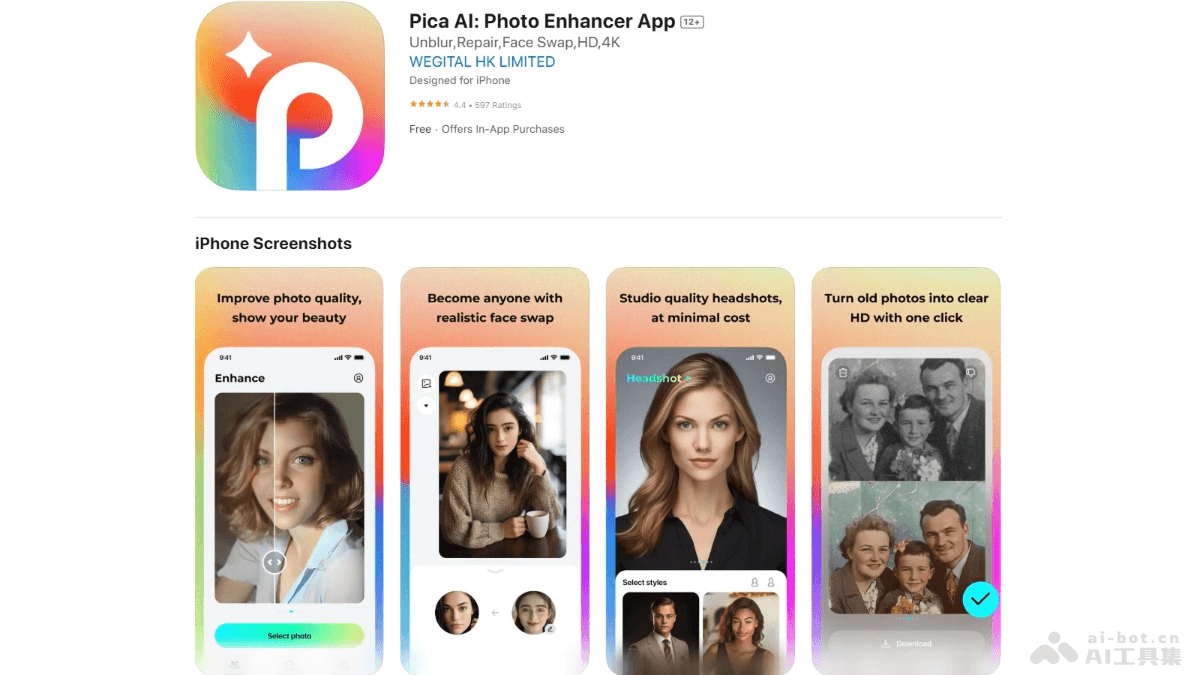
Pica AI – AI照片编辑应用,提升照片质量、制作创意视频和实现面部互换
Pica AI是AI照片编辑应用,专注于图像和视频处理。它提供AI头像生成、照片增强、视频编辑和面部交换等功能,让用户轻松创建专业头像、提升照片质量、制作创意视频和实现面部互换。Pica AI以简洁的用户界面和强大的AI技术,服务于职场人士、摄影师和内容创作者,满足对图像和视频编辑的多样化需求。