
AI文章
模型进展、开源项目和 AI 工具教程,读懂新东西能帮你做什么。
已收录 7,595 篇
文章列表,第 276 页
什么是元学习(Meta-Learning) – AI百科知识
元学习(Meta-Learning),也称为“学会学习”,是机器学习领域中一个令人兴奋且极具潜力的研究方向。它的核心目标是让机器学习系统学会高效地学习新任务,解决传统模型对大量标注数据的需求和训练时间过长的问题。
Shakker – 在线 AI 图像生成和模型分享平台
Shakker 是AI图像生成平台,提供高质量的Stable Diffusion模型,能直接线上局部修改图片、合成图片、去除背景、延展、摆出指定动作,帮助创作者轻松实现创意。核心功能是AI图像生成和编辑,支持从零创建图像、修改风格和组合元素。
FUSION BRAIN – AI绘画工具,通过文本描述生成多风格图像
FUSION BRAIN是AI驱动的图像生成平台,基于Kandinsky神经网络将文本描述转换成视觉内容。用户用简单的文本提示快速生成图像,编辑和设计自己的视觉作品,支持多种风格和格式。
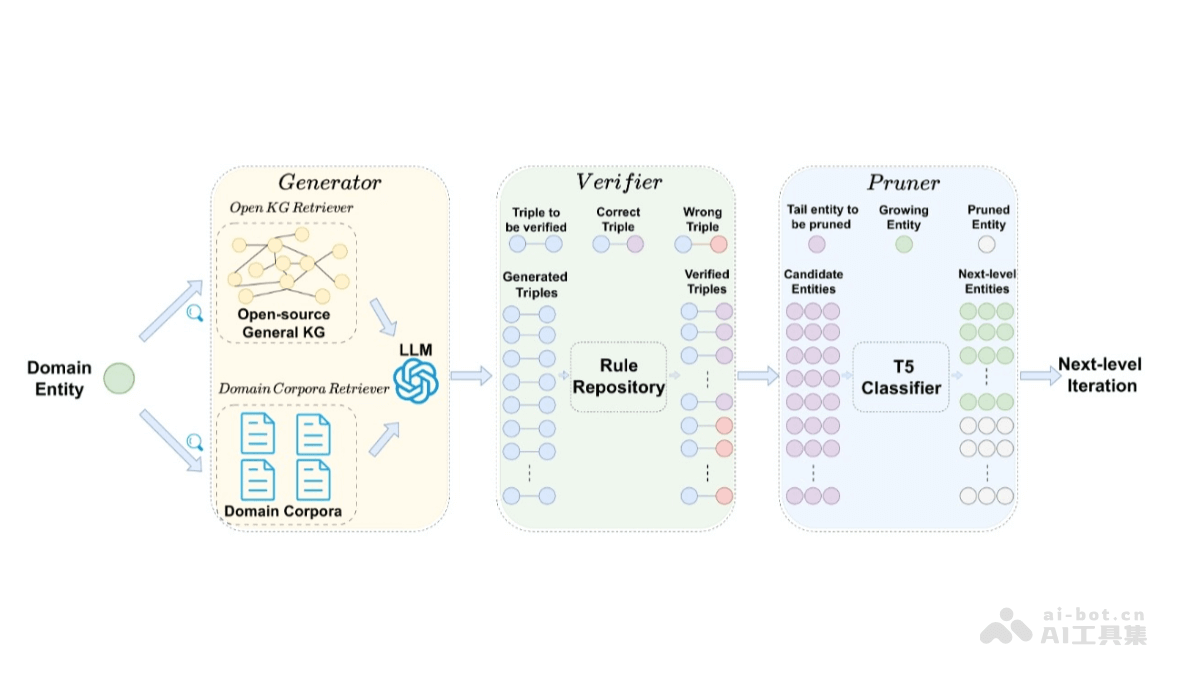
SAC-KG – 通用知识图谱构建框架,能构建超百万节点的领域知识图谱
SAC-KG是基于大型语言模型(LLMs)自动构建领域知识图谱的通用框架。由生成器、验证器和剪枝器三个主要组件构成,能自动从原始领域语料库中生成特定领域的一级知识图谱,确保生成的三元组的准确性。
GeoSpy – AI照片地理定位平台,分析照片中的视觉线索确定拍摄地点
GeoSpy是AI平台,专注于照片地理定位。基于分析照片中的视觉线索,如地标、植被和基础设施,将其与全球数据库匹配,确定照片的精确拍摄地点。GeoSpy适用于研究人员、执法人员和普通用户,帮助他们了解照片背后的故事,进行OSINT调查,或解决犯罪问题。
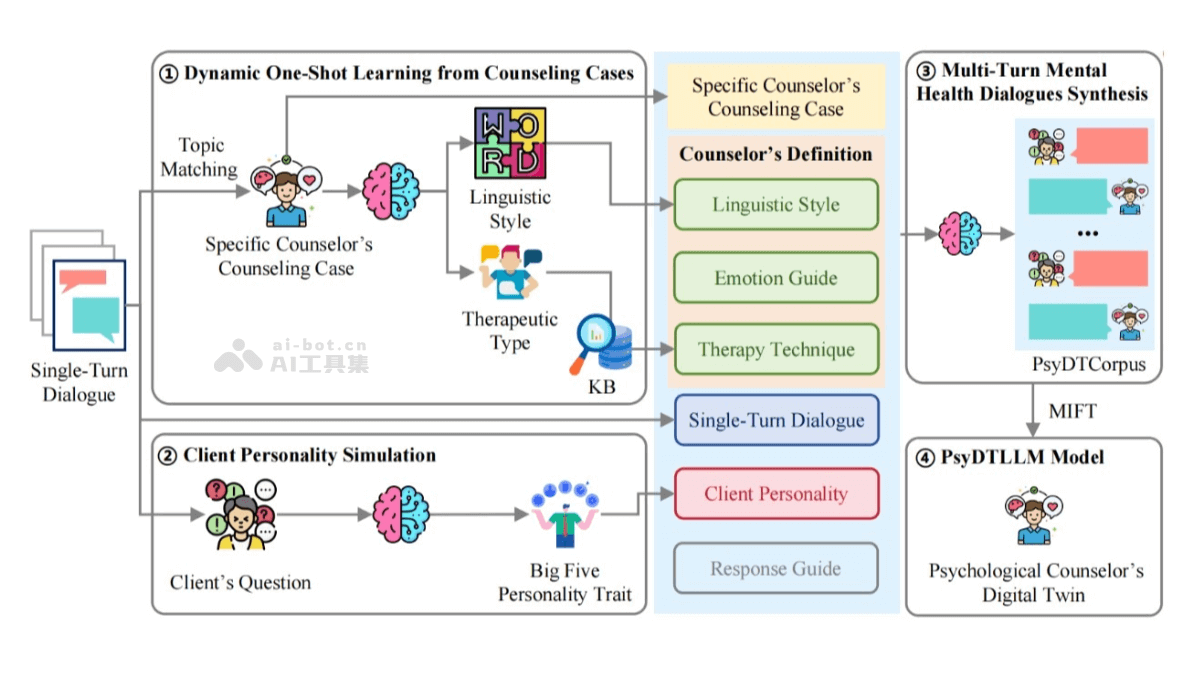
SoulChat2.0 – 华南理工大学推出的心理咨询师数字孪生大语言模型
SoulChat2.0是华南理工大学未来技术学院-广东省数字孪生人重点实验室基于SoulChat1.0模型推出的心理咨询师数字孪生大语言模型。首次定义了特定心理咨询师的数字孪生任务,旨在通过模拟真实心理咨询师的语言风格和疗法技术,提升大模型在真实心理咨询场景中的应用性能。
SWAPP – AI建筑设计工具,自动建模生成完整的施工文件
SWAPP是AI驱动的自动化工具,专为建筑行业设计,能减少文档和建模任务的繁琐工作,确保文档的一致性和准确性。SWAPP基于自动化尺寸标注、标记和注释,提高工作效率,同时支持与主流BIM软件如Revit的集成。
aftershoot – AI照片筛选和编辑软件,快速分析识别最佳照片
aftershoot是专为摄影师设计的AI照片筛选和编辑软件,基于AI技术快速分析和挑选最佳照片,同时自动处理裁剪、校正、曝光等编辑任务。aftershoot支持导入RAW和JPEG格式,能直接导出到Lightroom等软件,提供个人AI编辑档案模仿用户风格。
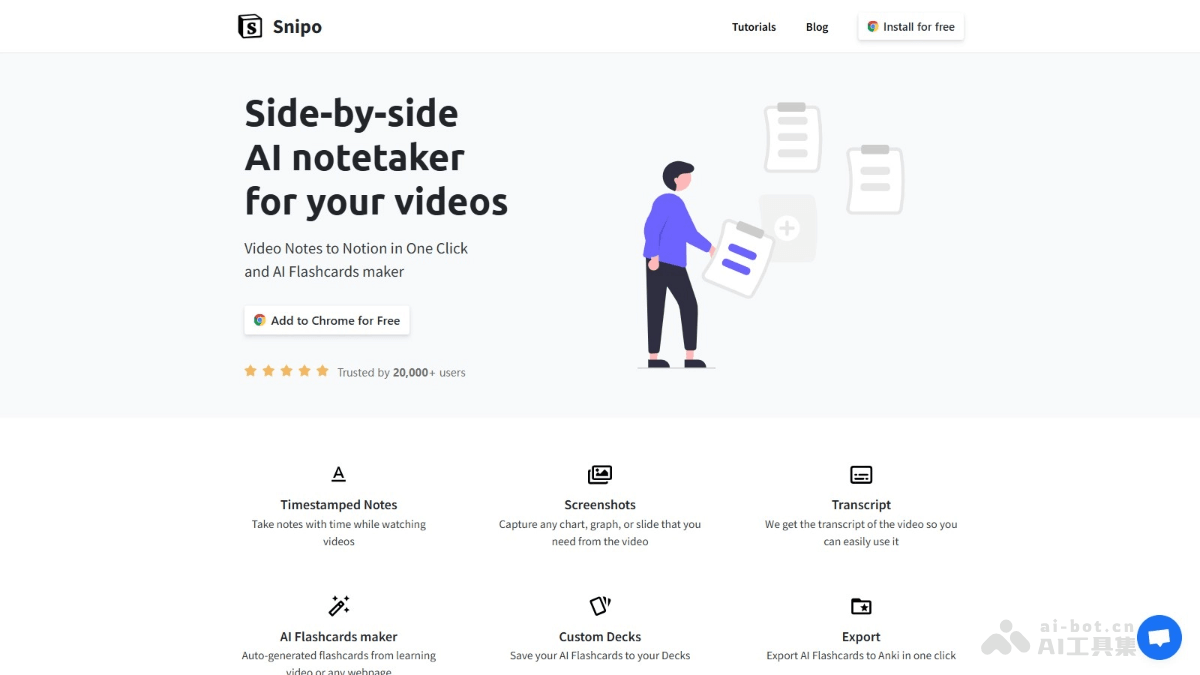
Snipo – AI视频笔记工具,自动从视频内容生成AI闪卡一键同步到Notion
Snipo是一个浏览器扩展工具,专为视频学习和笔记管理设计。用户在观看视频时能添加时间戳笔记、截图关键图像,自动从视频内容生成AI闪卡。笔记和闪卡能一键同步到Notion,便于知识管理和复习。Snipo支持YouTube等平台。
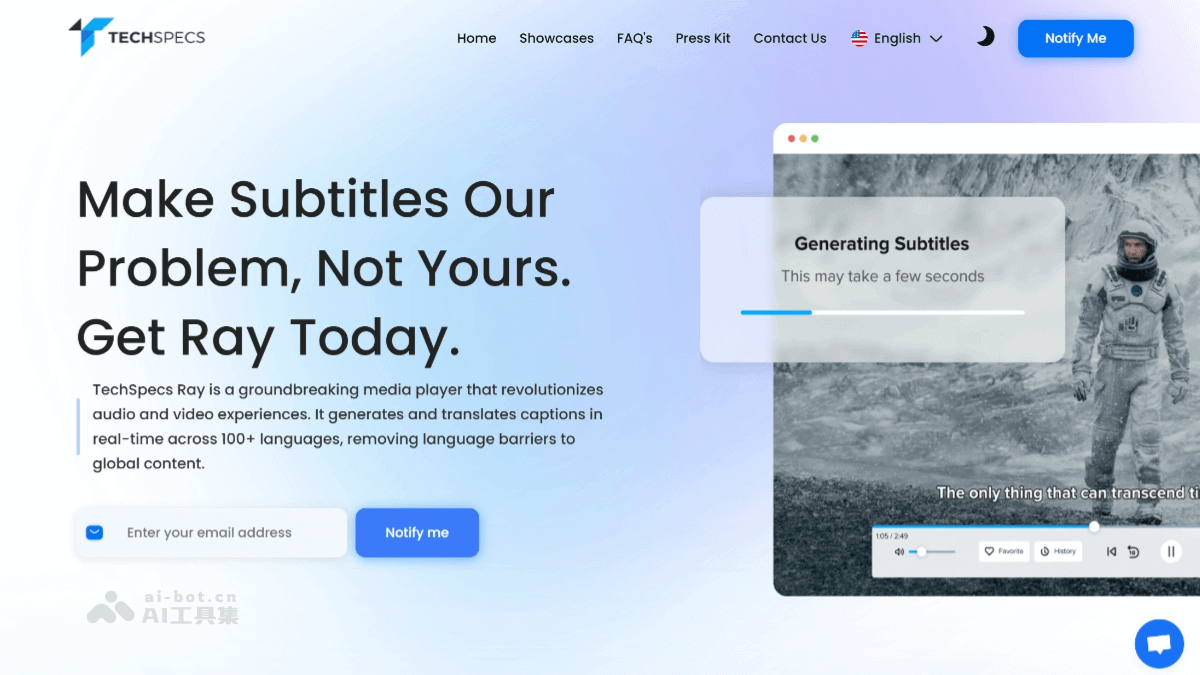
TECHSPECS – AI媒体播放器,实时AI字幕、支持99种语言字幕生成
TECHSPECS(TechSpecs Ray)是创新的AI驱动媒体播放器,通过实时AI字幕技术革新您的视听体验。支持99种语言的字幕生成,打破了语言障碍,让全球用户都能享受视频和音频内容。TechSpecs Ray能播放各种格式的媒体文件,提供智能媒体搜索和组织功能,使得内容易于查找和管理。
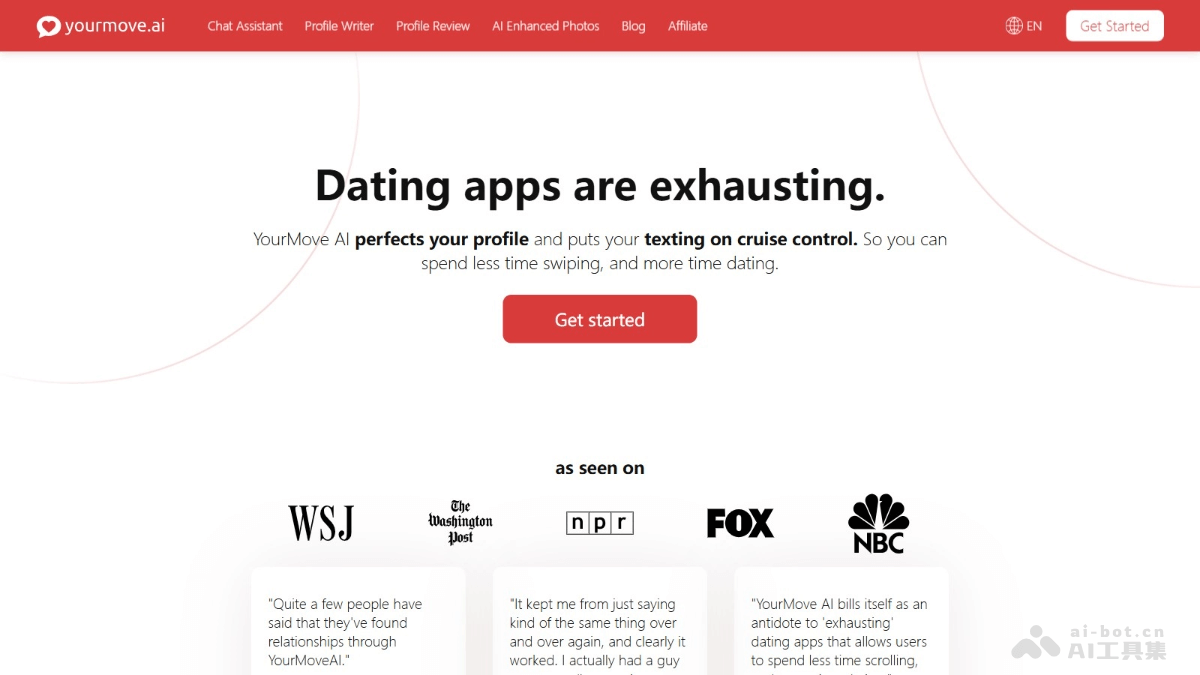
yourmove.ai – AI驱动的约会个人资料优化生成工具
yourmove.ai是AI驱动的约会助手,能简化在线约会体验。yourmove.ai基于完善个人资料、生成个性化开场白和回复,提供个人资料优化建议,帮助用户提高在约会应用中的匹配率和沟通效率。用户只需输入话题或上传个人资料截图,yourmove.ai能快速提供定制化的聊天开场白和回复建议。
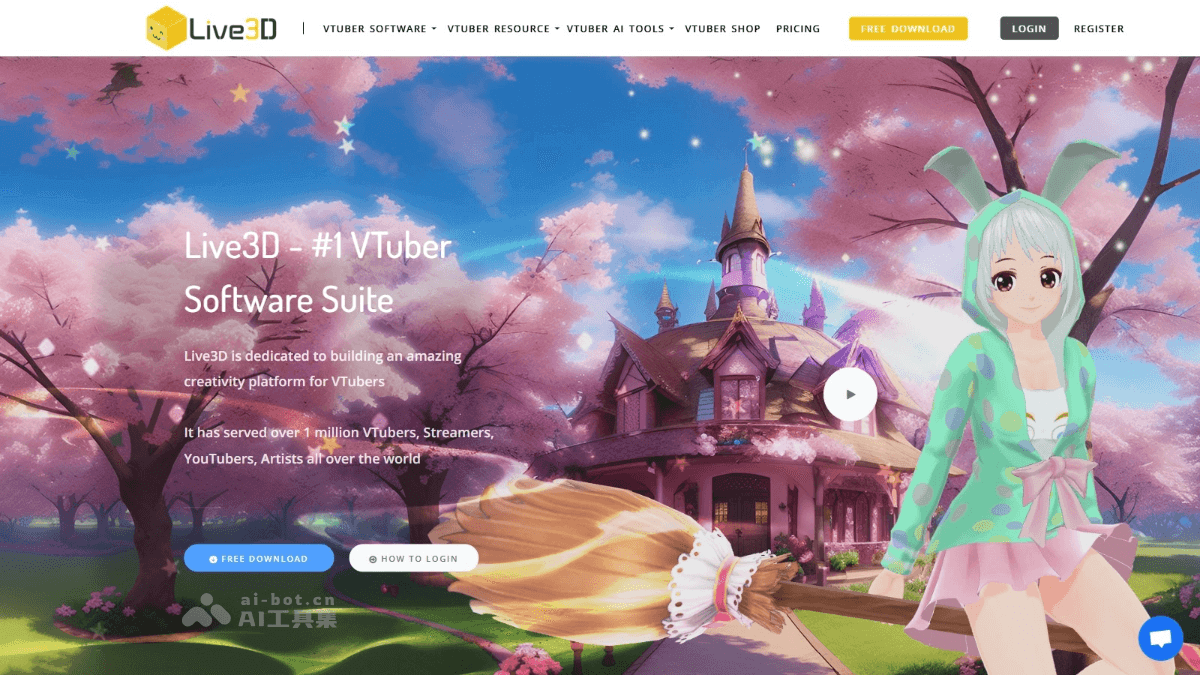
Live3D – 专为虚拟主播 VTuber设计定制个性化的虚拟形象平台
Live3D是专为虚拟主播(VTuber)设计的软件套件,包括VTuber Maker、VTuber Editor和VTuber Gallery等组件。Live3D提供快速面部追踪、丰富的3D形象库、自定义动画制作和直播互动效果。用户能创建和定制个性化的虚拟形象,进行高质量的直播。
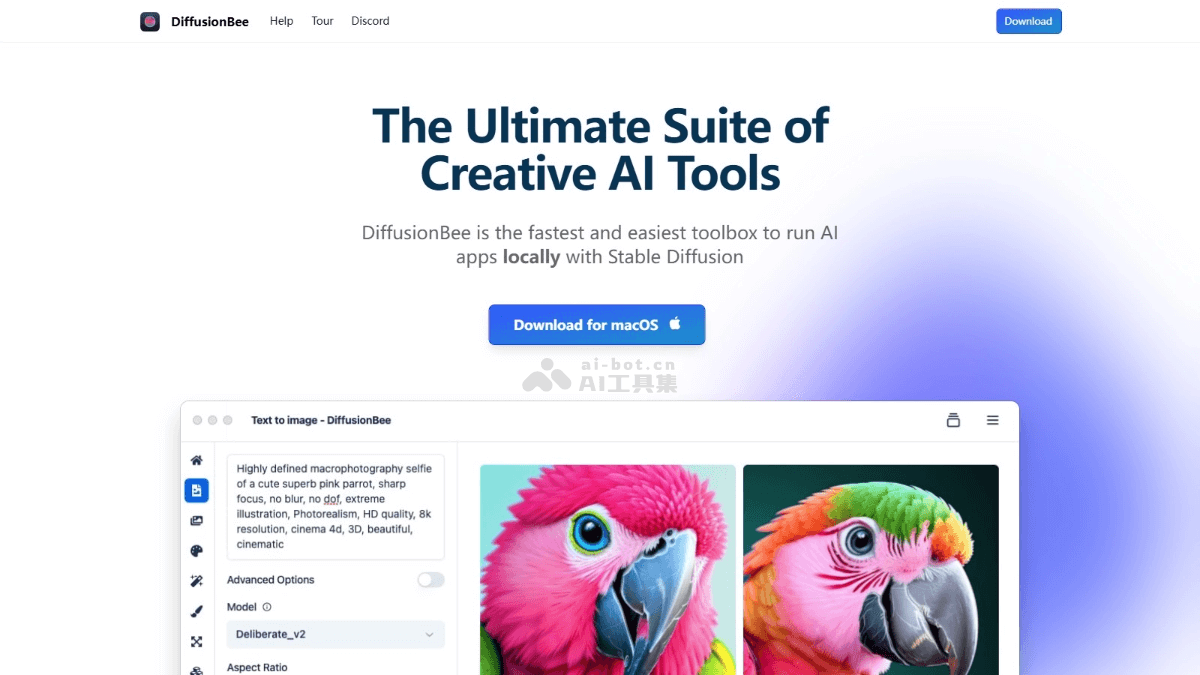
DiffusionBee – AI绘画工具,文本描述或草图生成特定艺术作品
DiffusionBee是基于Stable Diffusion技术的AI艺术创作应用程序,支持用户在本地计算机上快速生成和编辑图像,无需依赖云端服务。DiffusionBee基于简单的提示或草图,用户能激发创造力,生成具有特定风格、对象或人物的艺术作品。
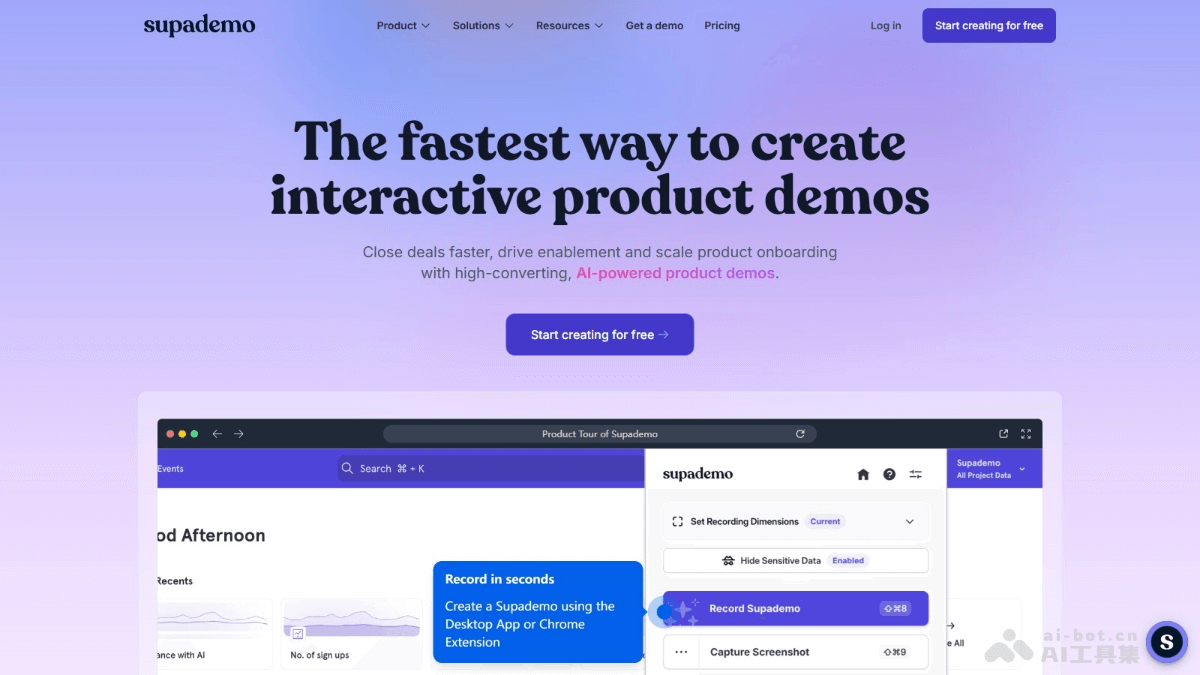
Supademo – AI驱动的交互式产品演示创建平台
Supademo是AI驱动的交互式产品演示创建平台,用简化的录制、个性化和分享流程,帮助用户快速生成高转化率的产品演示。平台基于生成性AI技术,提供自动文本注释、AI语音旁白和多语言翻译等功能,增强演示效果。
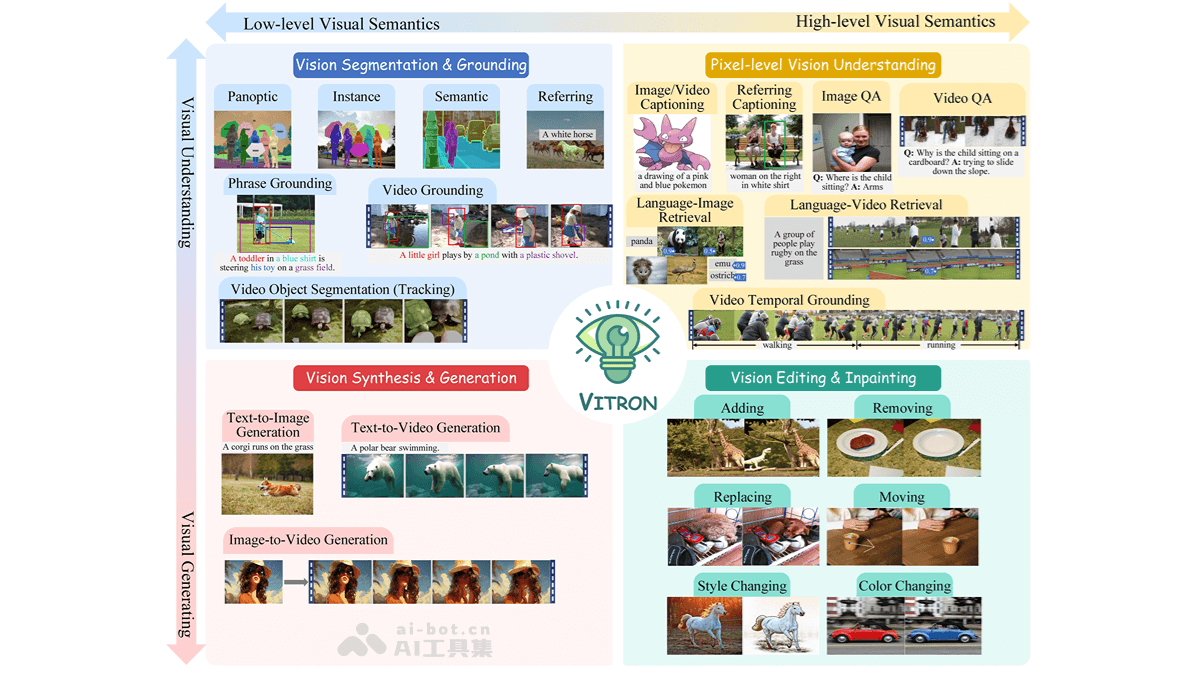
VITRON – Skywork AI 联合新加坡国立、南洋理工推出的像素级视觉大型语言模型
VITRON是Skywork AI、新加坡国立大学和南洋理工大学联合推出的像素级视觉大型语言模型(LLM),能全面理解和处理静态图像与动态视频,对图像和视频进行理解、生成、分割和编辑。VITRON结合前端的视觉编码器和后端的视觉专家系统,支持从视觉理解到视觉生成的多种任务。
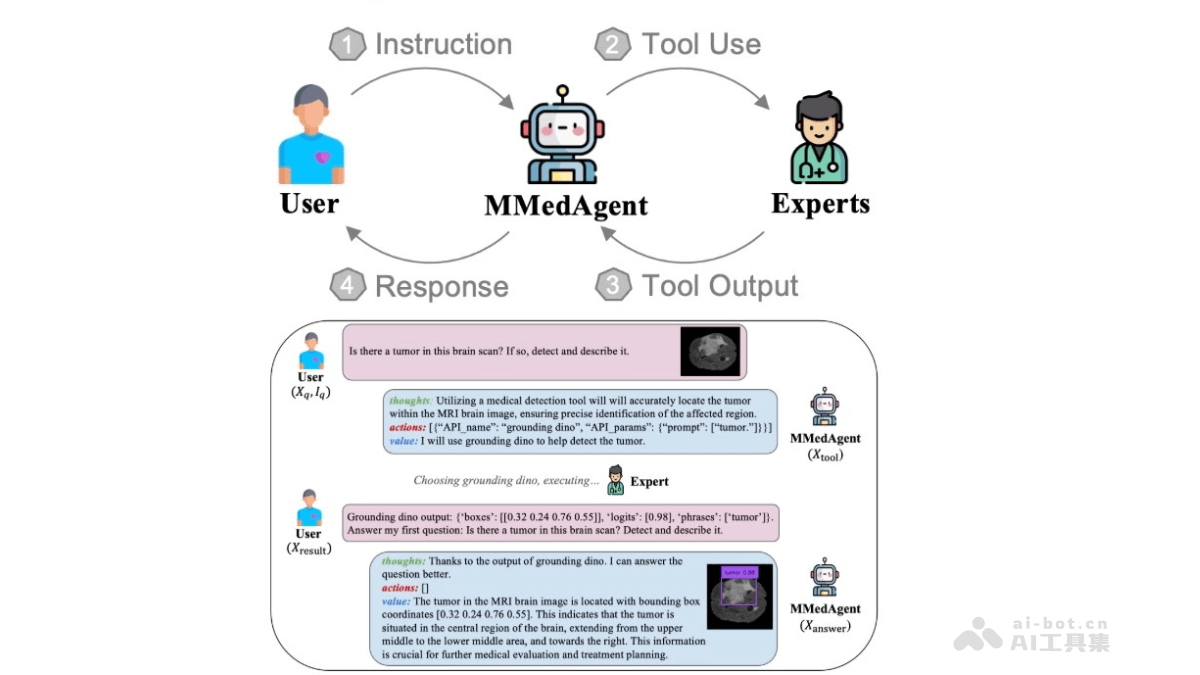
MMedAgent – 专为医疗领域设计的多模态AI智能体,管理多种医疗任务
MMedAgent是专为医疗领域设计的多模态AI智能体,通过整合各种开源医疗模型来管理多种医疗任务。系统包括一个指令调整的多模态大型语言模型(MLLM),作为行动规划器和结果聚合器,以及一套为代理量身定制的医疗工具集合,每个工具都针对医疗领域的特定任务。
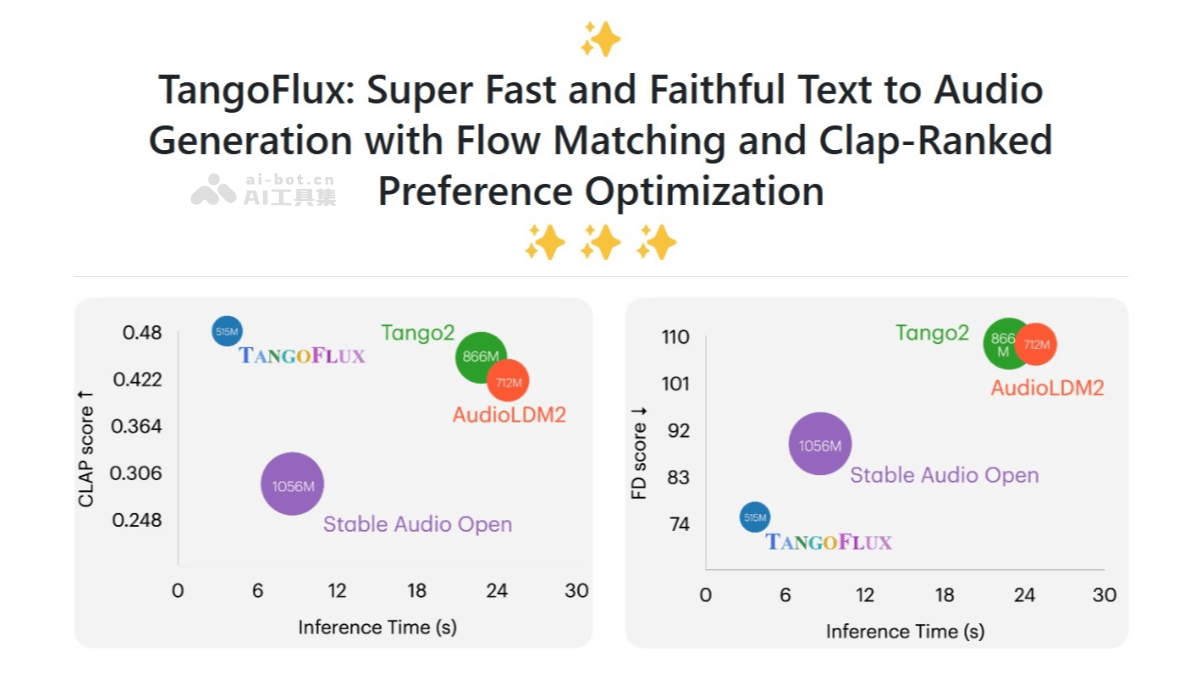
TANGOFLUX – 英伟达联合新加坡科技设计大学开源的文本到音频生成模型
TANGOFLUX是高效的文本到音频生成模型,是新加坡科技设计大学(SUTD)和NVIDIA共同推出的。模型拥有约5.15亿参数,能在单个A40 GPU上仅用3.7秒生成长达30秒的44.1kHz音频。TANGOFLUX用CLAP-Ranked Preference Optimization(CRPO)框架,基于迭代生成和优化偏好数据来提升模型的音频对齐能力。
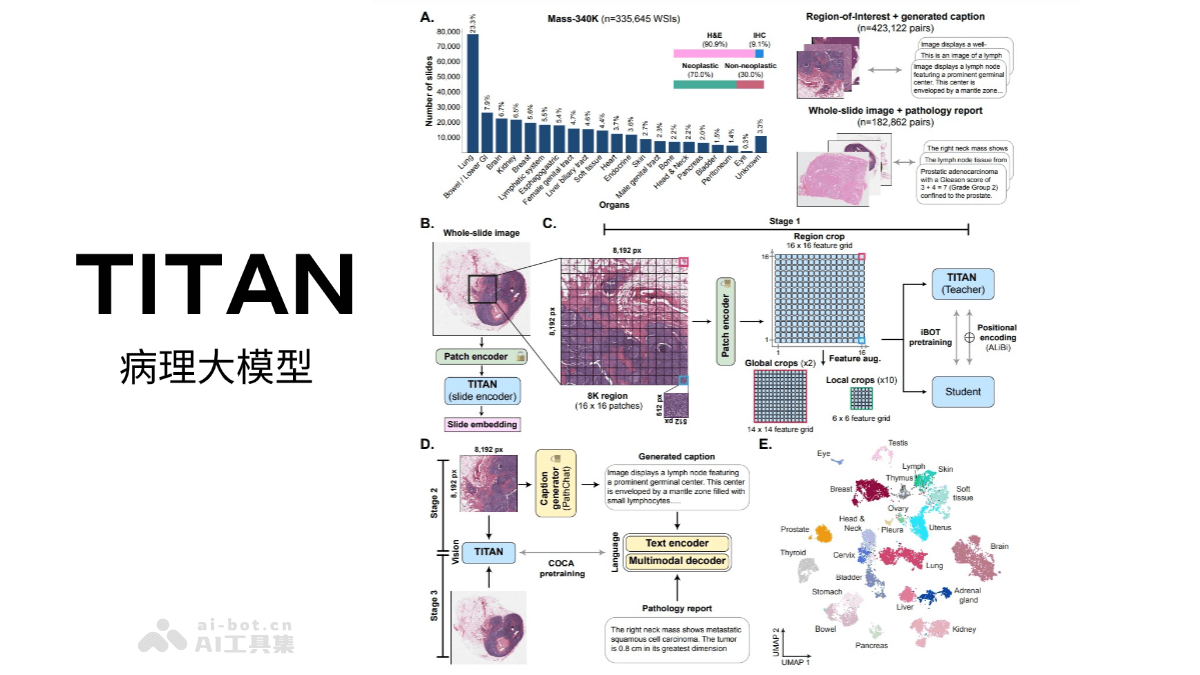
TITAN – 哈佛医学院研究推出的多模态全切片病理基础模型
TITAN是哈佛医学院研究团队开发的多模态全切片病理基础模型,通过视觉自监督学习和视觉-语言对齐预训练,能在无需微调或临床标签的情况下提取通用的切片表示,生成病理报告。它使用了335,645张全切片图像(WSIs)以及相应的病理报告,结合了423,122个由多模态生成型AI协作者生成的合成字幕。