
AI文章
模型进展、开源项目和 AI 工具教程,读懂新东西能帮你做什么。
已收录 7,595 篇
文章列表,第 274 页
J1 Assistant – 罗永浩旗下 Jarvis 项目推出的 AI 智能助手
J1 Assistant 是罗永浩旗下 AI 初创项目 Jarvis 推出的聚合类 AI 智能助手。J1 Assistant的最大特色在于语音输入按钮,用户可以通过这个按钮输入语音,可以将语音转换为文本消息发送、发送至谷歌搜索引擎、发送至自家 AI 模型询问、发送至 ChatGPT AI 询问,或者作为新建备忘录。
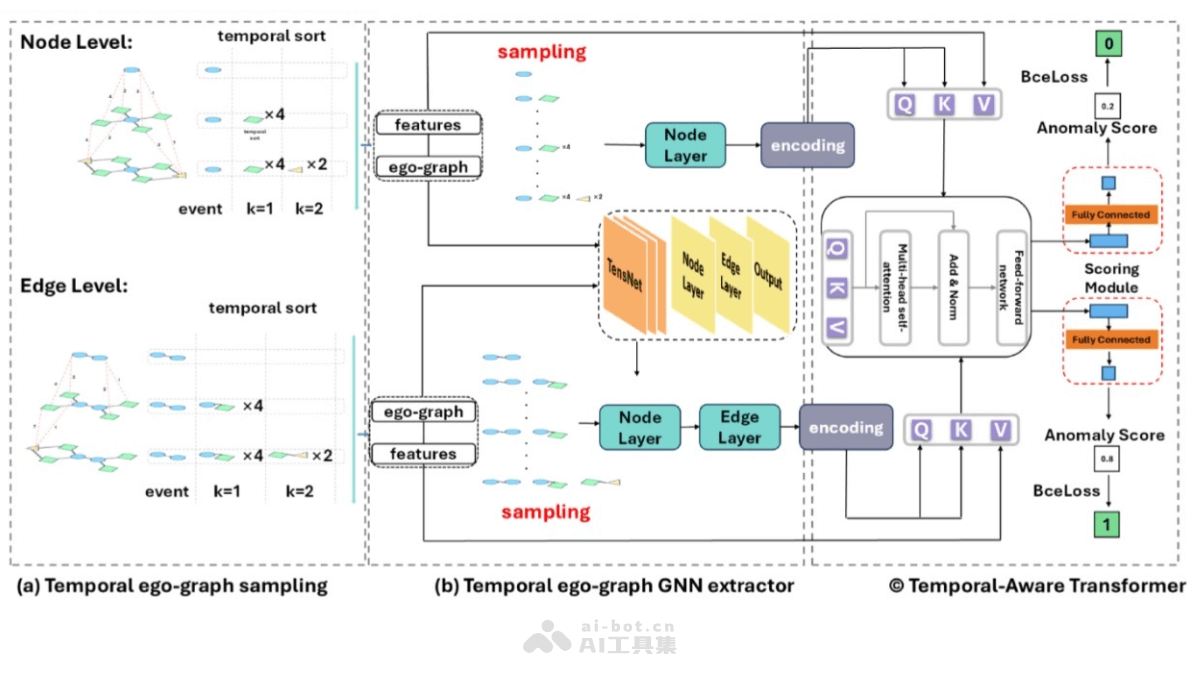
GeneralDyG – 南洋理工推出的通用动态图异常检测方法
GeneralDyG 是南洋理工大学研究团队提出的通用动态图异常检测方法,解决动态图数据在社交网络、电商和网络安全等领域的异常检测问题。通过时间 ego-graph 采样模块、图神经网络提取模块和时间感知 Transformer 模块,有效应对数据分布多样性、动态特征捕捉困难和计算成本高等挑战。
CodeElo – 阿里 Qwen 团队推出评估 LLM 编程能力的基准测试
CodeElo 是用于评估大型语言模型(LLMs)在编程竞赛级别代码生成能力的基准测试工具。通过与人类程序员的 Elo 评级系统进行比较,来衡量 LLMs 的编程水平。工具从 CodeForces 平台选择题目,按比赛分区、难度级别和算法标签进行分类,确保问题的多样性和代表性。
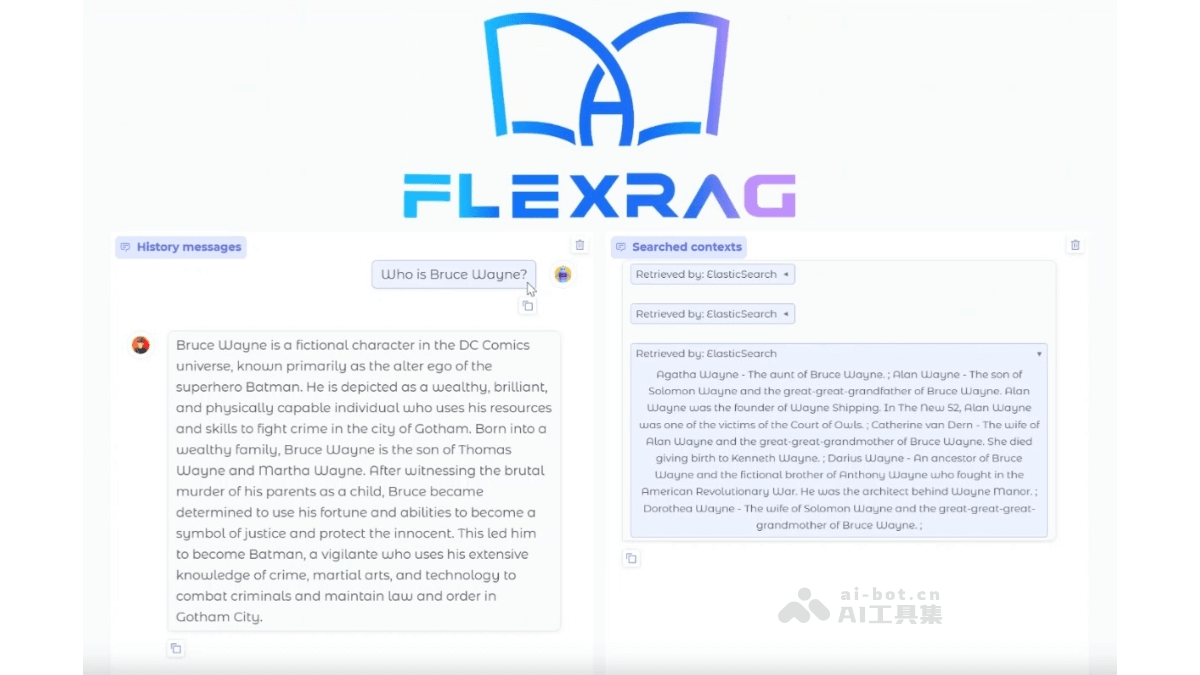
FlexRAG – 中科院推出的高性能多模态 RAG 框架
FlexRAG 是创新的检索增强生成(RAG)框架,解决传统 RAG 系统在处理长上下文时面临的计算成本高和生成质量不足的问题。通过将检索到的上下文信息压缩成紧凑的嵌入表示,显著降低计算负担。
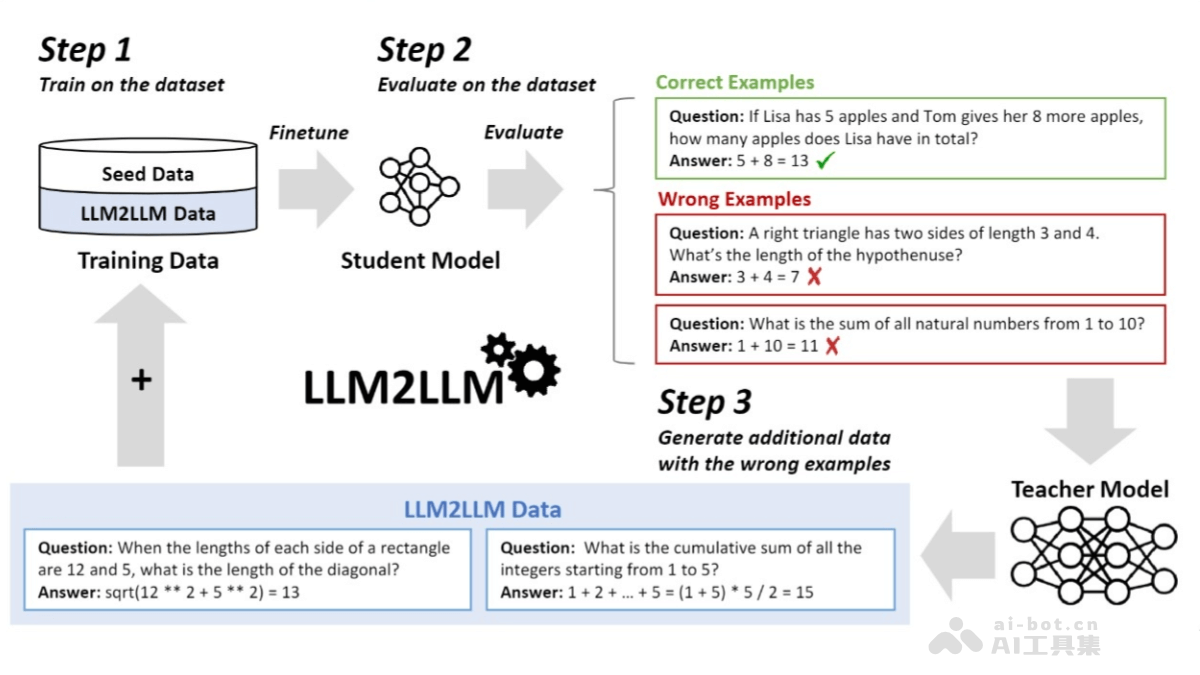
LLM2LLM – 通过迭代数据增强提升大语言模型的技术
LLM2LLM是创新的迭代数据增强策略,提升大型语言模型(LLM)在数据稀缺情况下的性能。方法通过基于一个强大的教师模型来生成合成数据,增强学生模型的训练数据集。具体来说,学生模型首先在有限的种子数据上进行微调,然后教师模型会识别学生模型在预测中的错误,并基于这些错误生成新的合成数据。
Stable Diffusion 3.5 实用提示构建指南
提示是有效使用生成式 AI 图像模型的技巧。提示的结构直接影响生成的图像的质量、创造力和准确性。Stable Diffusion 3.5 在可定制性、高效性能、多样化输出和多功能风格方面表现出色,成为初学者和专家的理想选择。本指南提供了 SD3.5 的实用提示技巧,让您能快速准确地完善图像概念。
smoltalk-chinese – OpenCSG 开源专为中文大型语言模型设计的合成数据集
smoltalk-chinese 是OpenCSG开源的专为中文大型语言模型(LLM)设计的合成数据集,该数据集包含超过 70 万条合成数据,涵盖了信息查询、推理、计划、编辑、编程、数学、角色扮演、数据分析、创意写作、咨询和头脑风暴等多种任务类型。
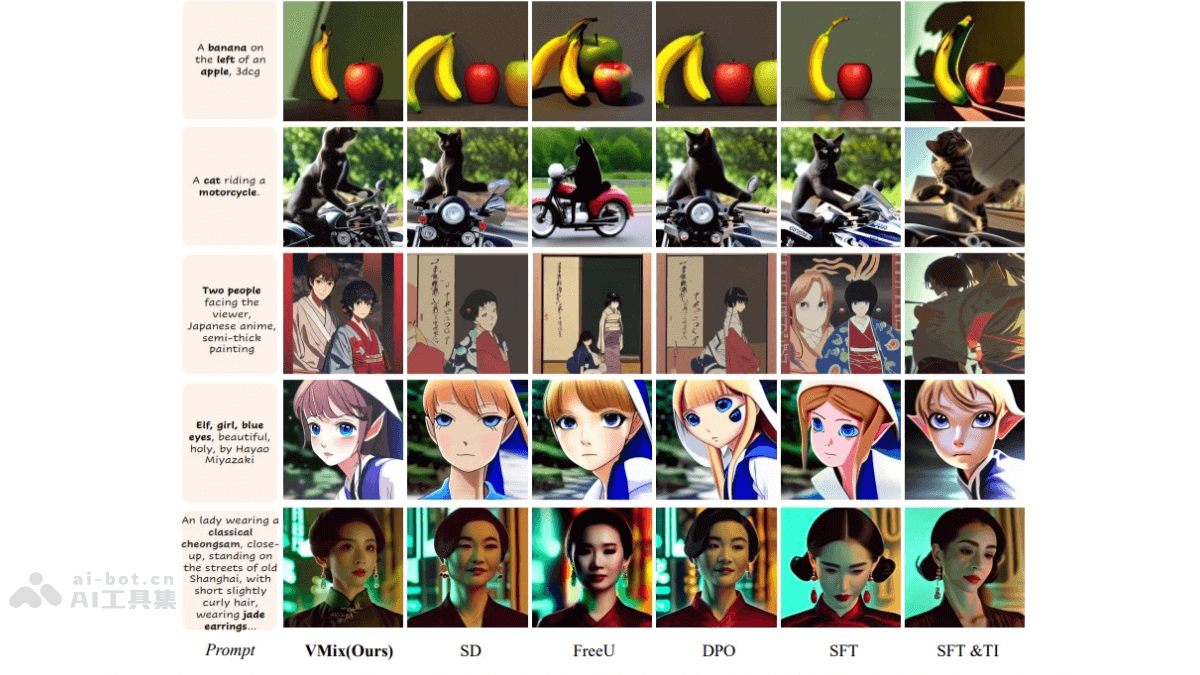
VMix – 字节联合中科大推出增强模型生成美学质量的适配器
VMix是创新的即插即用美学适配器,提升文本到图像扩散模型生成图像的美学质量。通过解耦输入文本提示中的内容描述和美学描述,将细粒度的美学标签(如色彩、光线、构图等)作为额外条件引入生成过程。
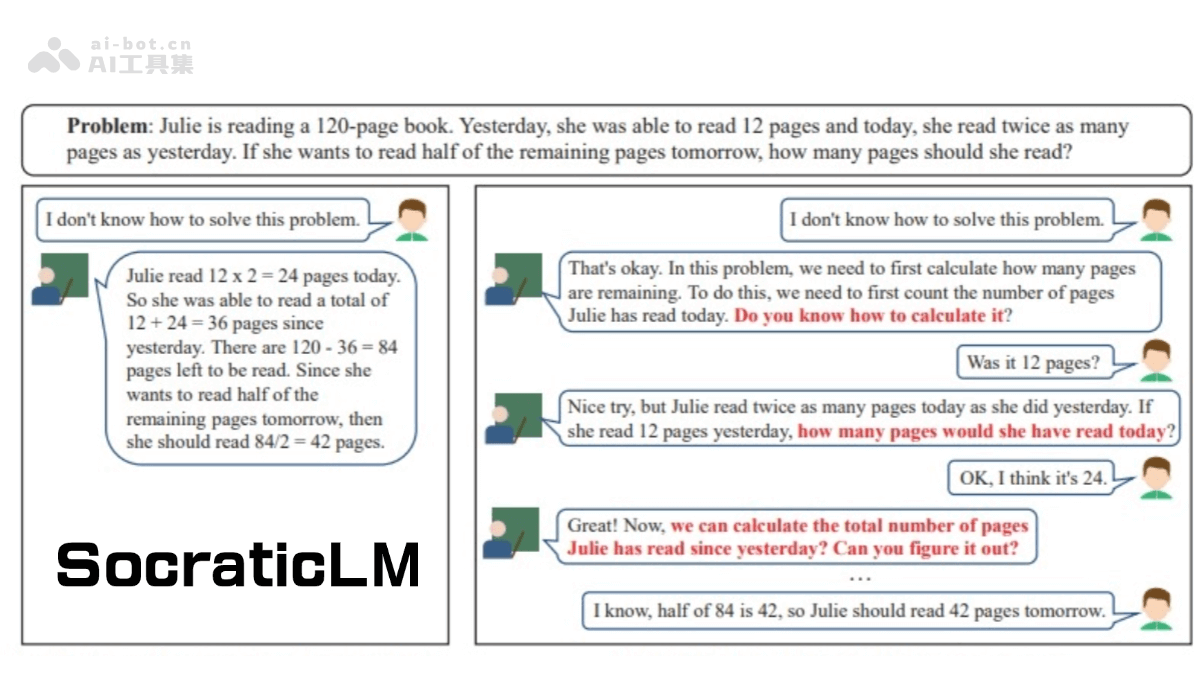
SocraticLM – 中科大和科大讯飞共同推出的苏格拉底教学大模型
SocraticLM 是通过苏格拉底式的教学法来教授数学的创新人工智能模型,模型由中科大和科大讯飞共同开发,采用了“Thought-Provoking”教学范式,通过提问引导学生主动思考和解决问题。SocraticLM 在名为 SocraTeach 的数据集上进行了微调,该数据集包含 35,000 个精心设计的多轮教学对话,模拟了真实的教学场景。
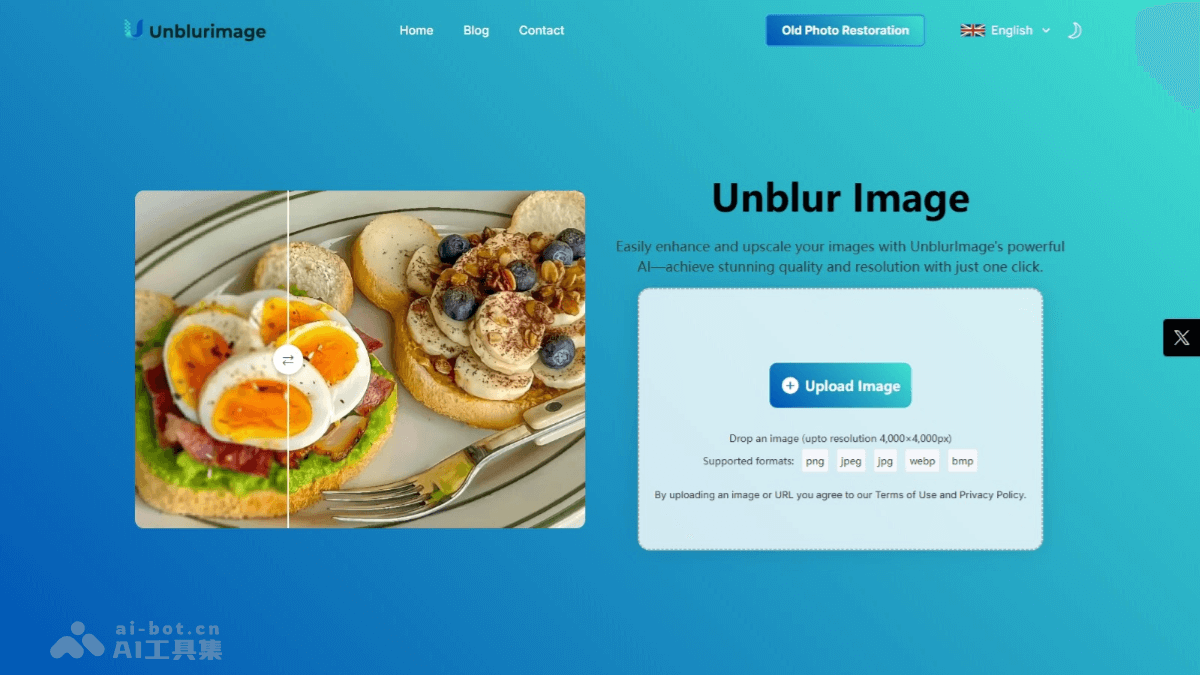
UnblurImage – AI图像增强工具,多种选项调整图片的清晰度和细节
UnblurImage 是基于AI技术的在线工具,用于去除图片中的模糊并增强图像质量。UnblurImage 基于先进的 AI 技术分析和处理图像,能有效恢复因运动模糊或对焦不佳而受影响的图片清晰度。工具支持多种图片格式,如 PNG、JPG 和 HEIC,支持用户选择不同的增强选项调整图片的清晰度和细节。
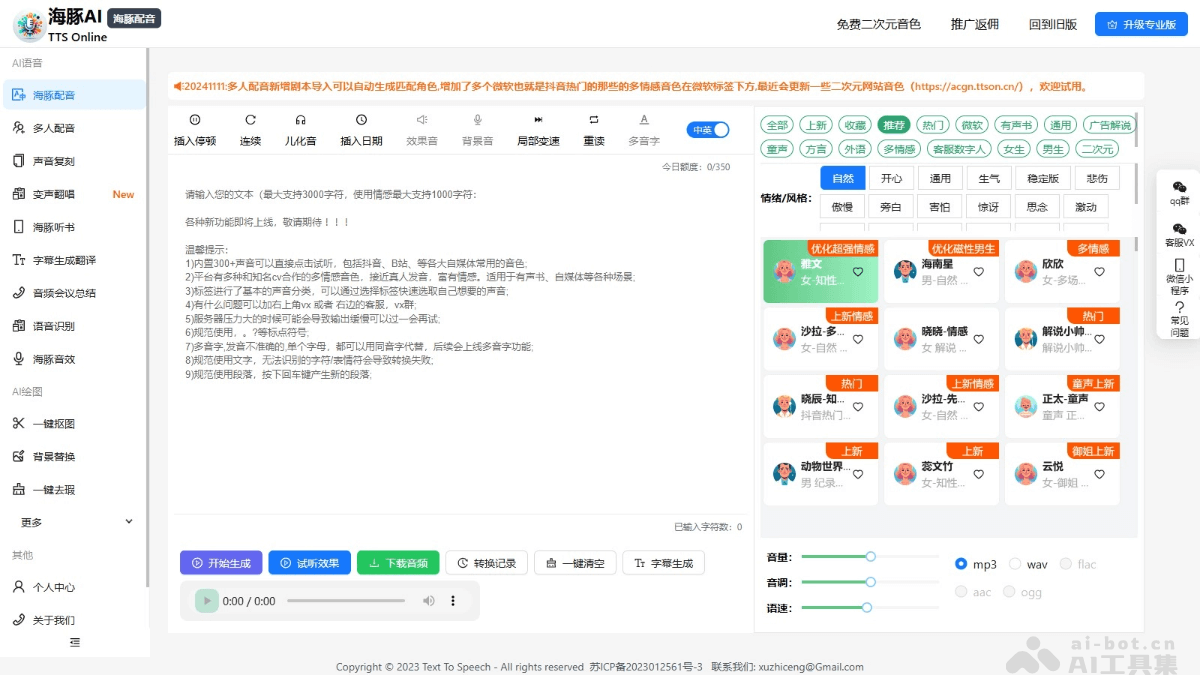
海豚AI配音 – AI配音工具,支持真人音色和二次元音色
海豚AI配音是功能全面的AI配音工具,能将文本转换为逼真、富有情感的语音。海豚AI配音提供超500种真人音色和1000多种二次元音色,支持20多种语言,满足不同用户的需求。
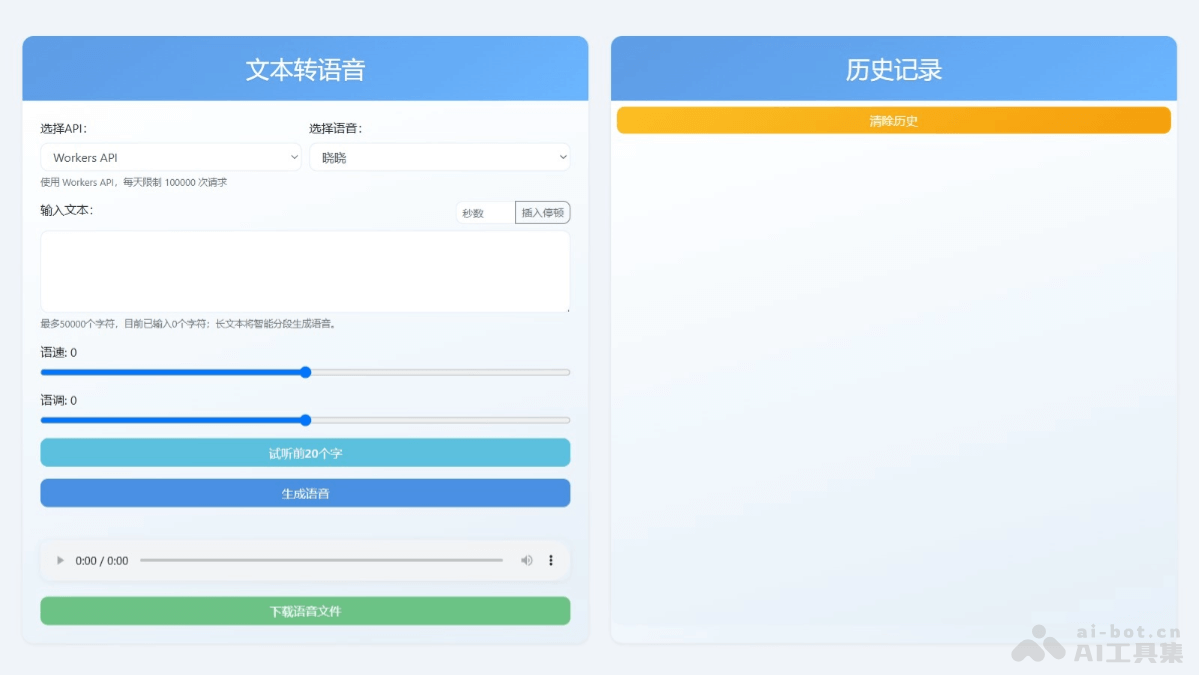
Ciallo TTS – 在线AI文本转语音工具,支持长文本自动分段处理
Ciallo TTS是开源的在线文本转语音工具,支持超过300种语言和口音的声音选择。用户根据需要调节语速和语调,生成自然流畅的语音效果。工具提供即时试听功能,支持用户在下载音频文件前预听语音质量,确保满足需求。
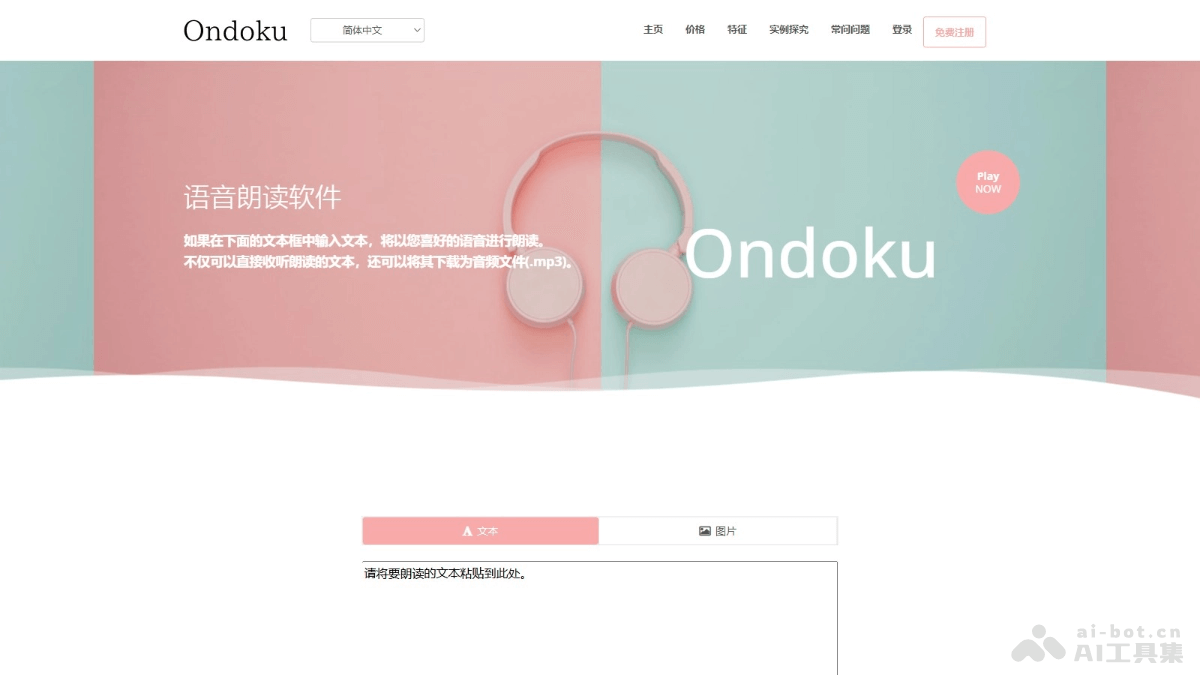
Ondoku – AI文字转语音工具,提供文本输入和图片文字提取功能
Ondoku 是在线文字转语音(TTS)工具,能将文本转换成自然流畅的语音。Ondoku支持多种语言,包括日语、英语、中文、韩语等,适合不同语言需求的用户。Ondoku 提供文本输入和图片文字提取功能,用户能轻松将文字内容转换为语音。
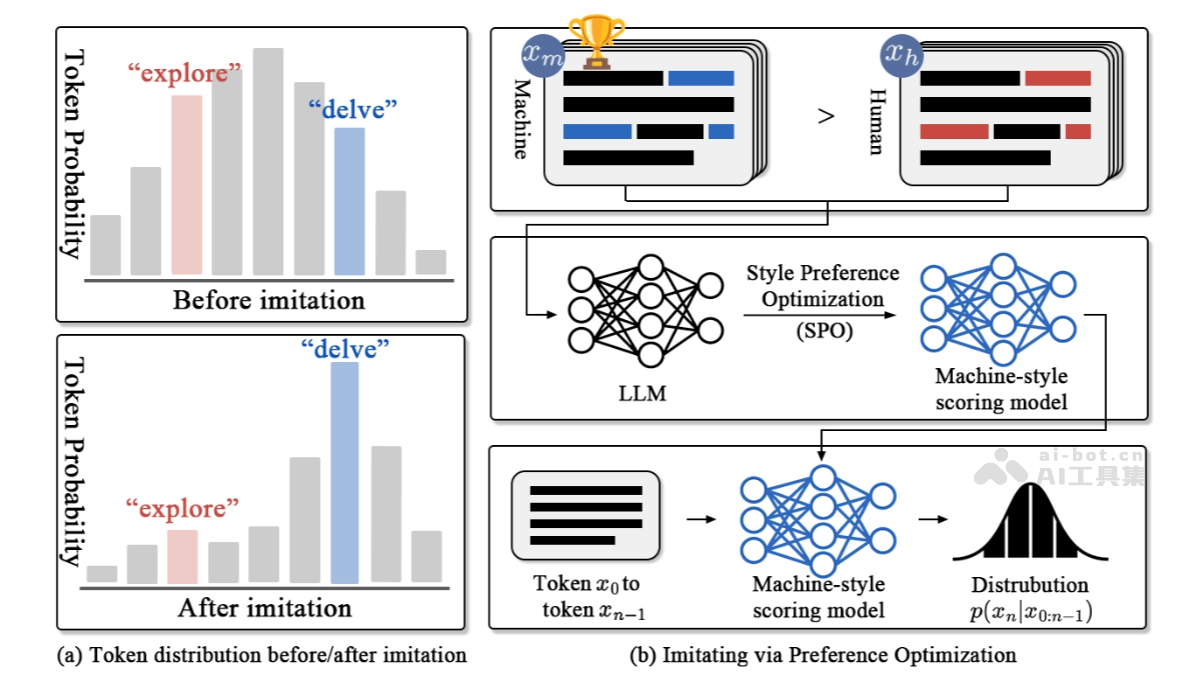
ImBD – 复旦联合华南理工等机构推出的通用 AI 内容检测器
ImBD(Imitate Before Detect)是复旦大学、华南理工大学、武汉大学、Fenzi AI等推出的用在检测机器修订文本的方法。首先模仿大型语言模型(LLMs)生成文本的风格,基于风格偏好优化(SPO)调整评分模型,让其更符合机器修订文本的特征。然后,利用风格条件概率曲率(Style-CPC)量化原始文本与条件概率采样生成文本之间的对数概率差异,有效区分人类写作和机器修订内容。
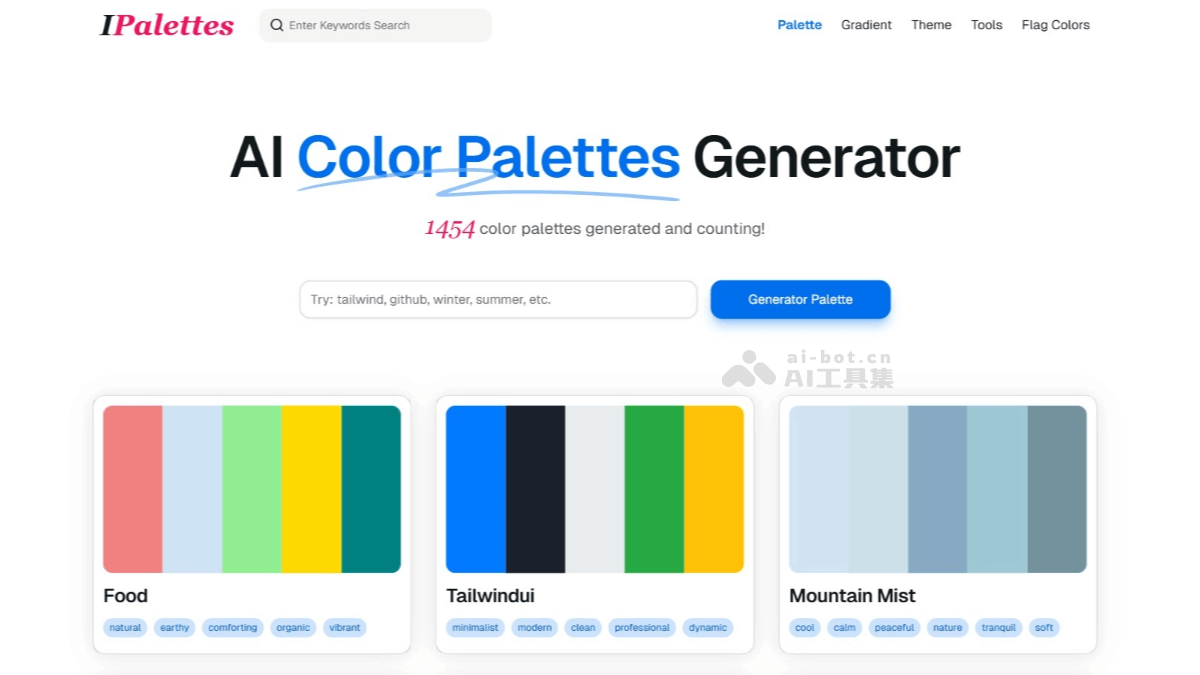
IPalettes – AI调色板生成器,输入关键词生成相关的颜色调色板
IPalettes 是 AI 驱动的颜色调色板生成器,能激发创意满足各种设计需求。用户输入关键词创建相关的颜色调色板,调色板能用在网页设计、UI 设计、服装搭配、室内装饰等多个领域。平台提供多种工具,例如颜色搭配服装生成器、调色板卡片生成器、照片和调色板拼贴生成器等,帮助用户更好地理解和应用颜色。
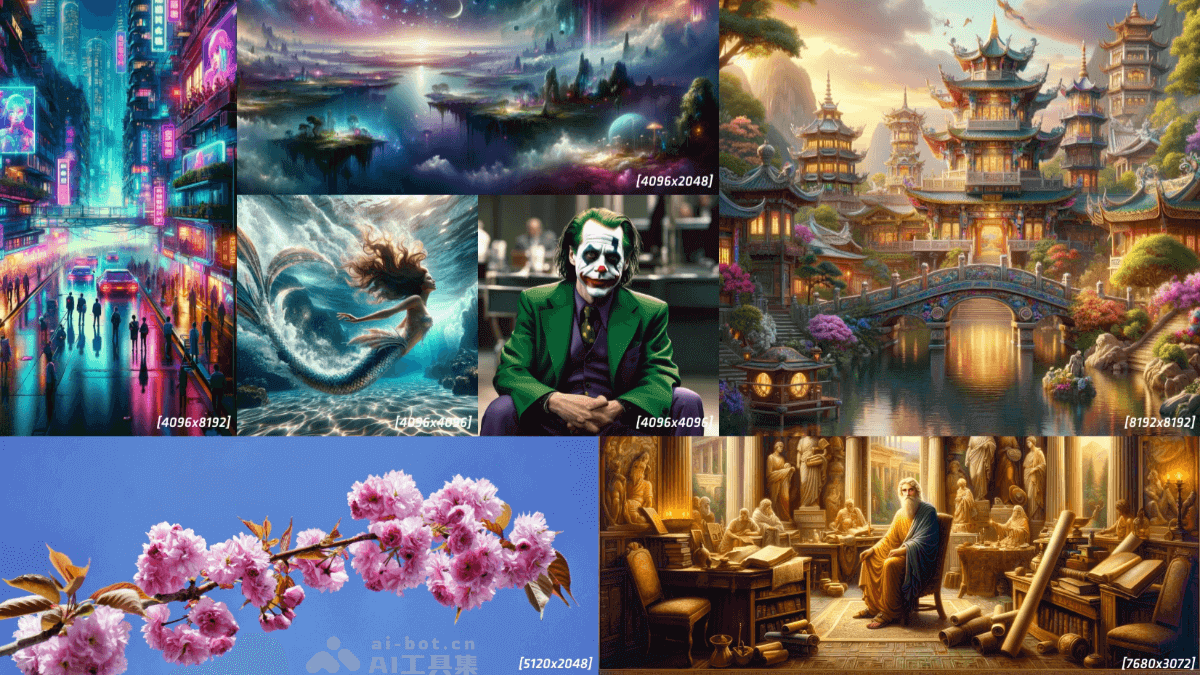
Inf-DiT – 清华联合智谱 AI 推出的超高分辨率图像生成模型
Inf-DiT 是清华大学、智谱AI 推出基于扩散模型的图像上采样方法,能生成超高分辨率图像。Inf-DiT引入单向块注意力机制(UniBA),将生成过程中的空间复杂度从 O(N^2) 降低到 O(N),有效解决传统扩散模型在生成大尺寸图像时内存消耗过高的问题。Inf-DiT 用扩散变换器(DiT)结构,能处理各种形状和分辨率的图像上采样任务。
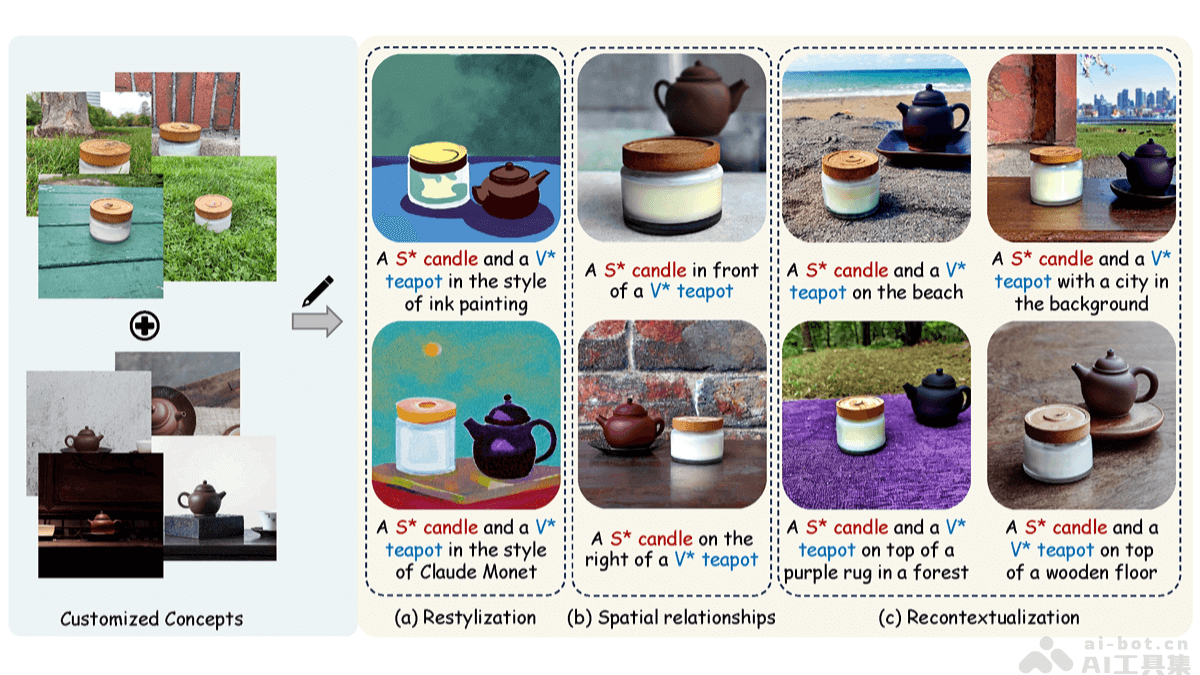
MultiBooth – 清华联合 Meta 等机构推出的多概念图像生成方法
MultiBooth是清华大学深圳国际研究生院、 Meta、香港科技大学等机构推出的多概念图像生成方法,能从文本中生成包含多个用户指定概念的图像。MultiBooth将生成过程分为两个阶段:单概念学习和多概念整合。在单概念学习阶段,基于多模态图像编码器和自适应概念归一化技术,为每个概念学习一个简洁且具有区分性的嵌入表示。
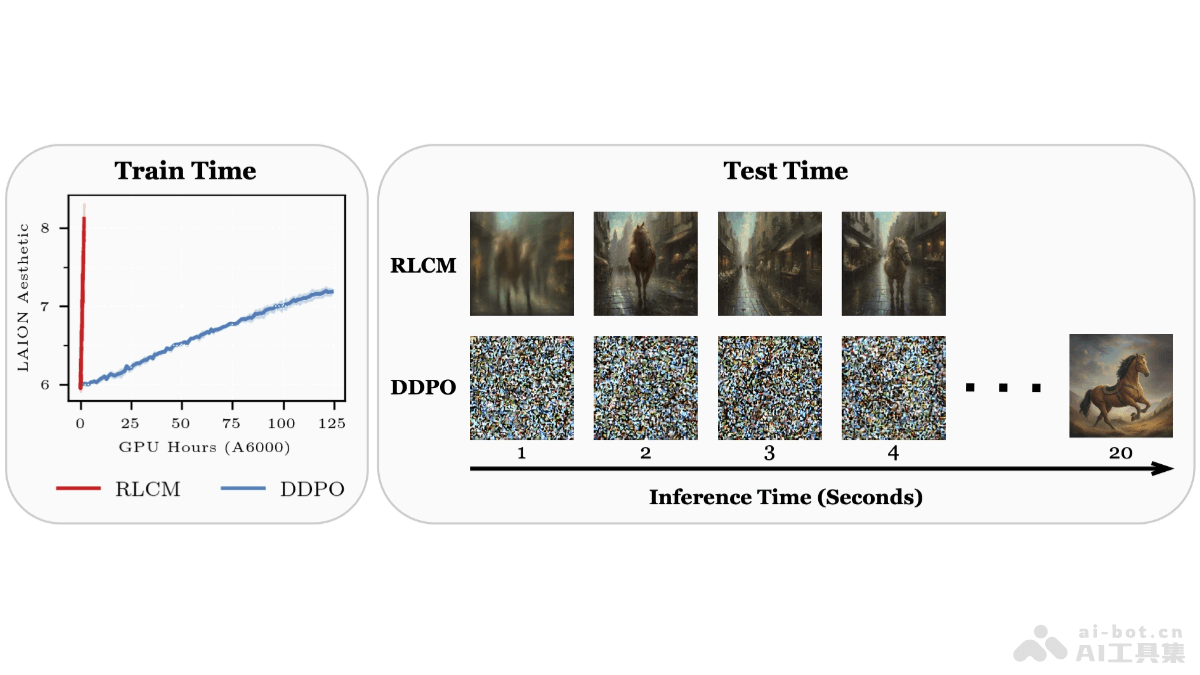
RLCM – 康奈尔大学推出的优化文本到图像一致性模型的框架
RLCM(Reinforcement Learning for Consistency Model)是康奈尔大学推出用在优化文本到图像生成模型的框架,基于强化学习方法微调一致性模型适应特定任务的奖励函数。将一致性模型的多步推理过程建模为马尔可夫决策过程(MDP),基于策略梯度算法优化模型参数,用最大化与任务相关的奖励。