
AI文章
模型进展、开源项目和 AI 工具教程,读懂新东西能帮你做什么。
已收录 7,595 篇
文章列表,第 261 页
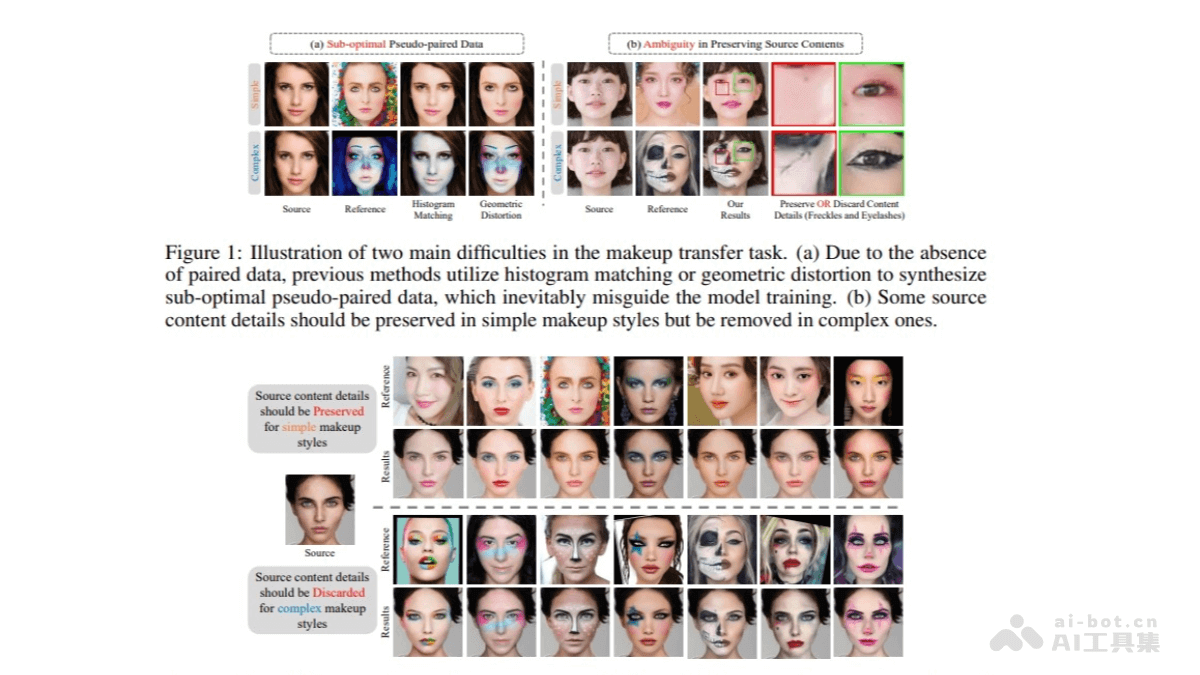
SHMT – 阿里达摩院联合武汉理工等机构推出的自监督化妆转移技术
SHMT(Self-supervised Hierarchical Makeup Transfer)是阿里巴巴达摩院与武汉理工大学等机构联合研发的先进自监督化妆转移技术。技术通过潜在扩散模型实现,能在无需成对训练数据的情况下,将各种化妆风格自然地应用到目标面部图像上。
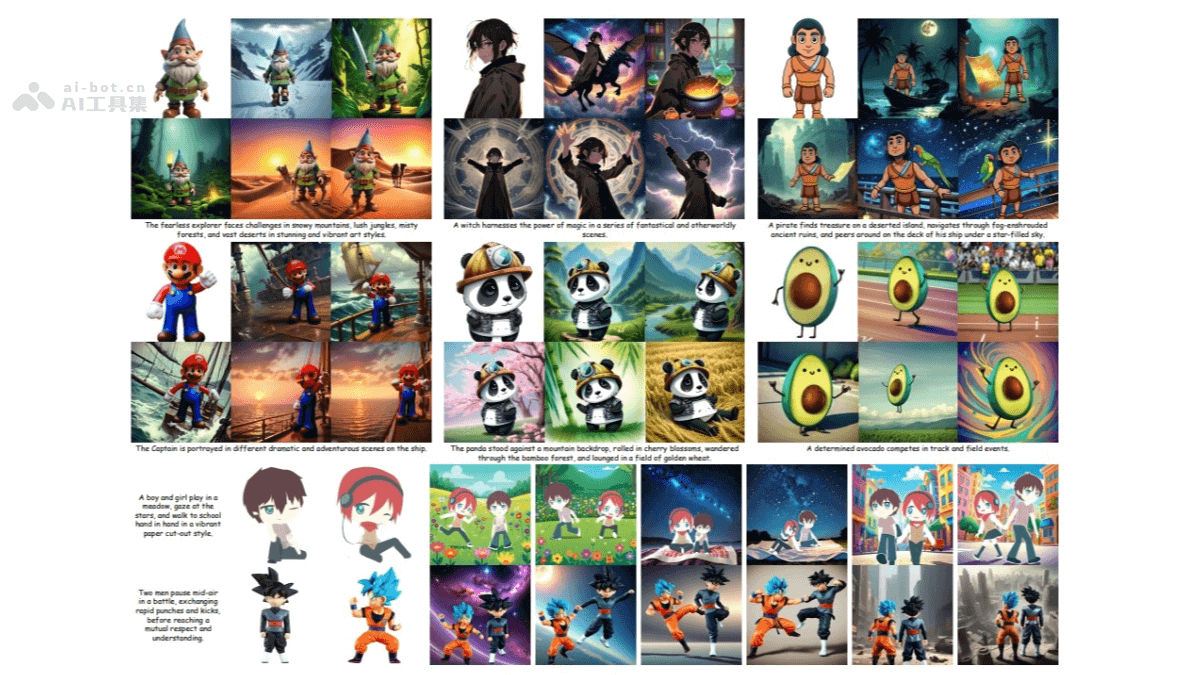
AnyStory – 阿里通义推出的高保真个性化文本到图像生成框架
AnyStory是阿里巴巴通义实验室研发的创新文本到图像生成框架,实现单个和多个主体的高保真个性化图像生成。通过“编码-路由”的方法来建模主体个性化问题。在编码阶段,AnyStory结合强大的ReferenceNet和CLIP视觉编码器,对主体特征进行高保真度的编码,捕捉丰富的细节和语义信息。
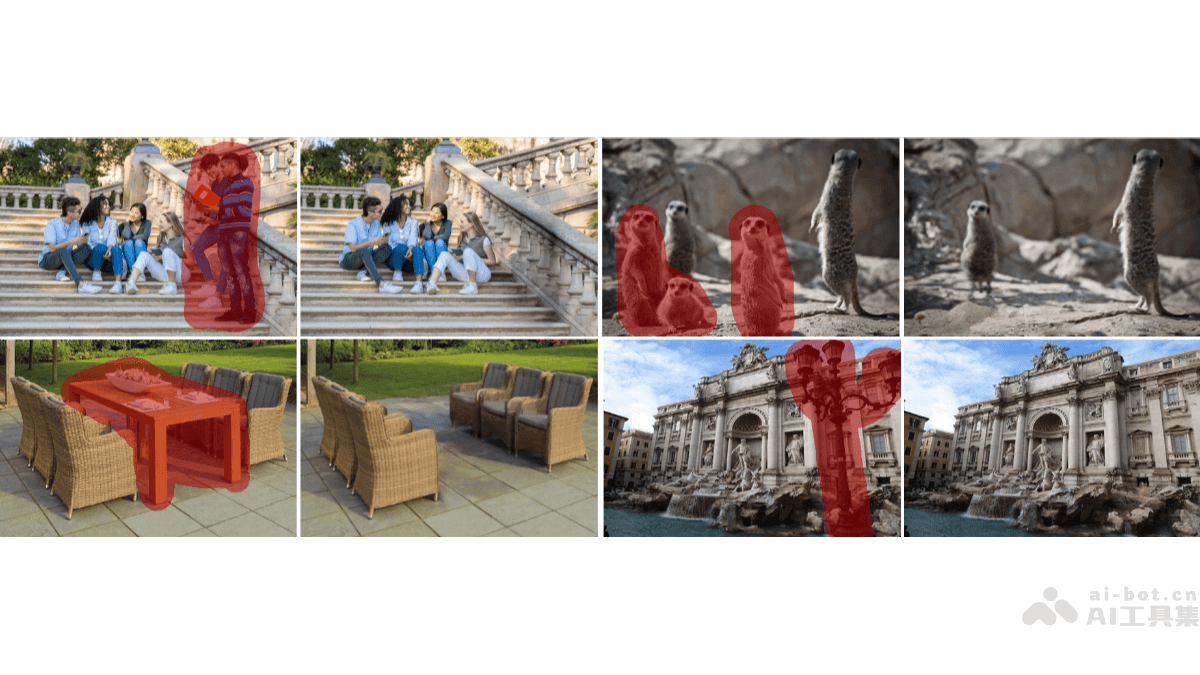
SmartEraser – 中科大与微软亚洲研究院推出的图像对象移除技术
SmartEraser是中国科学技术大学与微软亚洲研究院推出的图像编辑技术,专门用在从图像中移除用户指定的对象。SmartEraser基于创新的“掩码区域引导”(Masked-Region Guidance)范式,与传统的“掩码和修复”(mask-and-inpaint)方法不同,SmartEraser保留掩码区域作为移除过程的引导,能更准确地识别和移除目标对象,同时有效保留周围上下文。
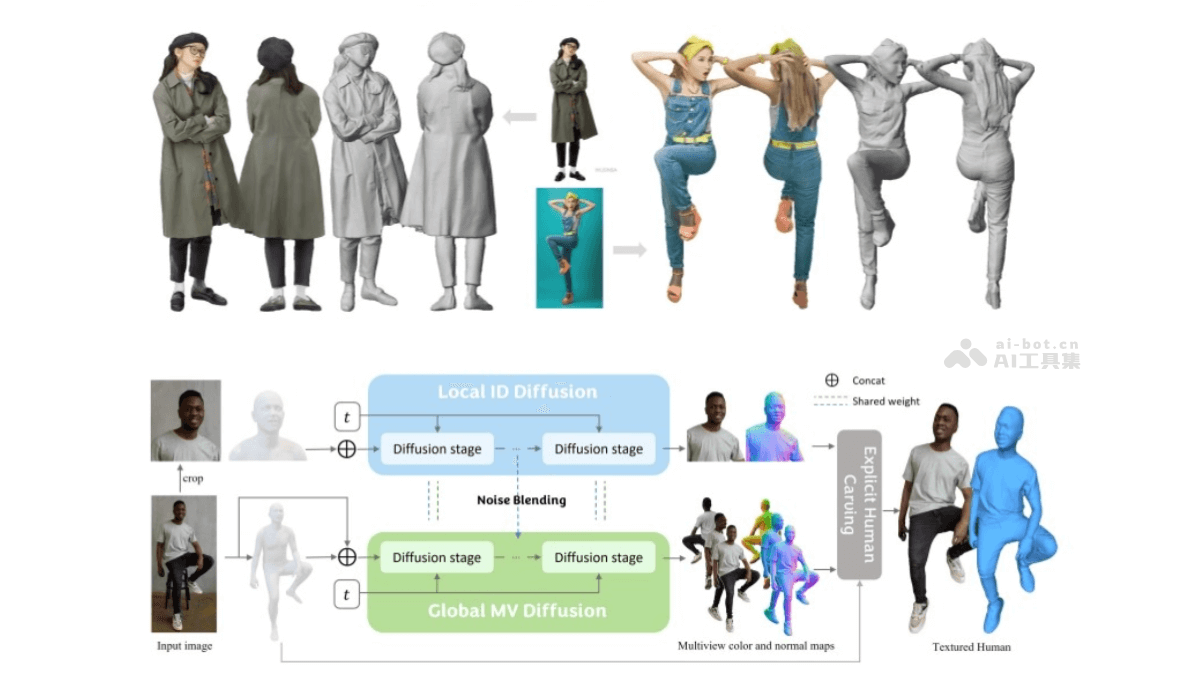
PSHuman – 开源的单图像3D人像重建技术,仅需一张照片
PSHuman是先进的单图像3D人像重建技术。基于跨尺度多视图扩散模型,仅需一张照片,能生成高度逼真的3D人像模型,包括精细的面部表情和全身姿态。核心优势在于能同时建模全局形状和局部细节的联合概率分布,避免几何失真,还能保持不同视图下身体形状的一致性。
NovaMSS – AI音乐源分离工具,精准分离音乐中的不同音源
NovaMSS是基于AI技术的音乐源分离工具。能将音乐中的不同音源,如人声、伴奏、贝斯、鼓点等进行精准分离,让用户可以轻松提取所需的音轨。工具操作简单,无需复杂的配置,小白也能快速上手。
T2A-01-HD – 海螺AI海外版推出新的语音模型
T2A-01-HD是海螺AI海外版推出新的语音模型。支持语音克隆,仅需10秒音频即可精准克隆声音,保留情感底色。模型具备智能情感系统,能捕捉语音中的情感细微差别,使语音更生动。用户可选择自动情绪检测或手动控制,获得完美表达。
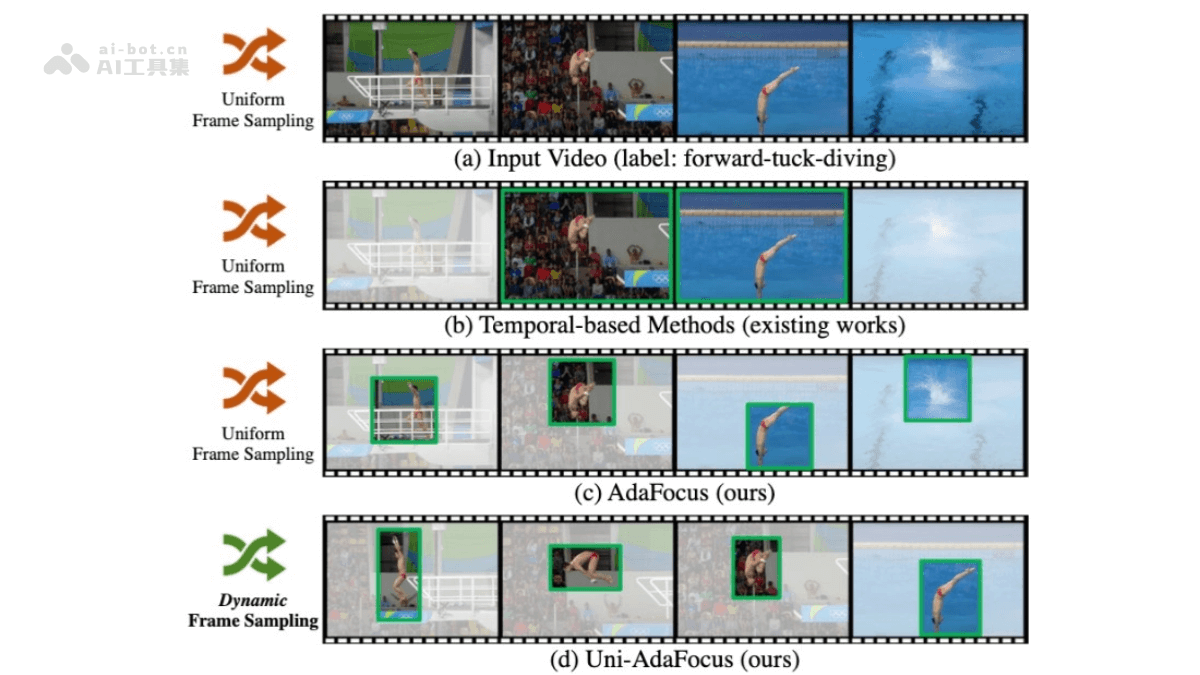
Uni-AdaFocus – 清华大学推出通用的高效视频理解框架
Uni-AdaFocus是清华大学自动化系的研究团队推出的通用的高效视频理解框架,框架通过自适应聚焦机制,动态调整计算资源的分配,实现对视频内容的高效处理。
Video Alchemist – AI视频生成模型,具备多主体开放集合个性化能力
Video Alchemist是Snap公司等推出的新型视频生成模型,具备多主体、开放集合个性化能力,能根据文本提示和参考图像生成视频,无需在测试时进行优化。模型基于Diffusion Transformer模块,通过双重交叉注意力层将参考图像嵌入和主体级文本提示融入视频生成过程。
什么是判别式模型(Discriminative Model) – AI百科知识
判别式模型是机器学习中一类重要的模型,主要用于分类和回归任务。它们的核心目标是学习输入变量x和输出变量y之间的映射关系,即条件概率分布P(y|x)。与生成式模型不同,判别式模型不考虑输入变量x和输出变量y之间的联合分布P(x,y),而是直接建模条件概率P(y|x)。
如何用AI制作爆款武打视频,3分钟学会
我发现短视频平台,越来越多的人在用AI搞抽象了。比如这种武 打对决,简直是流量密码。这几天我测试了好几种AI工具,发现用海螺AI做这种武打视频是最简单的,关键是免费,无需魔法,打斗效果特别带劲。
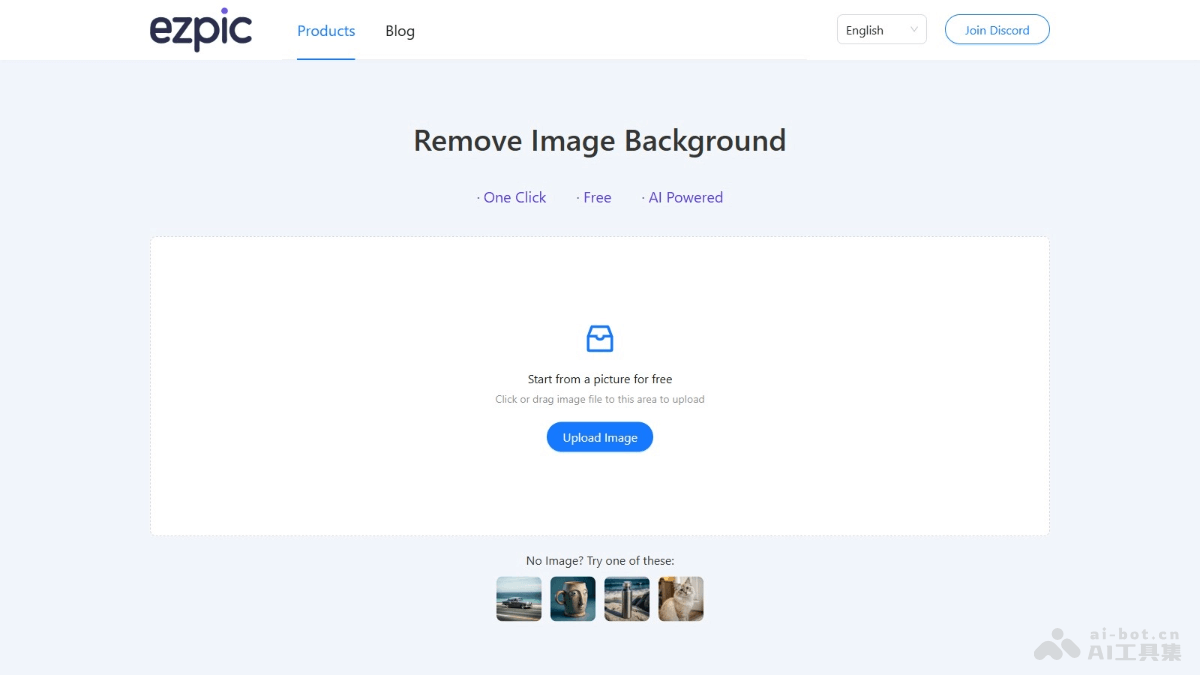
ezpic – AI背景移除工具,自动识别去除背景、更换颜色、去除元素
ezpic是在线免费AI图片背景移除工具,基于智能算法,用户只需上传PNG或JPG格式的图片,AI能自动识别、去除背景,还能选择背景颜色。ezpic操作简单,点击上传后,几秒内能完成背景消除,支持下载处理后的图片。
朱雀AI检测
朱雀AI检测是腾讯推出的综合性 AI 内容检测助手,能精准识别 AI 生成的文本、图像和视频内容。朱雀AI检测支持检测多种主流模型,如 GPT-4、Claude、DeepSeek、Gemini、豆包等,能精准识别各类文本内容是否由 AI 生成。
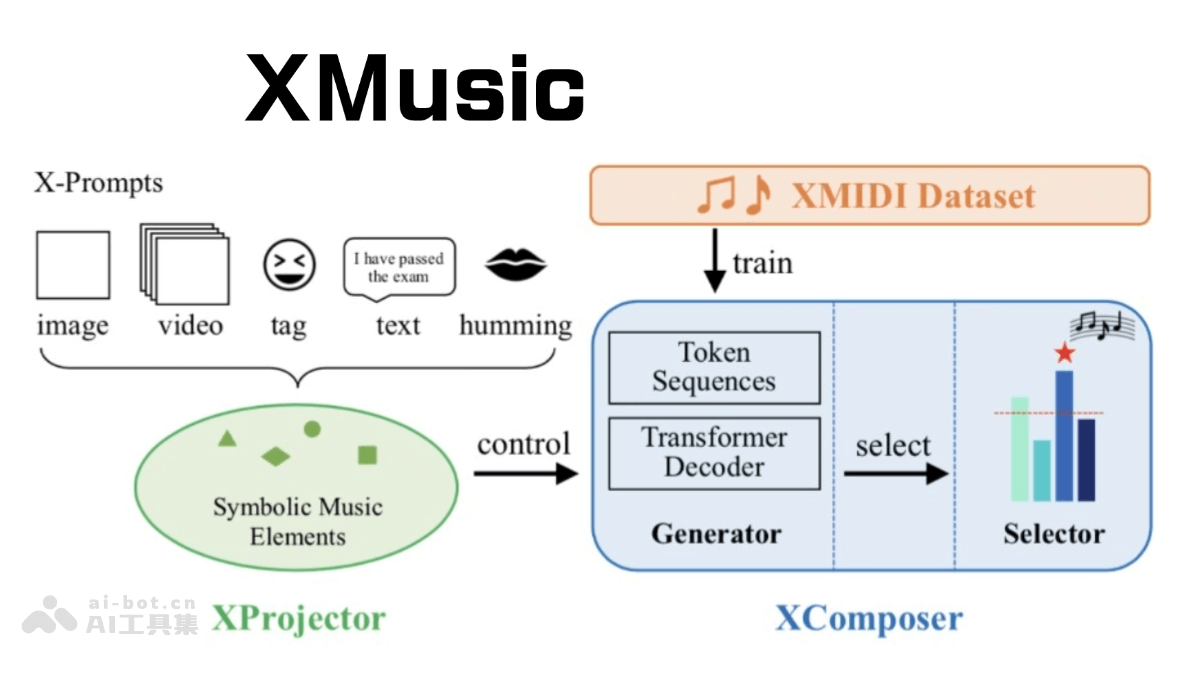
XMusic – 腾讯多媒体实验室自主研发的AI通用作曲框架
XMusic是腾讯多媒体实验室自主研发的AI通用作曲框架。用户只需上传视频、图片、文字、标签、哼唱等任意内容,XMusic能生成情绪、曲风、节奏可控的高质量音乐。基于自研的多模态和序列建模技术,可将提示词内容解析至符号音乐要素空间,以此为控制条件引导模型生成丰富、精准、动听的音乐,达到商用级的音乐生成能力要求。
Weebo – AI语音聊天机器人,实时响应用户语音指令和问题
Weebo是实时语音聊天机器人,基于Whisper Small、Llama 3.2和Kokoro-82M技术驱动。能通过语音识别和生成技术,与用户进行自然流畅的对话,提供实时的语音交互体验。
AutoMouser – AI Chrome扩展程序,实时交互跟踪自动生成测试代码
AutoMouser是Chrome扩展程序,能智能地跟踪用户交互,基于OpenAI的GPT模型自动生成Selenium测试代码。通过记录用户的浏览器操作,如点击、拖动、悬停等,将其转化为结构清晰、易于维护的Python Selenium脚本,简化自动化测试的创建过程。
OmAgent – Om AI联合浙大开源的多模态语言代理框架
OmAgent是Om AI和浙江大学滨江研究院联合开源的多模态语言代理框架,能简化设备端智能代理的开发。OmAgent支持可重用的代理组件,助力开发者构建复杂的多模态代理,处理文本、图像、视频和音频等多种输入形式。
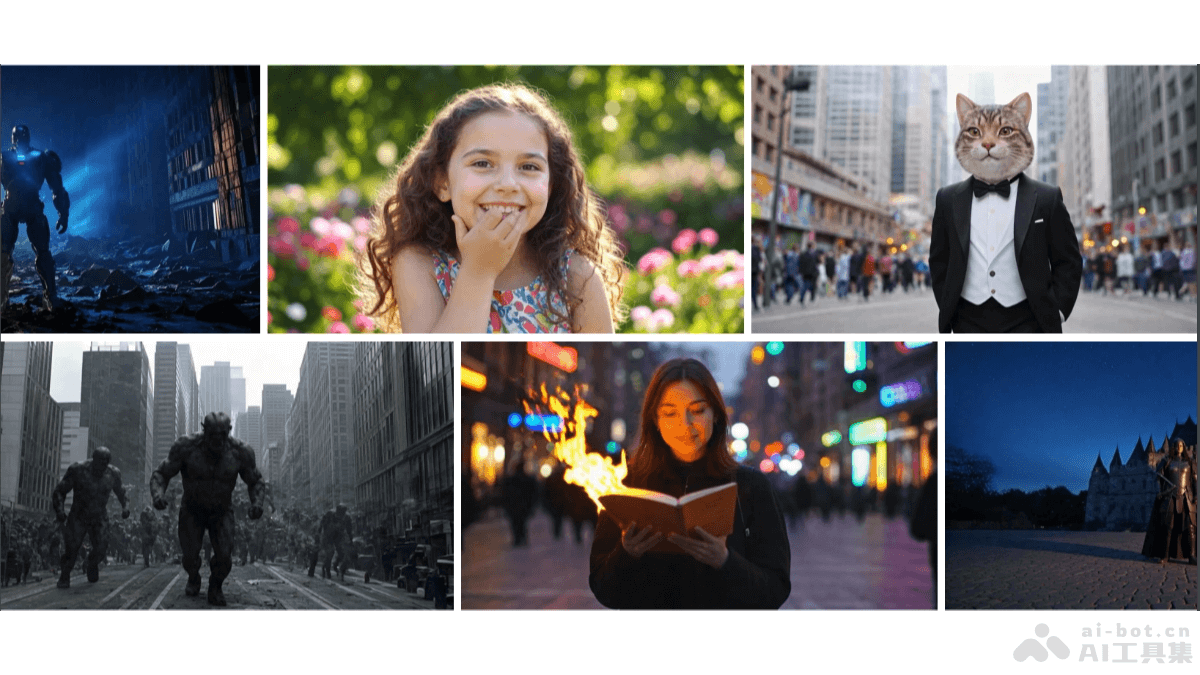
Seaweed APT – 字节跳动推出的单步图像和视频生成项目
Seaweed APT是字节跳动推出的对抗性后训练(Adversarial Post-Training)模型,能实现图像和视频的一站式生成。Seaweed APT基于预训练的扩散模型,直接对真实数据进行对抗性训练,而非用预训练模型作为教师来生成目标,在单步生成中实现高质量的图像和视频输出。
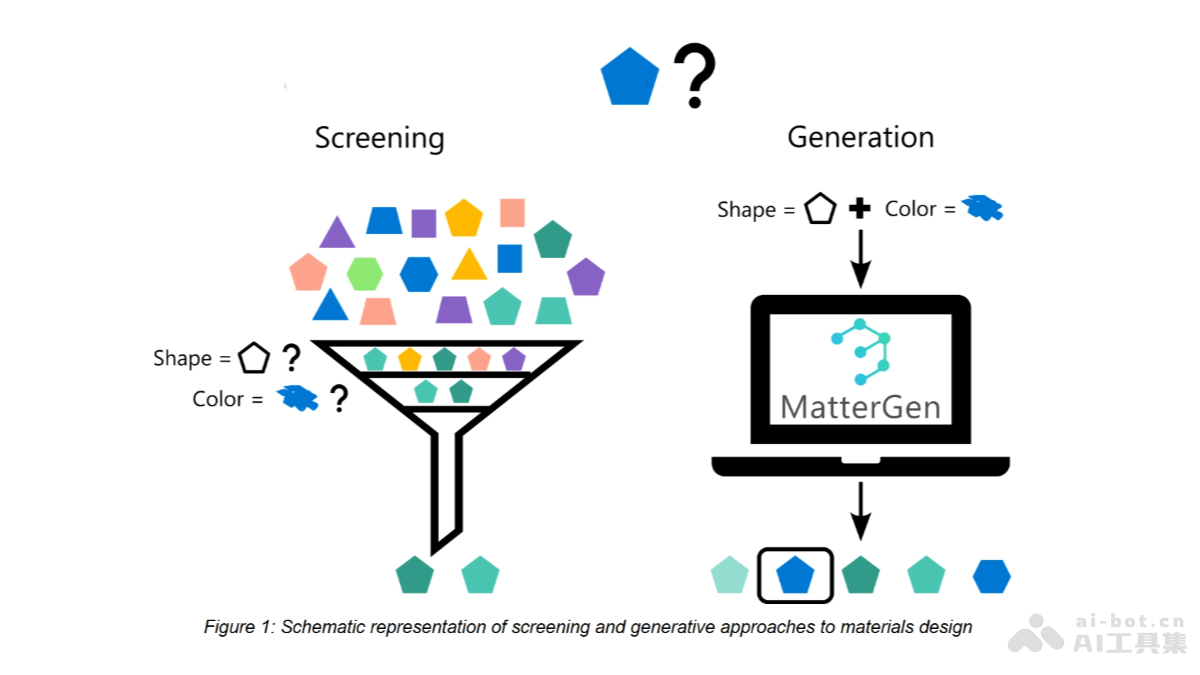
MatterGen – 微软推出的无机材料生成模型
MatterGen是微软推出的创新生成模型,专门用在设计无机材料。基于独特的扩散过程,逐步细化原子类型、坐标和周期晶格,从而生成跨越周期表的稳定、多样化的无机材料。MatterGen能被微调,满足广泛的性能约束,如化学组成、对称性、磁性、电子和机械性能等。