
AI文章
模型进展、开源项目和 AI 工具教程,读懂新东西能帮你做什么。
已收录 7,595 篇
文章列表,第 256 页
SpeechGPT 2.0-preview – 复旦大学推出的端到端实时语音交互模型
SpeechGPT 2.0-preview 是复旦大学 OpenMOSS 团队推出的拟人化实时交互系统,基于百万小时级中文语音数据训练,采用端到端架构,实现了语音与文本模态的高度融合。模型具有拟人口语化表达、百毫秒级低延迟响应,支持自然流畅的实时打断交互。
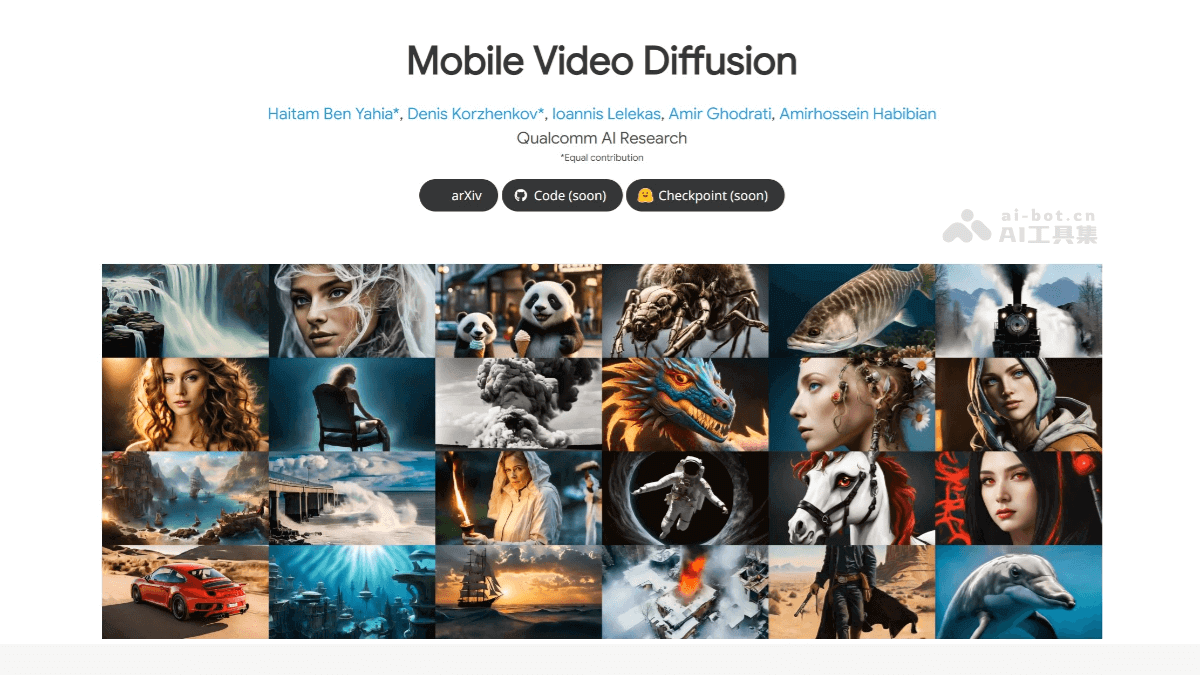
MobileVD – 首个针对移动设备优化的视频扩散模型
MobileVD(Mobile Video Diffusion)是首个针对移动设备优化的视频扩散模型,Qualcomm AI Research团队开发。模型基于Stable Video Diffusion(SVD)的时空UNet架构,通过降低帧分辨率、引入多尺度时间表示以及采用两种新颖的剪枝方案来减少通道数和时间块数量,显著降低了内存和计算成本。
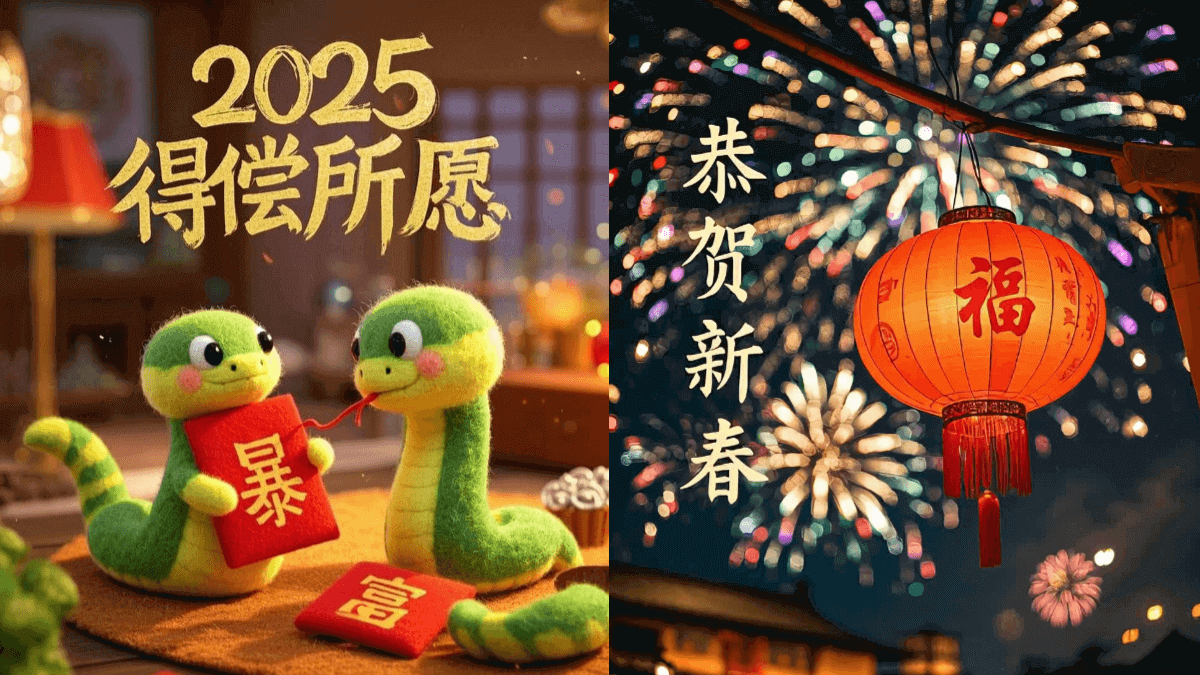
如何用AI定制红包封面,1分钟免费做
今晚就是除夕啦,如何让自己的新年祝福更有特色? 独特又富有意义的红包封面,用AI工具几秒钟就能画一张~可以加入个性化的元素,还完全免费! 花一分钟看完这篇教程,以后不用再找人定制花冤枉钱。
Qwen2.5-VL – 阿里通义千问开源的视觉语言模型
Qwen2.5-VL是阿里通义千问团队开源的旗舰视觉语言模型,具有3B、7B和72B三种不同规模。模型在视觉理解方面表现出色,能识别常见物体,分析图像中的文本、图表等元素。Qwen2.5-VL具备作为视觉Agent的能力,可以推理并动态使用工具,能初步操作电脑和手机。
Janus-Pro – DeepSeek 开源的统一多模态模型
Janus-Pro是 DeepSeek 推出的开源AI模型,支持图像理解和图像生成,提供 1B 和 7B 两种规模,适配多元应用场景。通过改进的训练策略、扩展的数据集和更大规模的模型,显著提升了文本到图像的生成能力和指令跟随性能。
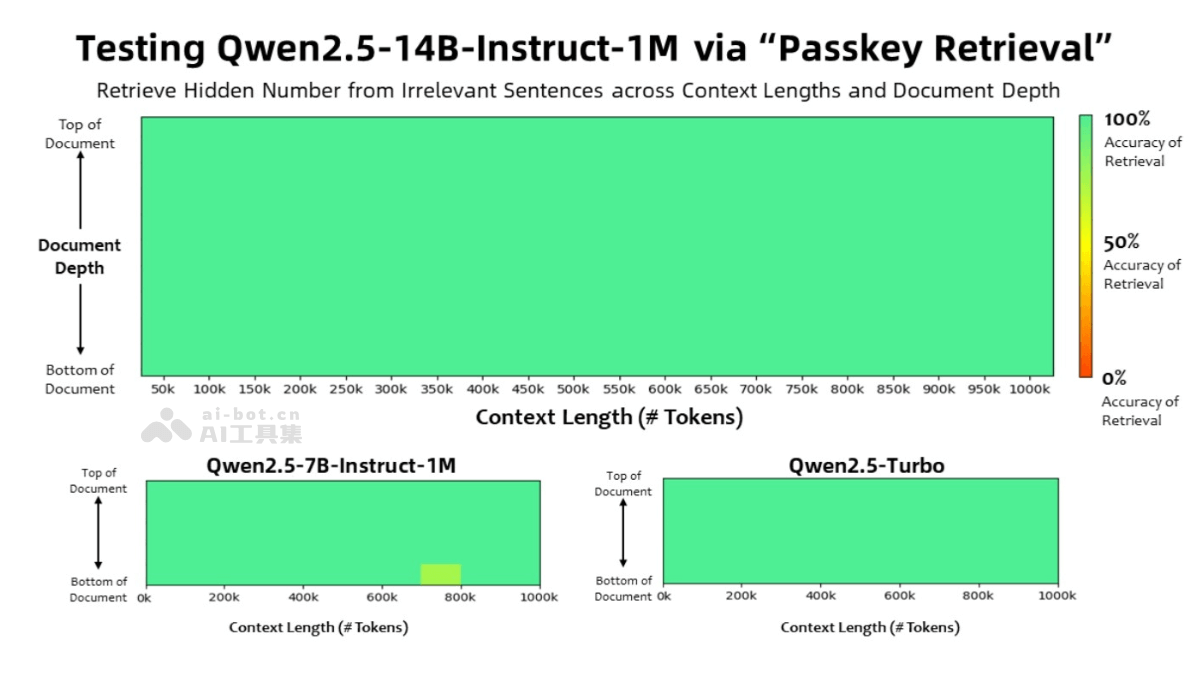
Qwen2.5-1M – 阿里通义千问开源的语言模型,支持100万Tokens上下文
Qwen2.5-1M是阿里通义千问团队推出的开源模型,支持100万Tokens的上下文长度。模型包括Qwen2.5-7B-Instruct-1M和Qwen2.5-14B-Instruct-1M两个模型。在长上下文任务中表现出色,优于之前的128K版本,特别是在处理超过64K长度的任务时。
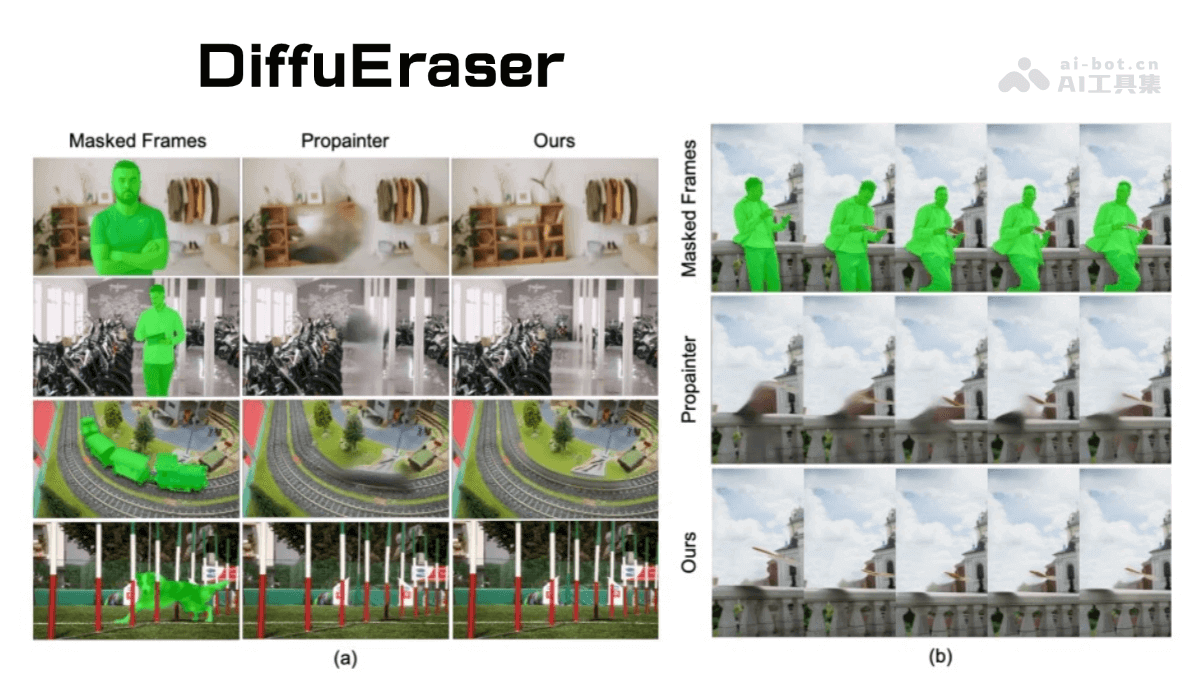
DiffuEraser – 阿里通义实验室推出的视频修复模型
DiffuEraser是基于稳定扩散模型的视频修复模型,以更丰富的细节和更连贯的结构填充视频中的遮罩区域。模型通过结合先验信息来提供初始化和弱条件,有助于减少噪声伪影和抑制幻觉。为了在长序列推理期间提高时间一致性,DiffuEraser 扩展了先验模型和自身的时间感受野,进一步基于视频扩散模型的时间平滑特性来增强一致性。
TeleAI-t1-preview – 中国电信推出的复杂推理大模型
TeleAI-t1-preview是中国电信人工智能研究院发布的“复杂推理大模型”,具备强大的逻辑推理与数学推导能力。通过强化学习训练方法,引入探索、反思等思考范式,提升了复杂问题的解答精度。
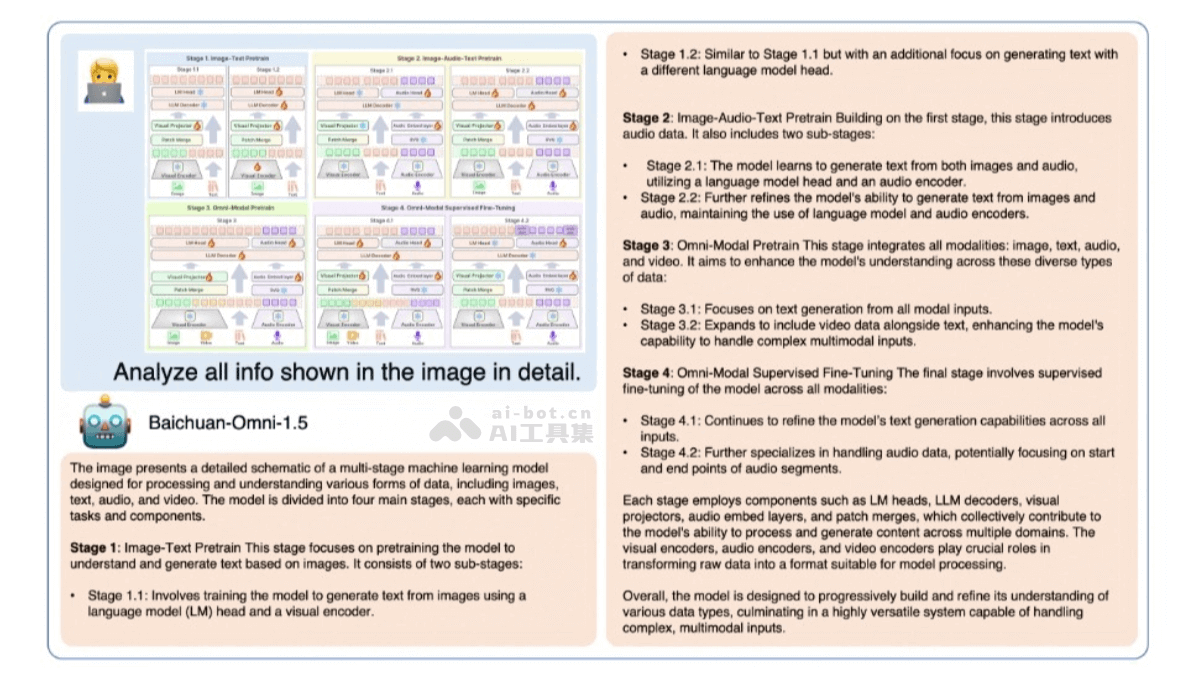
Baichuan-Omni-1.5 – 百川智能开源的全模态理解模型
Baichuan-Omni-1.5 是百川智能开源的全模态模型。支持文本、图像、音频和视频的全模态理解,具备文本和音频的双模态生成能力。模型在视觉、语音及多模态流式处理等方面表现优异,尤其在多模态医疗领域优势显著。
什么是慢感知(slow perception) – AI百科知识
慢感知(Slow Perception)是阶跃多模态团队提出的一种新型视觉感知概念,通过逐步分解和流动的方式,让模型像人类一样更精细地感知复杂的几何图形。实验中,研究人员构建了20万个合成几何图形数据样本用于训练,从中学考试中收集了480个真实几何图形用于验证和测试。
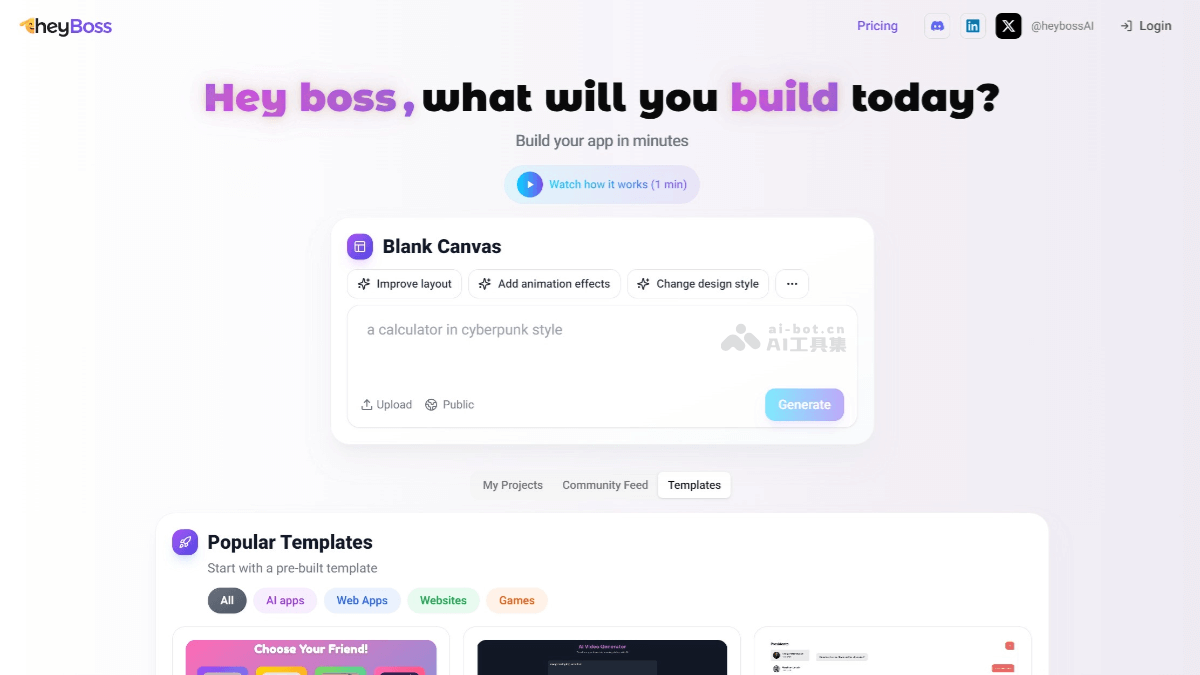
Heyboss – Heeyo 推出的 AI 编程工具
Heyboss 是 Heeyo 推出的 AI 编程工具,为“普通人的 AI 工程师”,让任何人无需编写代码即可创作 AI 应用程序、网页、网站甚至游戏。用户只需通过对话框输入想法或上传相关文件,Heyboss 能在几分钟内完成设计。
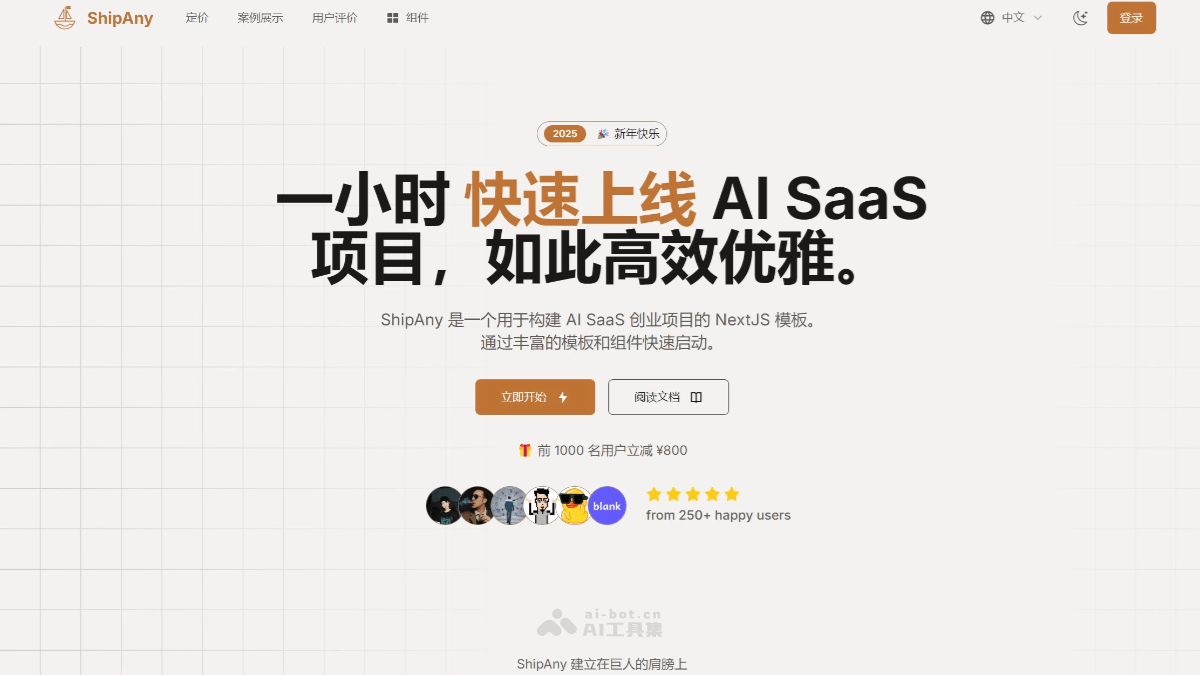
ShipAny – 专为快速构建AI SaaS项目的Next.js模板
ShipAny 是专为快速构建 AI SaaS 创业项目设计的 NextJS 模板工具。通过提供生产就绪的模板、强大的基础设施和一键部署功能,帮助开发者和创业者在几小时内完成从想法到产品的转变。
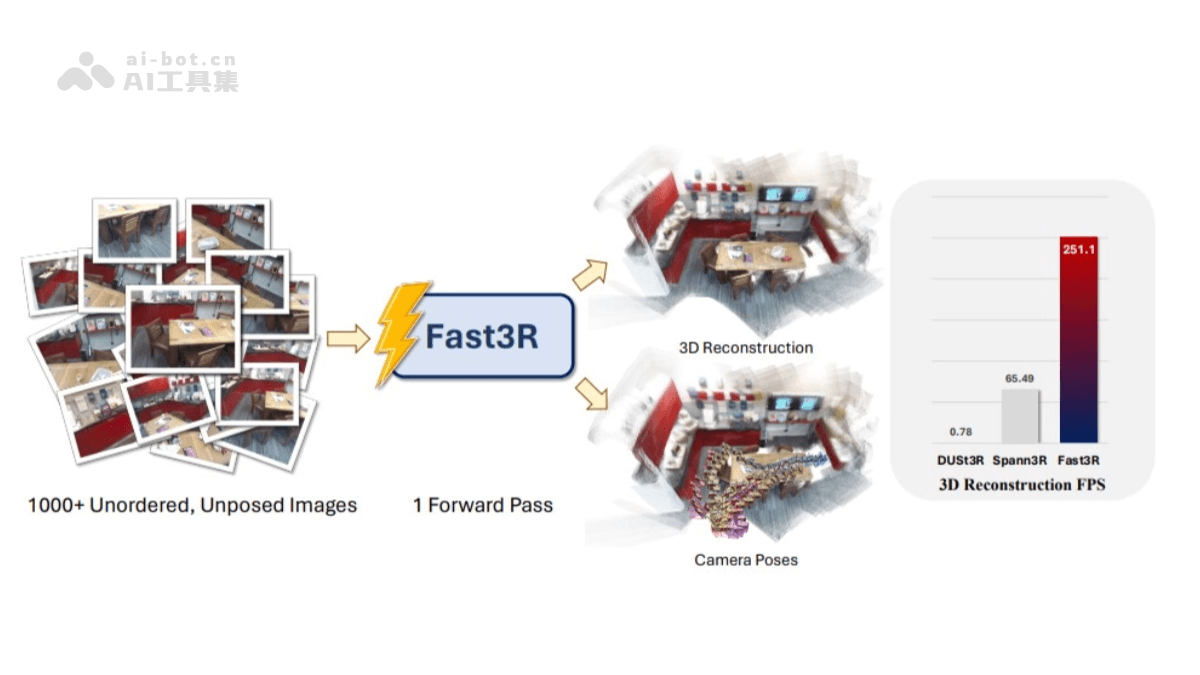
Fast3R – Meta 联合密歇根大学推出的多视图3D重建方法
Fast3R是Meta和密歇根大学的研究人员提出的新型的多视图3D重建方法,基于Transformer架构,能在一个前向传播过程中处理1000多张图像,实现高效且可扩展的3D重建。与传统方法相比,Fast3R摒弃了逐对处理图像和全局对齐的复杂步骤,通过并行处理多个视图,提高了推理速度,减少误差累积。
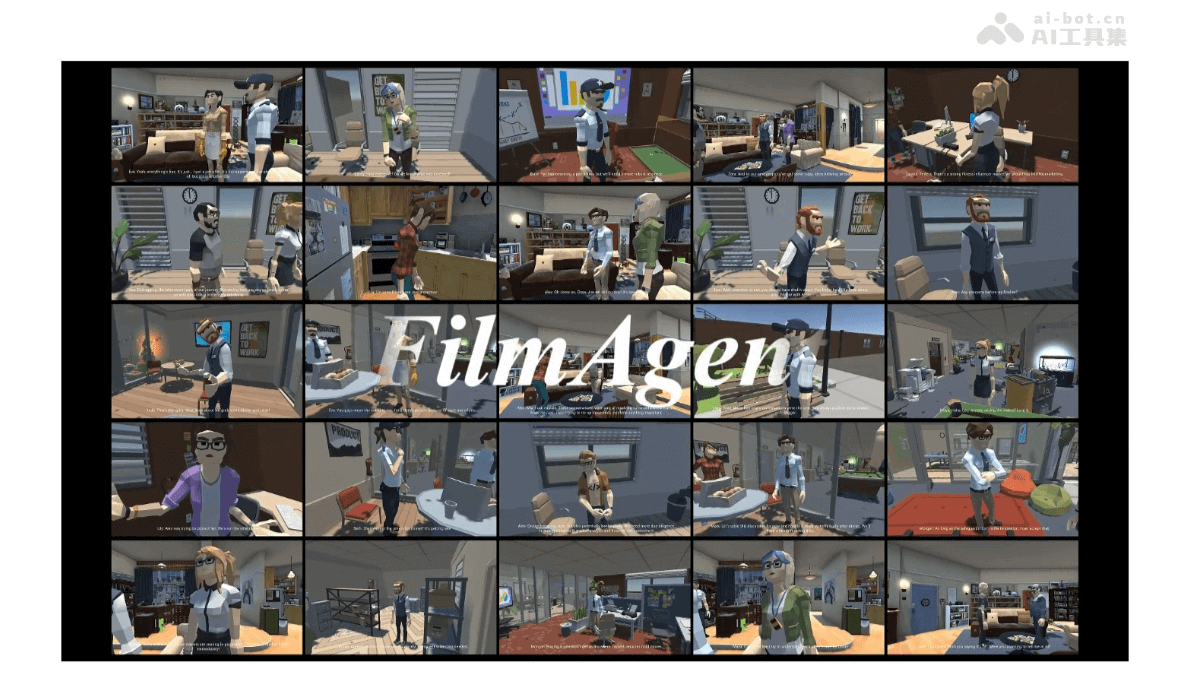
FilmAgent – 哈工大联合清华推出的AI电影自动化制作工具
FilmAgent是哈尔滨工业大学(深圳)的研究团队开发的基于多智能体协作框架的虚拟电影制作工具,通过自动化流程实现虚拟3D空间中的端到端电影制作。模拟传统电影工作室的工作流程,用多智能体协作来自动化虚拟电影的制作。
Harvey – 专为法律行业设计的生成式 AI 平台
Harvey是专为法律行业设计的生成式人工智能平台,基于 OpenAI 的 GPT-4 模型开发,为法律专业人士提供高效、精准的工具。核心功能包括法律研究、文档分析与合同审查、文档起草与编辑以及工作流自动化。
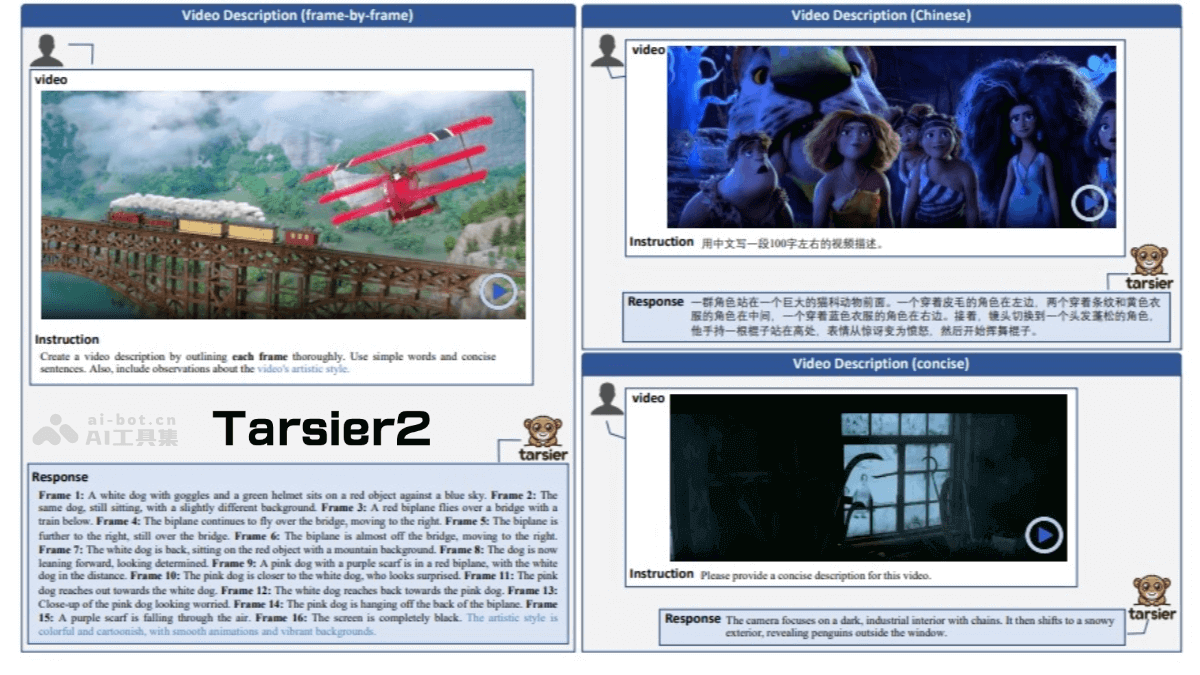
Tarsier2 – 字节跳动推出的视觉理解大模型
Tarsier2是字节跳动推出的先进的大规模视觉语言模型(LVLM),生成详细且准确的视频描述,在多种视频理解任务中表现出色。模型通过三个关键升级实现性能提升,将预训练数据从1100万扩展到4000万视频文本对,丰富了数据量和多样性;在监督微调阶段执行精细的时间对齐;基于模型采样自动构建偏好数据,应用直接偏好优化(DPO)训练。
DryMerge – AI驱动的自然语言生成任务自动化 Agent 工具
DryMerge 是创新的无代码自动化工具,通过自然语言处理简化跨应用的工作流程。用户只需用简单英语描述任务,DryMerge 可自动生成自动化流程,无需编写代码。
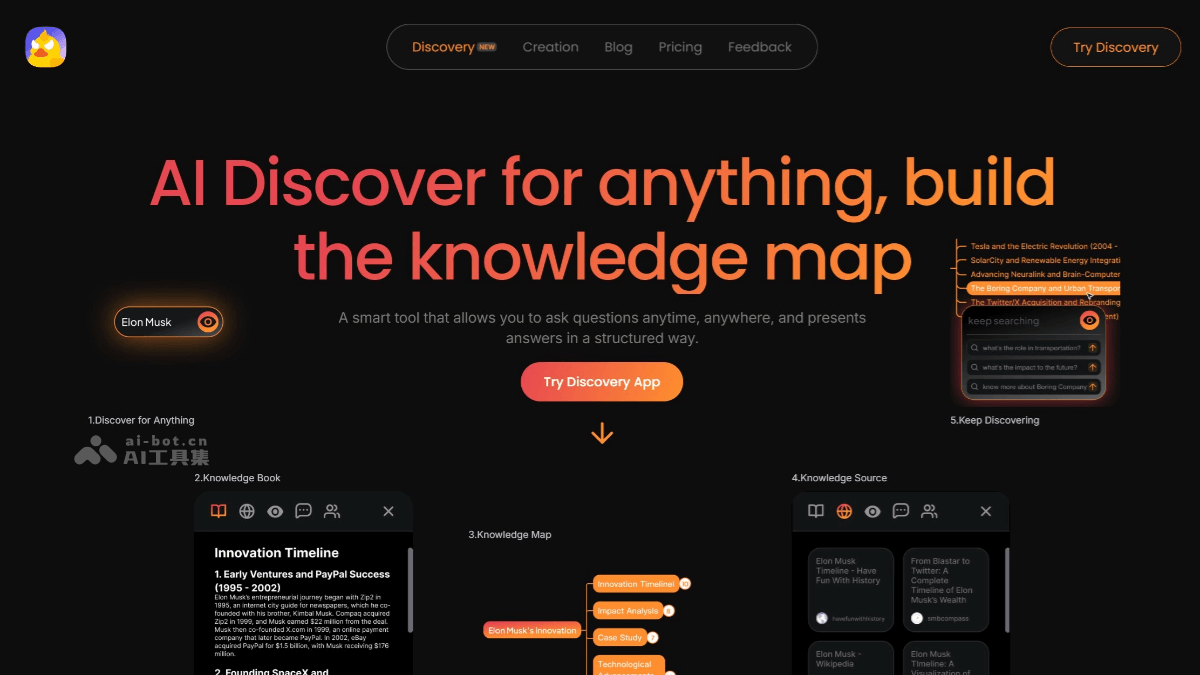
Minduck Discovery – AI思维导图搜索工具,输入关键词生成可视化导图
Minduck Discovery 是创新的AI思维导图搜索工具。通过交互式思维导图,将复杂的知识结构化呈现,帮助用户高效探索和理解信息。用户只需输入关键词,系统会生成可视化导图,点击节点即可深入相关子主题,避免信息过载。