
AI文章
读懂模型与应用的新进展,找到值得尝试的 AI 实践。
7,595篇文章,持续更新
文章列表
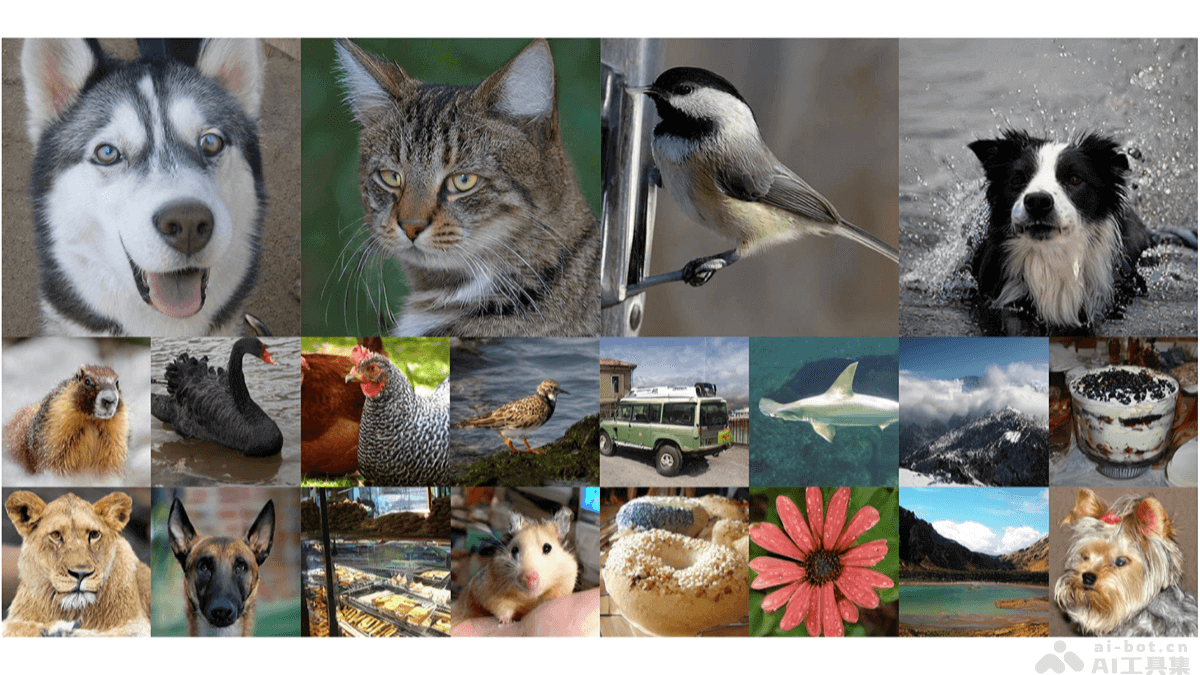
MAETok – 港大联合北大等机构推出的自动编码器
MAETok(Masked Autoencoders Tokenizer)是卡内基梅隆大学、香港大学、北京大学等机构推出的用在扩散模型的新型图像标记化方法。MAETok基于掩码建模(Mask Modeling)训练自编码器(AE),在编码器中随机掩盖部分图像标记,用解码器重建标记的特征,学习到更具区分性的语义丰富潜在空间。
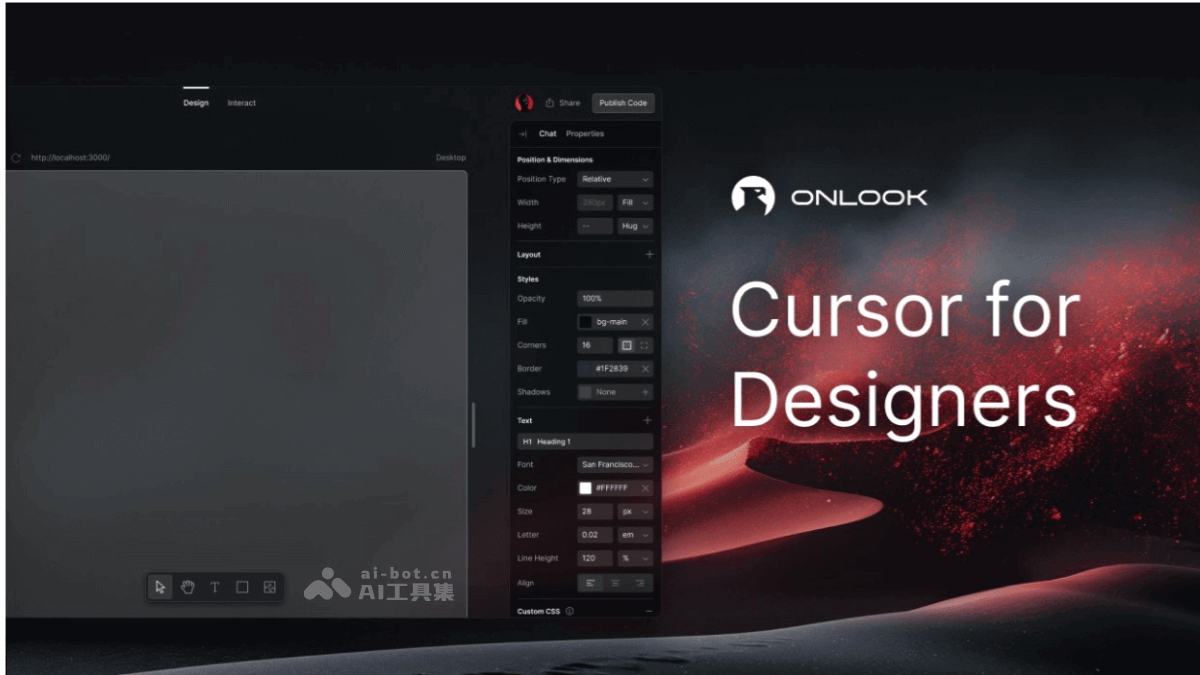
Onlook – 开源AI视觉编辑工具,设计修改自动同步代码
Onlook是开源的视觉编辑工具,专为 React 应用程序设计,帮助设计师和开发人员更高效地协作。支持用户在浏览器中直接修改 React 应用的 UI,实时查看效果,将设计更改自动同步为代码,推送到代码库。
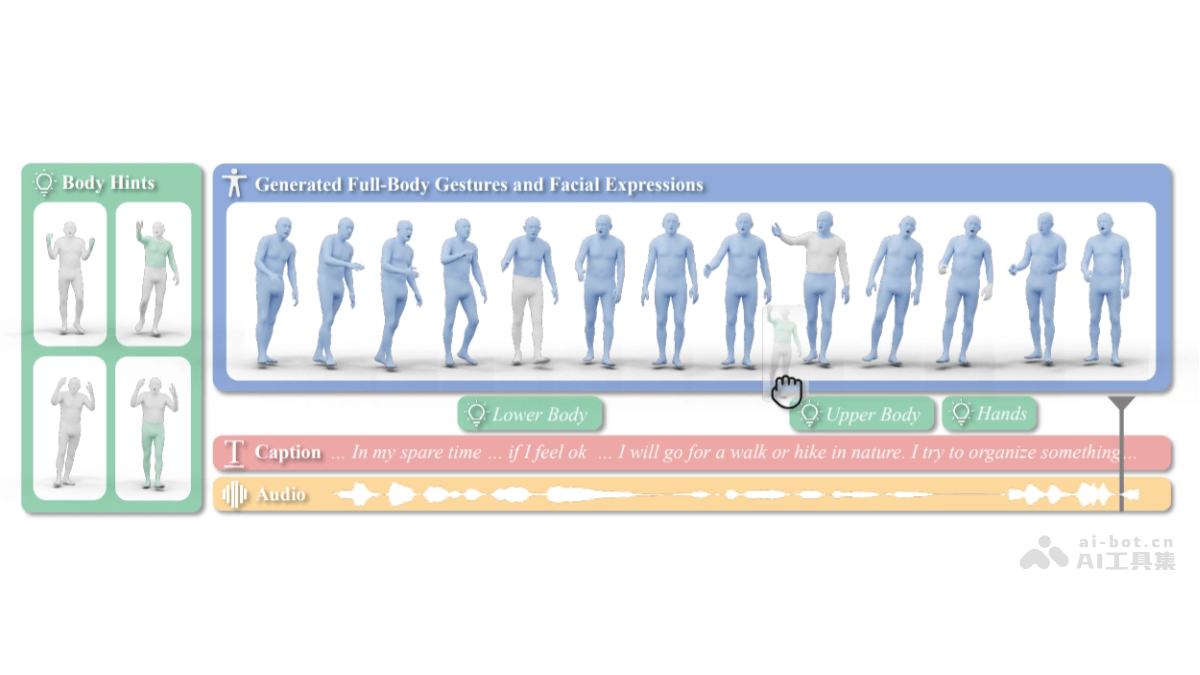
EMAGE – 清华联合东大等机构推出的音频生成全身共语手势框架
EMAGE(Expressive Masked Audio-conditioned GEsture modeling)是清华大学、东京大学、庆应义塾大学等机构推出的用在生成全身共语手势框架。EMAGE能根据音频和部分遮蔽的手势输入,生成与音频同步的完整全身手势,包括面部表情、身体动作、手势和全局运动。
Klee – AI 桌面应用,本地创建个人智能知识库
Klee是本地化的 AI 桌面应用,专注于数据安全和隐私保护。完全在用户设备上运行,不涉及云端数据传输,确保数据的隐私和安全。Klee 提供强大的 AI 功能,包括文件管理、笔记记录和任务规划,支持开源 AI 模型如 Llama 3 和 Mistral。
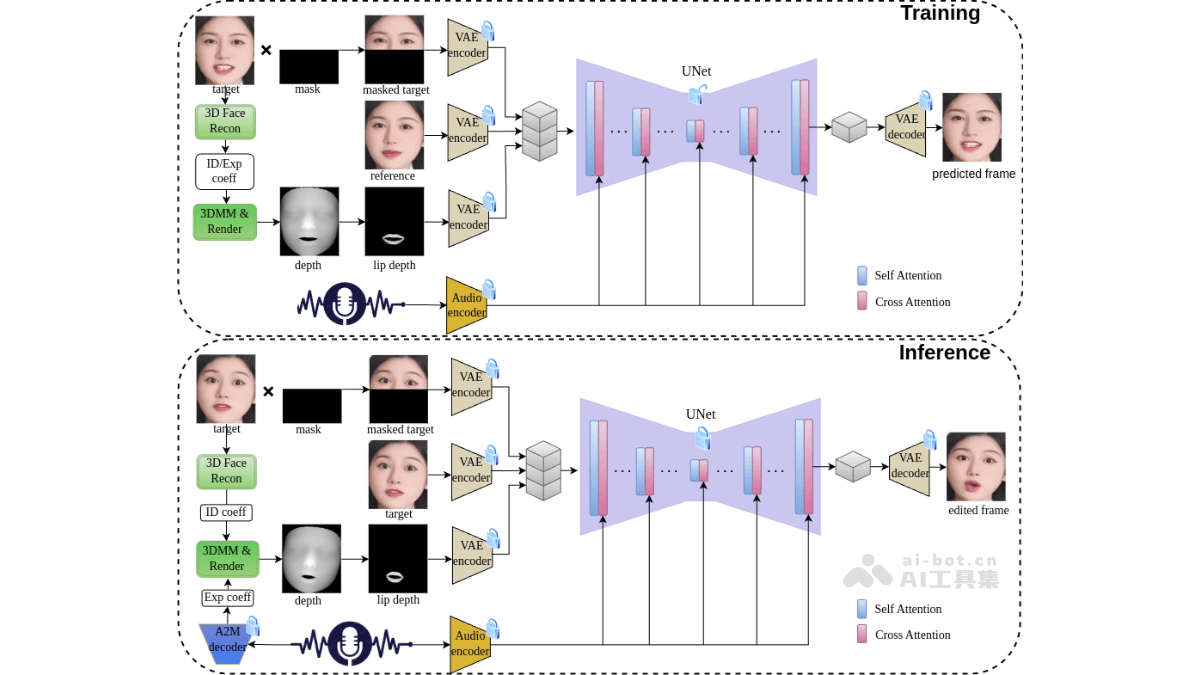
JoyGen – 京东和港大推出音频驱动的3D说话人脸视频生成框架
JoyGen是京东科技和香港大学推出的,音频驱动的3D说话人脸视频生成框架,专注于实现精确的唇部与音频同步及高质量的视觉效果。JoyGen结合音频特征和面部深度图,驱动唇部运动的生成,用单步UNet架构进行高效的视频编辑。J
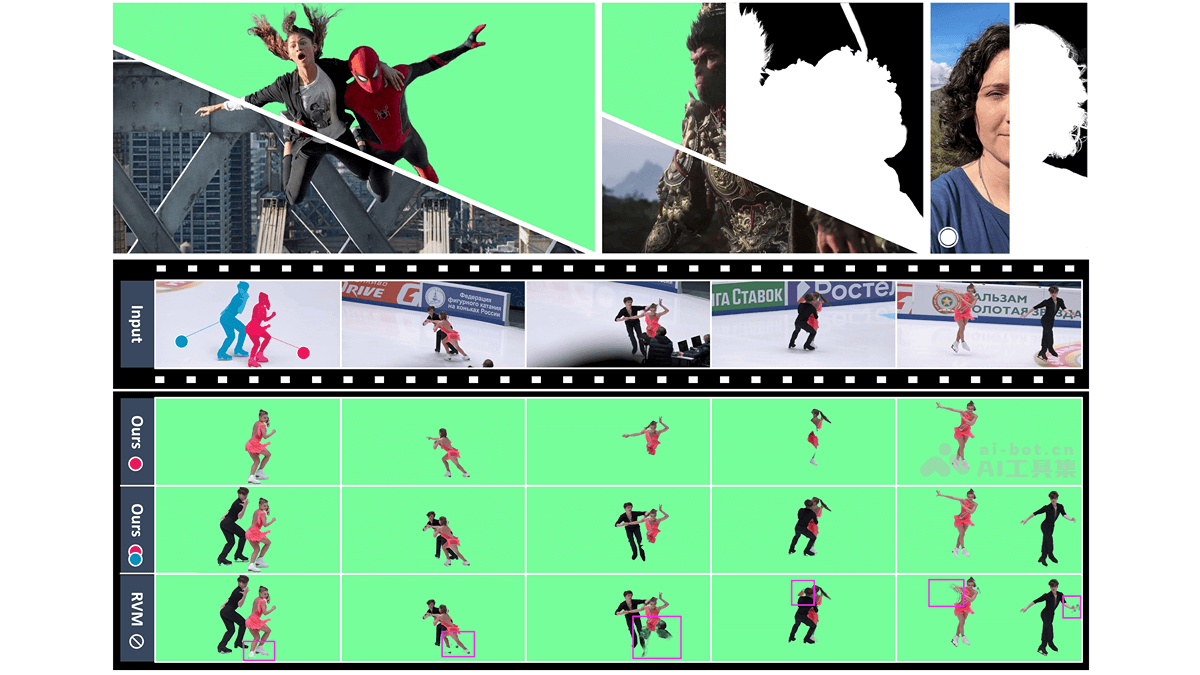
MatAnyone – 南洋理工和商汤科技推出的人像视频抠图框架
MatAnyone是南洋理工大学S-Lab实验室和商汤科技推出的,针对复杂背景人像视频抠图的先进框架,专注于目标指定的视频抠图任务。MatAnyone基于一致的内存传播模块和区域自适应内存融合技术,确保在视频序列中核心区域的语义稳定性和边界细节的精细度。
LipRead Pro – AI视频唇读工具,将视频中的唇部动作转换为文字
LipRead Pro 是基于先进 AI 技术的视频唇读工具,能将视频中的唇部动作转换为文字。采用最新的深度学习模型,支持多种语言和口音,应用于内容创作、无障碍辅助、安全监控、历史档案恢复、法医分析以及远程通信等场景。
MimicPhoto – AI照片编辑工具,能快速调整笑容、眼神等面部表情细节
MimicPhoto 是 GenAI Works 推出的 AI 驱动的照片编辑工具,专注于通过智能技术提升照片中的人物面部表情和整体效果。能快速调整笑容、眼神等细节,让照片中的人物看起来更加生动自然。
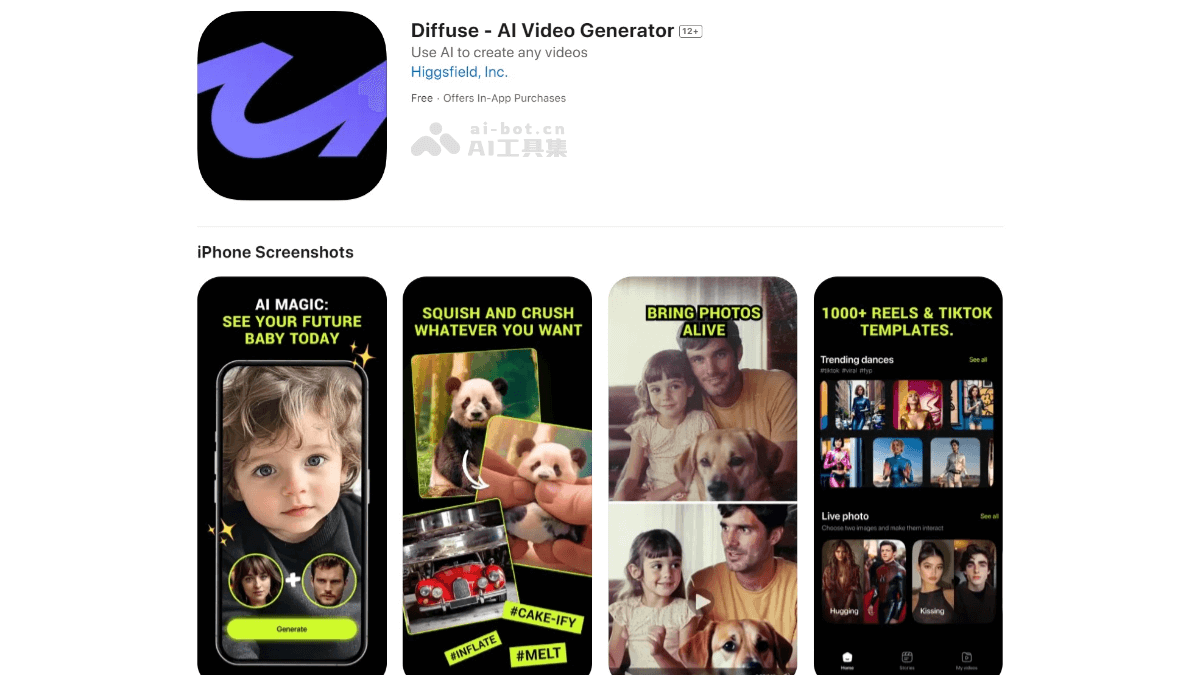
Diffuse – AI视频编辑工具,提供个性化视频生成和编辑功能
Diffuse是基于 AI 技术的视频编辑器,专注于为用户提供高效、个性化的视频生成和编辑功能。用户可以通过上传一张自拍照,生成与自己高度逼真的虚拟角色,插入到各种 AI 生成的场景中,可以模仿其他视频中的动作,如舞蹈等。
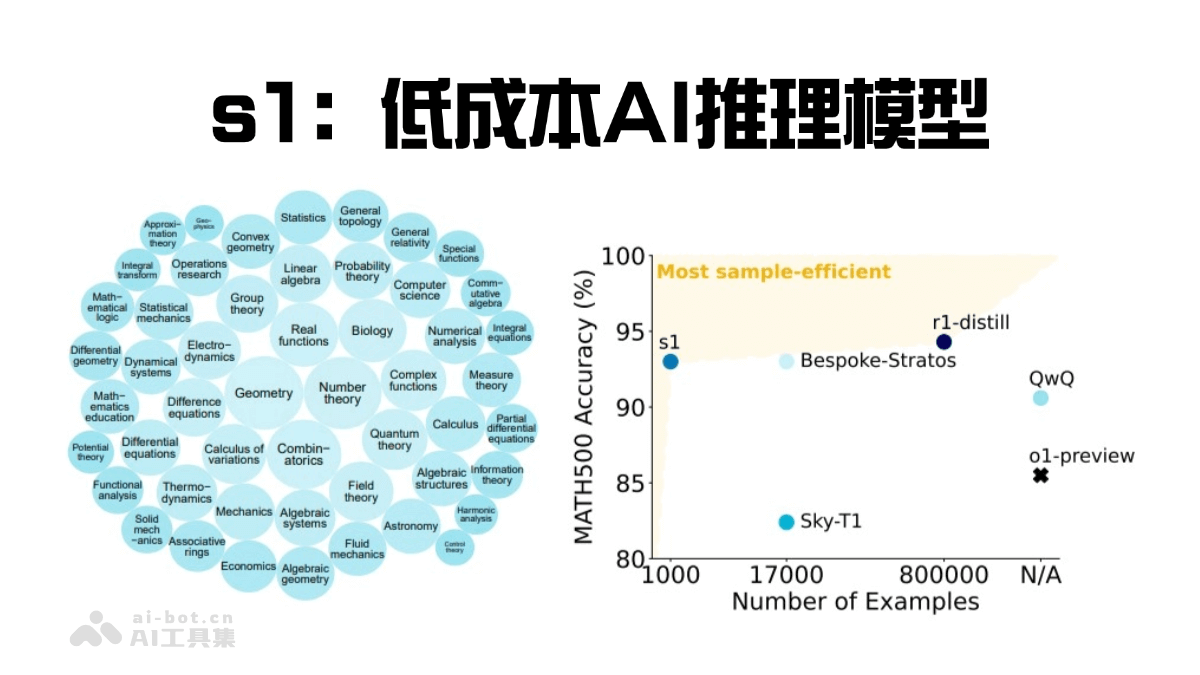
s1 – 斯坦福和华盛顿大学推出低成本、高性能的AI推理模型
s1是斯坦福大学和华盛顿大学的研究团队开发的低成本、高性能的AI推理模型。模型通过“蒸馏”技术从谷歌的Gemini 2.0 Flash Thinking Experimental模型中提取推理能力。研究人员仅使用1000个精心策划的问题及其答案进行训练,训练成本不到50美元,训练过程耗时不到30分钟。
LOOK – AI服装设计工具,手绘草图时AI同步生成视觉效果
LOOK是实时AI时尚设计工具,专为时尚设计师开发。LOOK基于先进的AIGC技术,将设计概念即时转化为视觉呈现,简化传统设计流程。设计师在Procreate中绘制草图时,基于LOOK的实时设计功能,让AI同步生成视觉效果,实时调整细节。
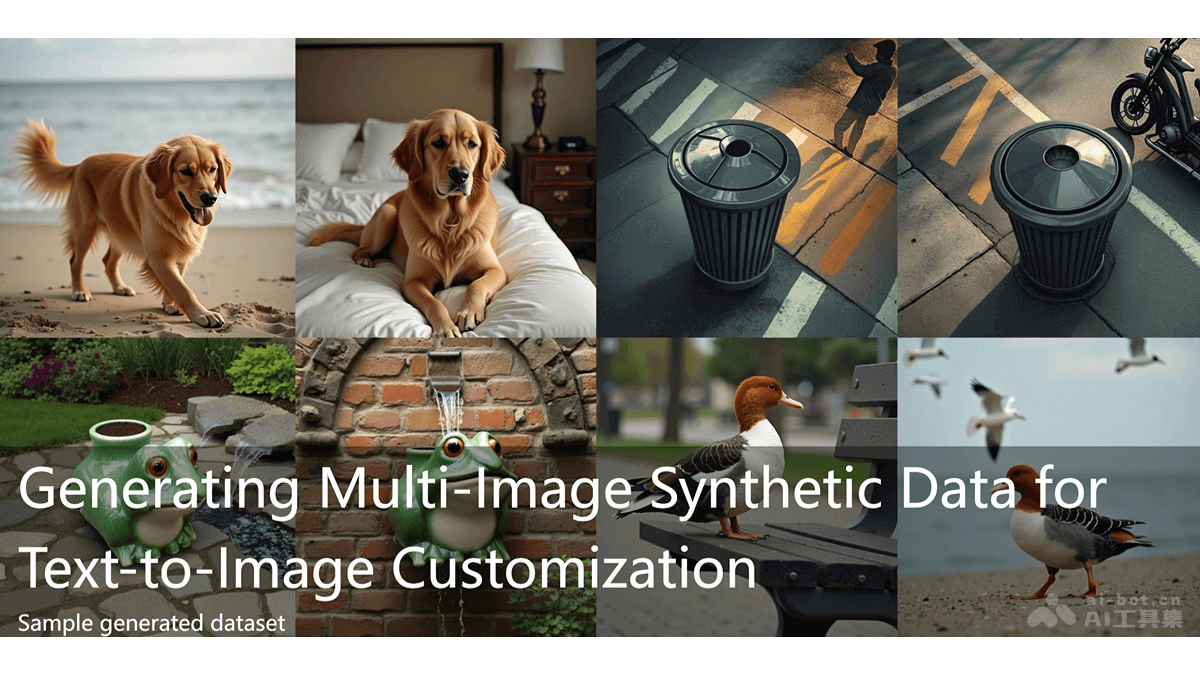
SynCD – Meta和卡内基梅隆大学开源的文生图合成训练数据集
SynCD(Synthetic Customization Dataset)是卡内基梅隆大学和Meta推出的高质量合成训练数据集,用在提升文本到图像模型的定制化能力。SynCD包含多个相同对象在不同光照、背景和姿态下的图像,基于共享注意力机制(Masked Shared Attention)和3D资产引导(如Objaverse)确保对象在不同图像中的一致性。
FluxSR – 上海交大联合华为等高校推出的图像超分辨率模型
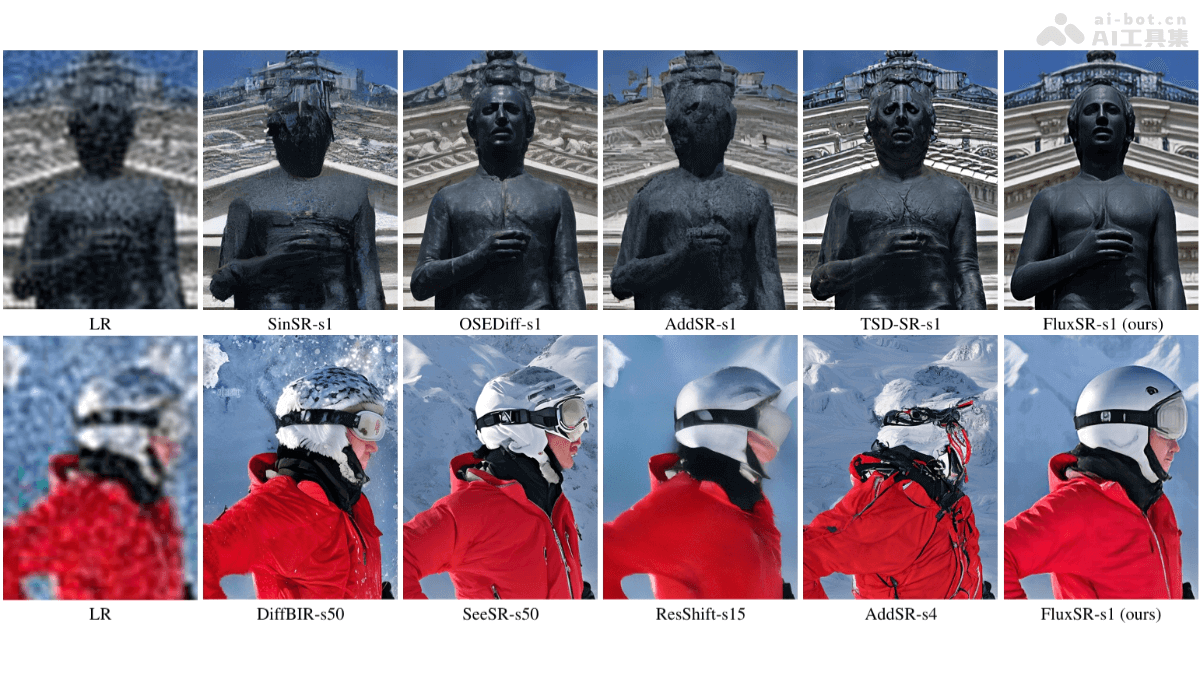
FluxSR是新型的单步扩散模型,是上海交通大学、哈佛大学、华南理工大学和华为诺亚方舟实验室推出的专门用在真实世界图像超分辨率(Real-ISR)任务。FluxSR基于FLUX.1-dev文本到图像(T2I)扩散模型,通过流轨迹蒸馏(FTD)技术将多步流匹配模型蒸馏为单步超分辨率模型。
DeepSeek交流纪要(字节内部原文)
DeepSeek做的模型,和基于transformer的模型路径基本上是一致的,没有深度学习框架等的很大区别,DeepSeek核心点是在工程能力上的创新,现在做的模型一方面是理论,另一方面是工程。
Chatbox AI – 开源的AI客户端助手,支持多种主流AI模型
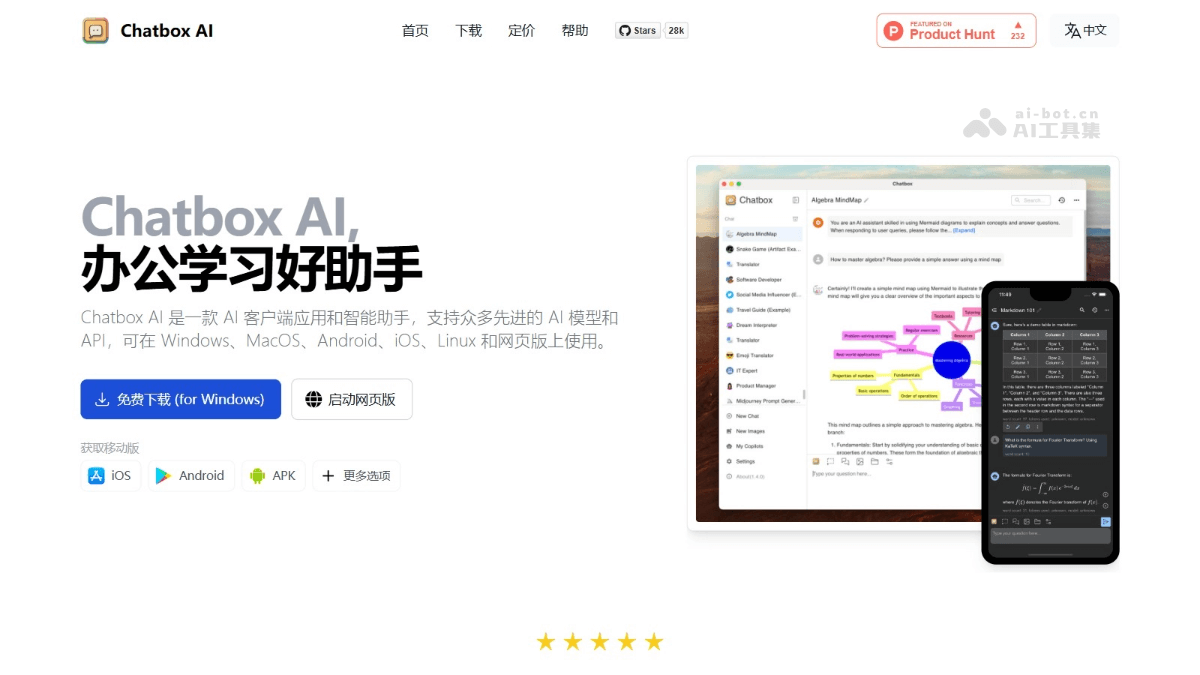
Chatbox AI是开源的跨平台AI客户端应用和智能助手,支持 Windows、Mac、Linux、iOS、Android 和网页版,集成多种先进的语言模型(如 ChatGPT、DeepSeek、Claude、Google Gemini Pro 等),支持本地模型(如 Llama2、Mistral 等)。
VideoJAM – Meta 推出增强视频生成模型运动连贯性的框架
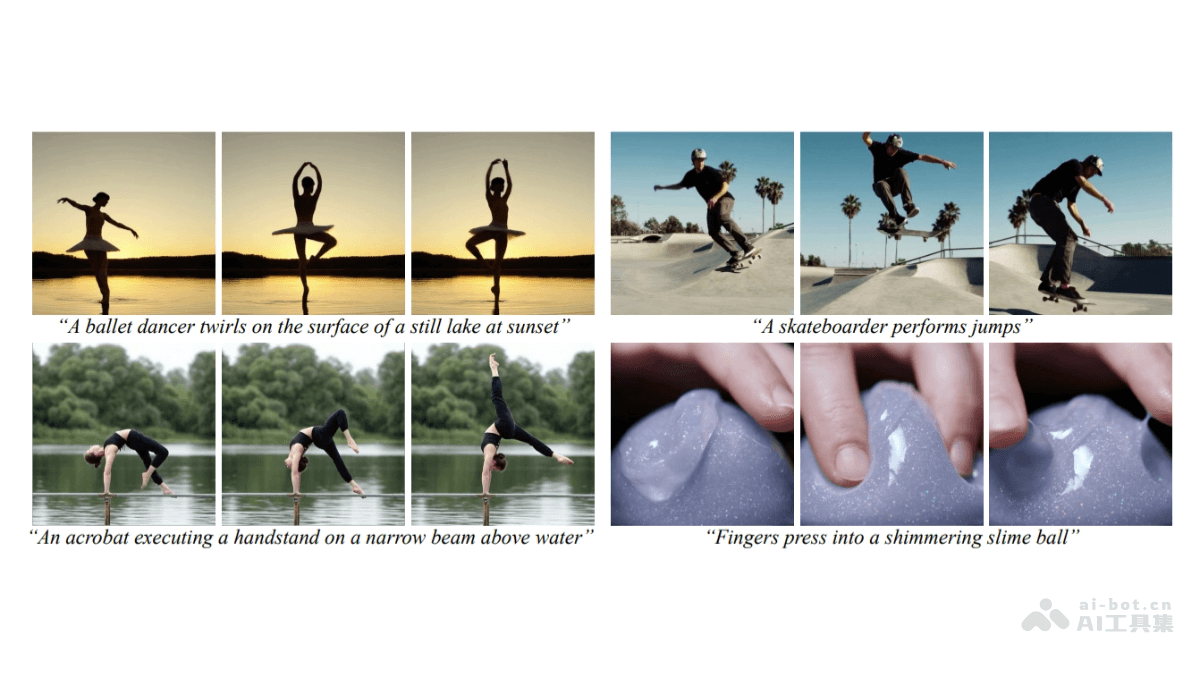
VideoJAM是Meta推出的,用在增强视频生成模型运动连贯性的框架。基于引入联合外观-运动表示,让模型在训练阶段同时学习预测视频的像素和运动信息,在推理阶段基于模型自身的运动预测作为动态引导信号,生成更连贯的运动。
清华大学DeepSeek从入门到精通(PDF文件) – AI教程资料
《DeepSeek从入门到精通》是由清华大学新闻与传播学院新媒体研究中心元宇宙文化实验室的余梦珑博士后及其团队撰写。文档的核心内容围绕DeepSeek的技术特点、应用场景、使用方法以及如何通过提示语设计提升AI使用效率等方面展开,帮助用户从入门到精通DeepSeek的使用。
RAG-FiT – 英特尔实验室推出用于开发、增强大模型的开源RAG框架
RAG-FiT(曾用名RAG Foundry)是英特尔实验室推出的开源框架,用在微调(fine-tuning)增强大型语言模型(LLMs)在检索增强生成(RAG)任务中的表现。RAG-FiT基于模块化设计,支持数据创建、训练、推理和评估四大功能模块。