
AI文章
读懂模型与应用的新进展,找到值得尝试的 AI 实践。
7,595篇文章,持续更新
文章列表
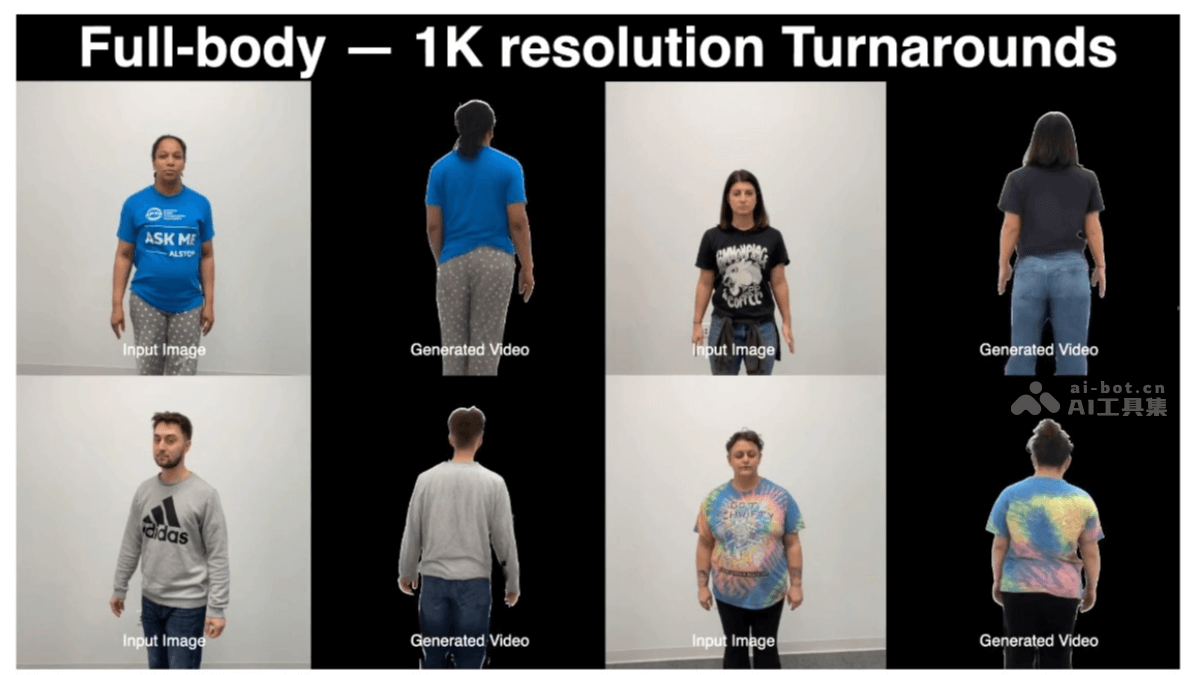
Pippo – Meta 推出的单图生成多视角高清人像视频模型
Pippo是Meta Reality Labs推出的图像到视频生成模型,能从单张照片生成1K分辨率的多视角高清人像视频。模型基于多视角扩散变换器,预训练了30亿张人像图像,在2500张工作室捕捉的图像上进行了后训练。
X-R1 – 基于强化学习的低成本训练框架
X-R1是基于强化学习的低成本训练框架,能加速大规模语言模型的后训练(Scaling Post-Training)开发。X-R1用极低的成本训练0.5B(5亿参数)规模的R1-Zero模型,仅需4块3090或4090 GPU,训练时间约1小时,成本低于10美元。
RWKV-7-2.9B – RWKV 基金开源的 RNN 大语言模型
RWKV-7-2.9B模型(RWKV-7-World-2.9B-V3) 是RWKV 基金推出的先进 RNN 大语言模型。基于 RWKV World V3 数据集训练,具有 29 亿参数,支持世界所有语言。模型兼具 Transformer 和 RNN 的优势,推理效率高,显存占用少,无 KV Cache,对硬件友好。
unsloth – 开源的大语言模型微调工具
unsloth 是开源的大语言模型(LLM)微调工具,基于优化计算步骤和 GPU 内核,显著提升模型训练速度减少内存使用。Unsloth支持多种主流 LLM,如 Llama-3、Mistral、Phi-4 等,在单 GPU 上实现最高 10 倍、多 GPU 上最高 32 倍的加速效果,同时内存使用减少 70% 以上。
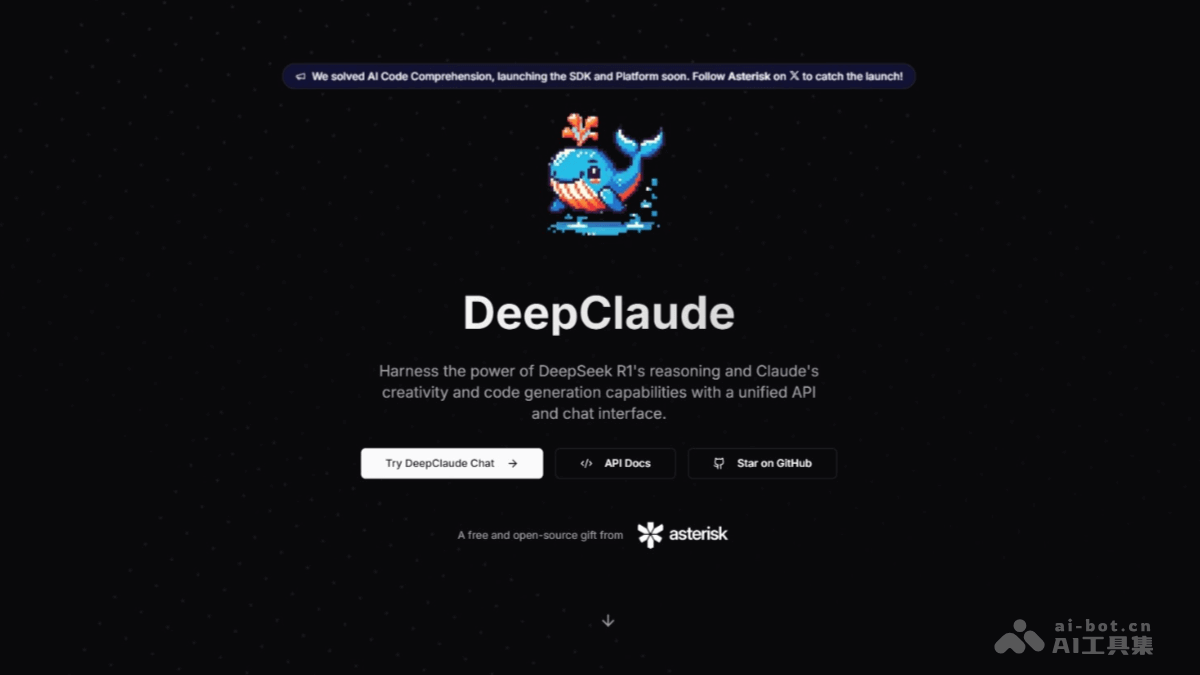
DeepClaude – 开源AI应用开发平台,深度集成 DeepSeek R1 和 Claude 模型
DeepClaude 是高性能的开源 AI 工具,基于深度集成 DeepSeek R1 和 Claude 两大模型,结合推理、创造力和代码生成能力。DeepClaude提供零延迟的即时响应,支持端到端加密和本地 API 密钥管理,确保用户数据安全。DeepClaude 高度可配置,用户能自定义 API 和界面,满足多样化需求。
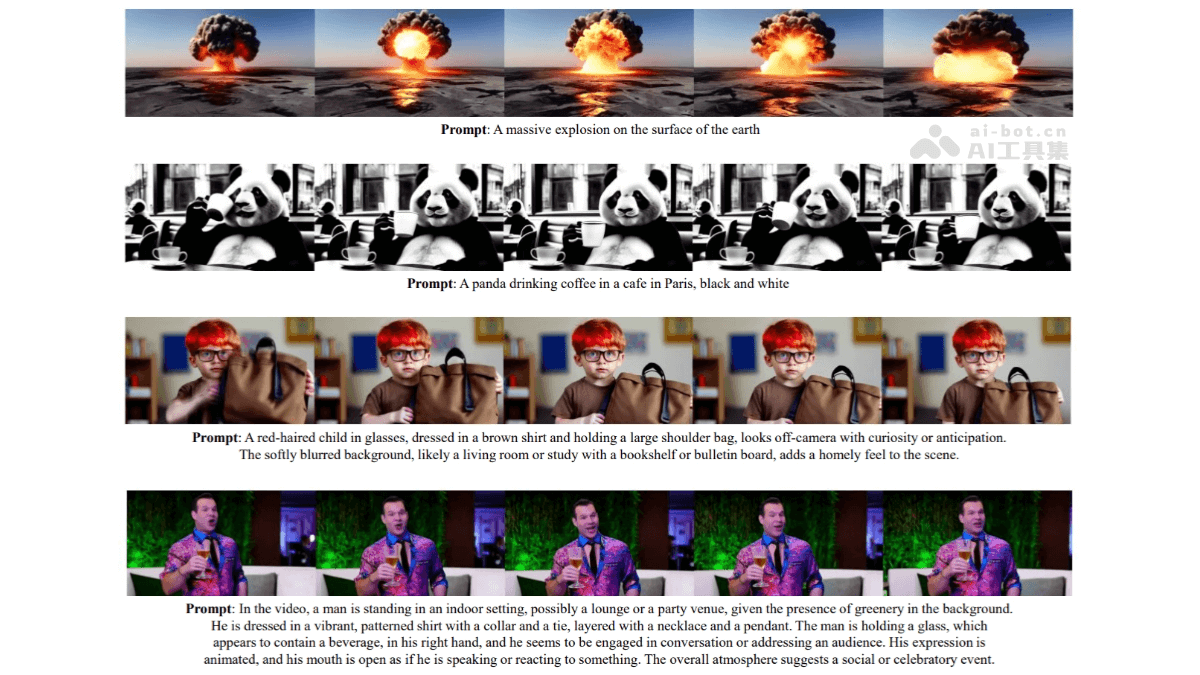
Lumina-Video – 上海 AI Lab 和港中文推出的视频生成框架
Lumina-Video是上海 AI Lab 和香港中文大学推出的视频生成框架,基于Next-DiT架构,针对视频生成中的时空复杂性进行优化。基于多尺度Next-DiT架构,用不同大小的patchify层提升效率和灵活性,基于运动分数作为条件输入,直接控制生成视频的动态程度。
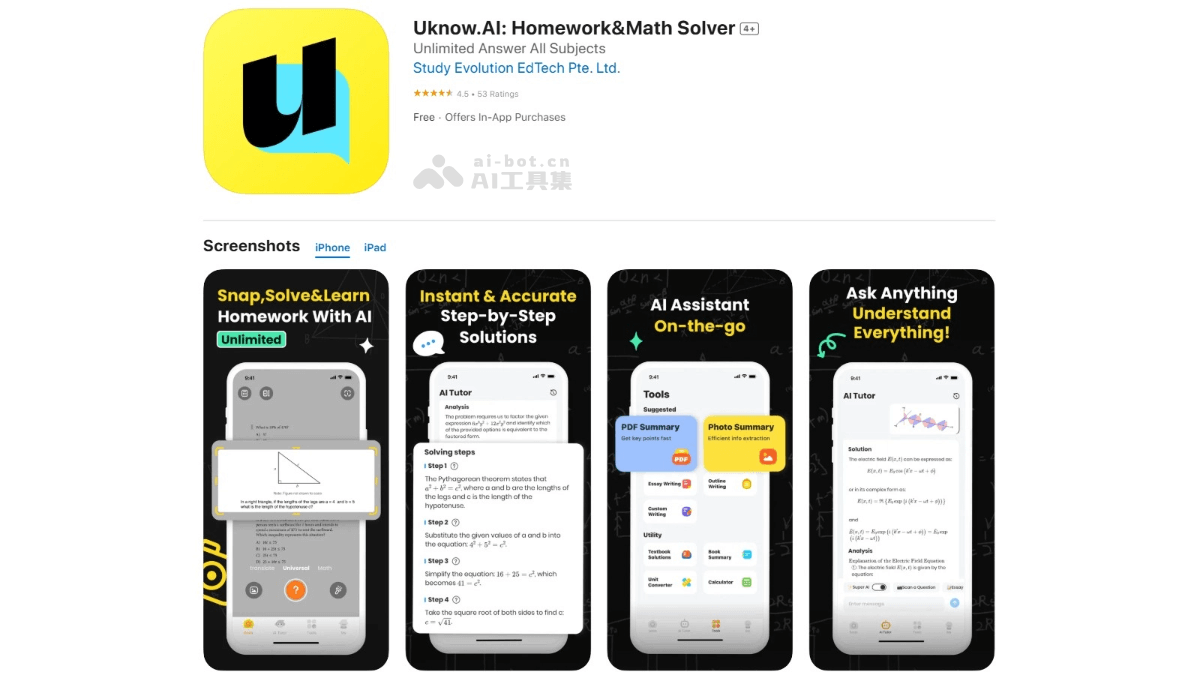
Uknow.AI – AI学习辅助工具,提供拍照搜题、作业检查等多学科学习
Uknow.AI (原CheckMath)是面向学生的AI学习辅助工具,基于AI技术提供拍照搜题、作业检查、智能计算器等功能,支持多种数学题型的批改和解析。Uknow.AI涵盖数学,支持多学科学习,提供错题回顾和视频讲解等特色功能,帮助学生高效解决学习难题,提升学习效率。
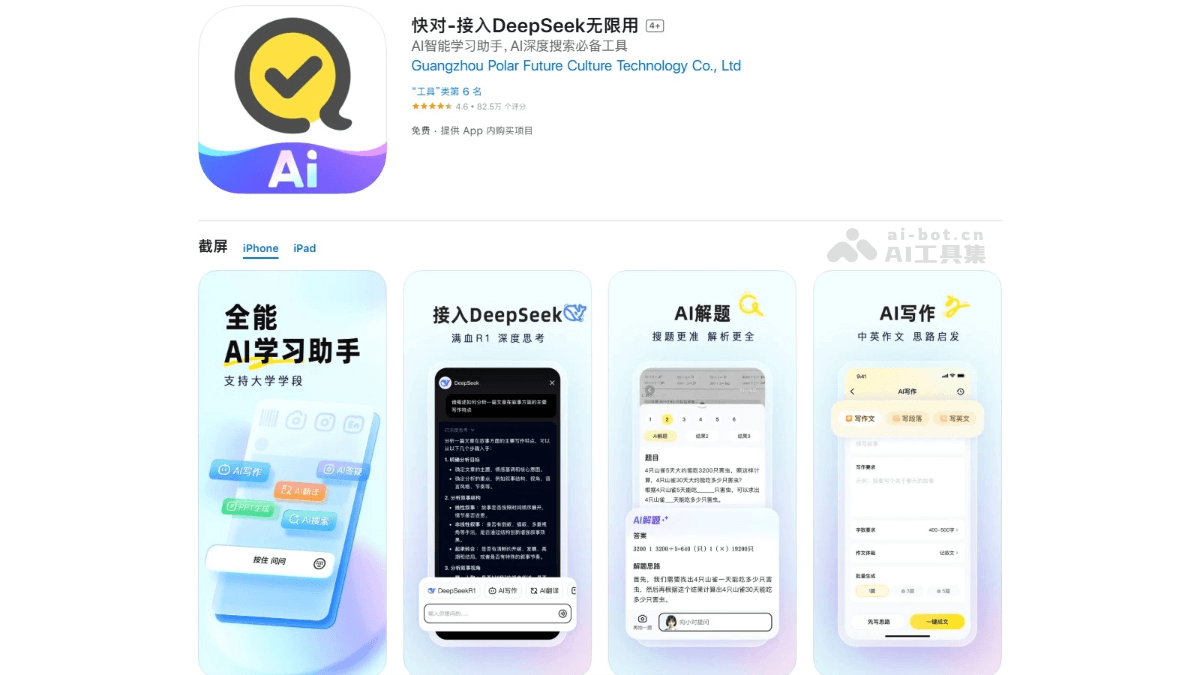
快对 – AI学习助手,提供小学至大学全学科的教辅解析
快对是集AI深度搜索与智能学习辅助功能于一体的应用。快对主要面向学生和家长,提供小学至大学全学科的教辅解析、视频讲题、作业检查、错题整理、英语翻译等功能,帮助用户高效解决学习难题。快对基于智能错题本、拍照翻译、视频讲解等特色功能,快对致力于提升学习效率,优化学习体验。
Quizbot – AI教育助手,智能生成多种问题类型和测验
Quizbot 是基于AI技术的问题生成工具,能从 PDF、Word 文档、视频、图片、网页链接等多种格式的文件中快速生成不同类型的问题,如选择题、填空题、判断题、匹配题等。Quizbot支持多语言输出,提供抄袭检测、AI 内容检测和文本重写功能,具备游戏化设计,提高用户参与度。
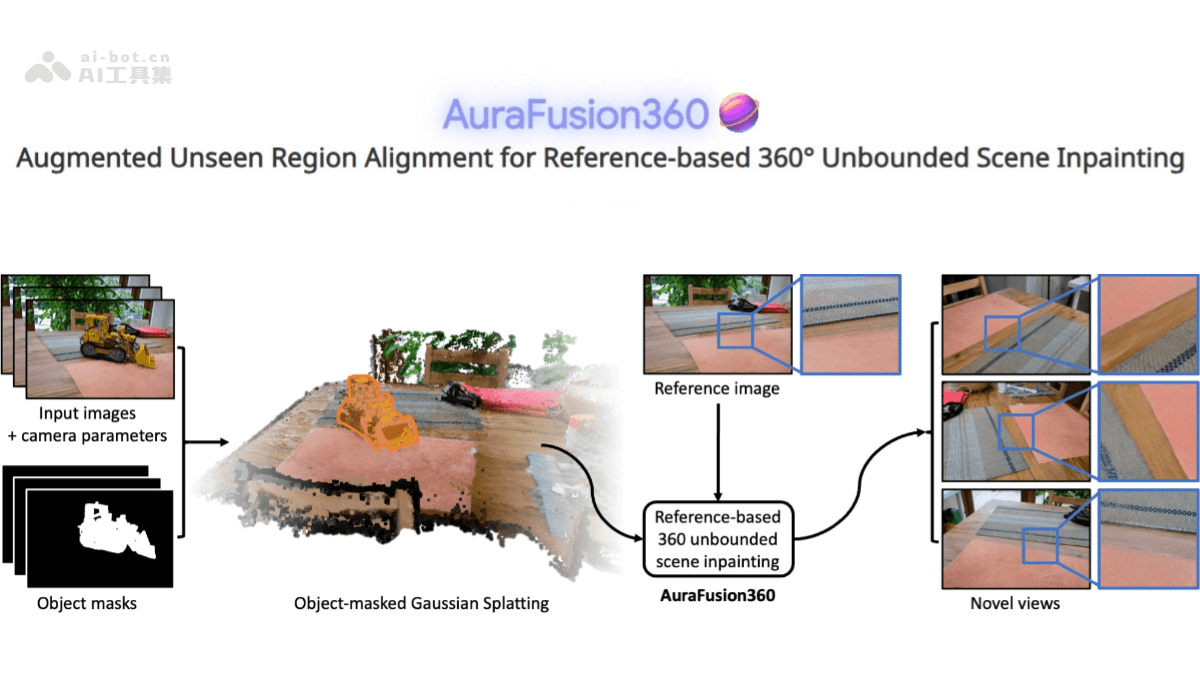
AuraFusion360 – 三维场景修复技术,实现高质量物体去除和孔洞填充
AuraFusion360是用于360°无边界场景修复的新型基于参考的方法,主要用于虚拟现实和建筑可视化等领域的三维场景修复。通过高斯散射表示的3D场景,实现了高质量的物体去除和孔洞填充。
ImageToVideo AI – AI图像转视频工具,自动分析图像生成有故事性的视频。
ImageToVideo AI是基于人工智能技术将静态图像转换为动态视频的工具。通过分析图像内容结合用户提供的文本提示或指令,为图像添加动画效果、转场效果、背景音乐等元素,生成具有一定视觉效果和故事性的视频。
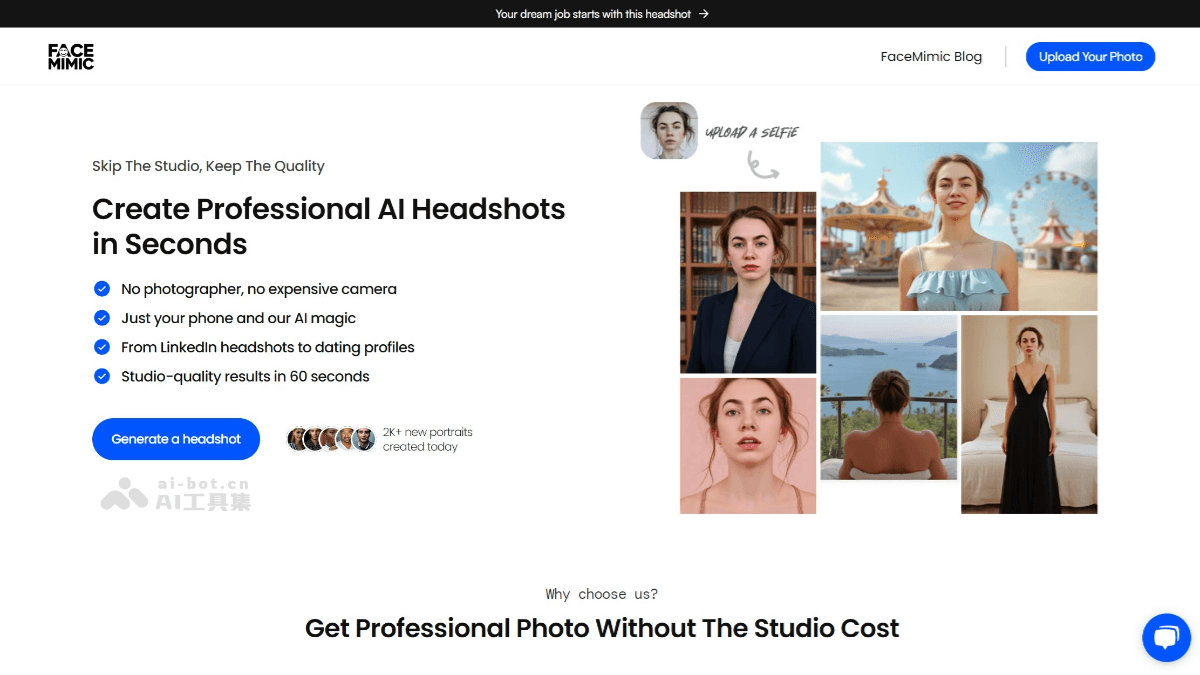
FaceMimic – 在线AI头像生成工具,60秒内将普通照转为高质量专业头像
FaceMimic是基于人工智能技术的在线头像生成工具。能将普通自拍照片快速转换为高质量的专业头像。用户只需上传一张自拍,选择所需的风格,系统能在短时间内生成清晰自然的头像,保留个人面部特征的同时,提供多种风格选项,如专业商务风、艺术风等,满足不同场景需求。
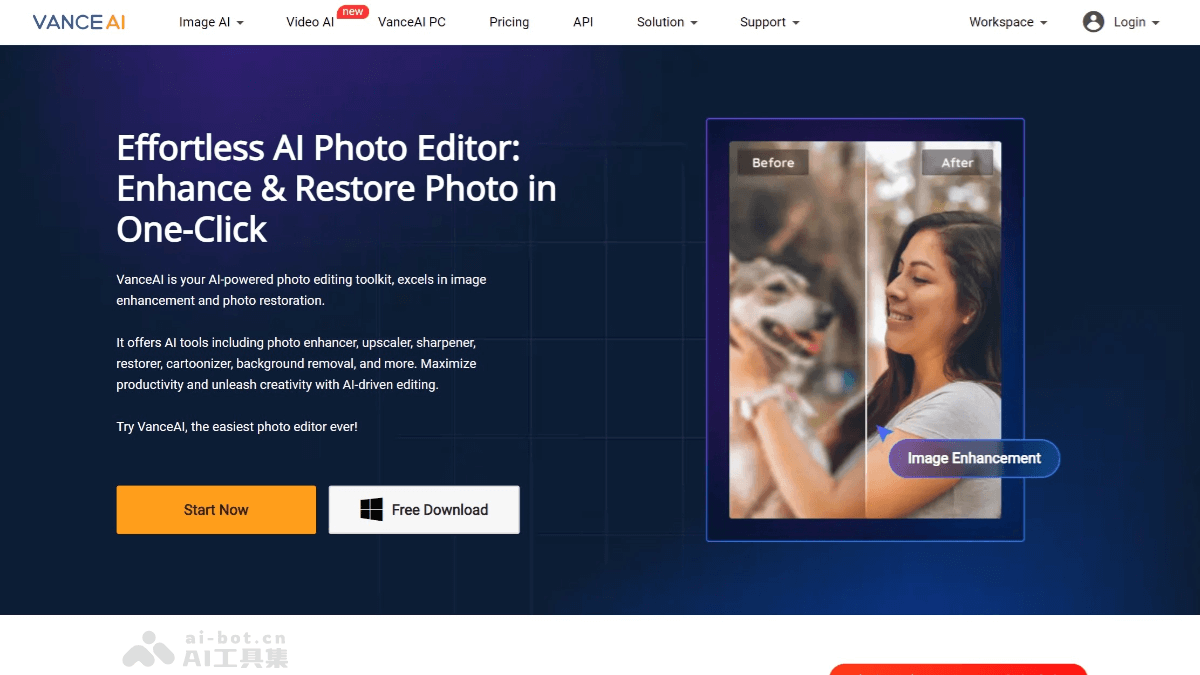
VanceAI – AI图像处理工具,支持图像增强、放大、去噪、锐化等功能
VanceAI 是基于人工智能技术的智能图像处理工具,专注于为用户提供高效、便捷的照片增强、修复与编辑服务。通过深度学习技术,能一键提升照片质量,包括图像增强、放大、去噪、锐化等功能,能自动修复老照片为其上色,支持将照片转换为卡通风格。
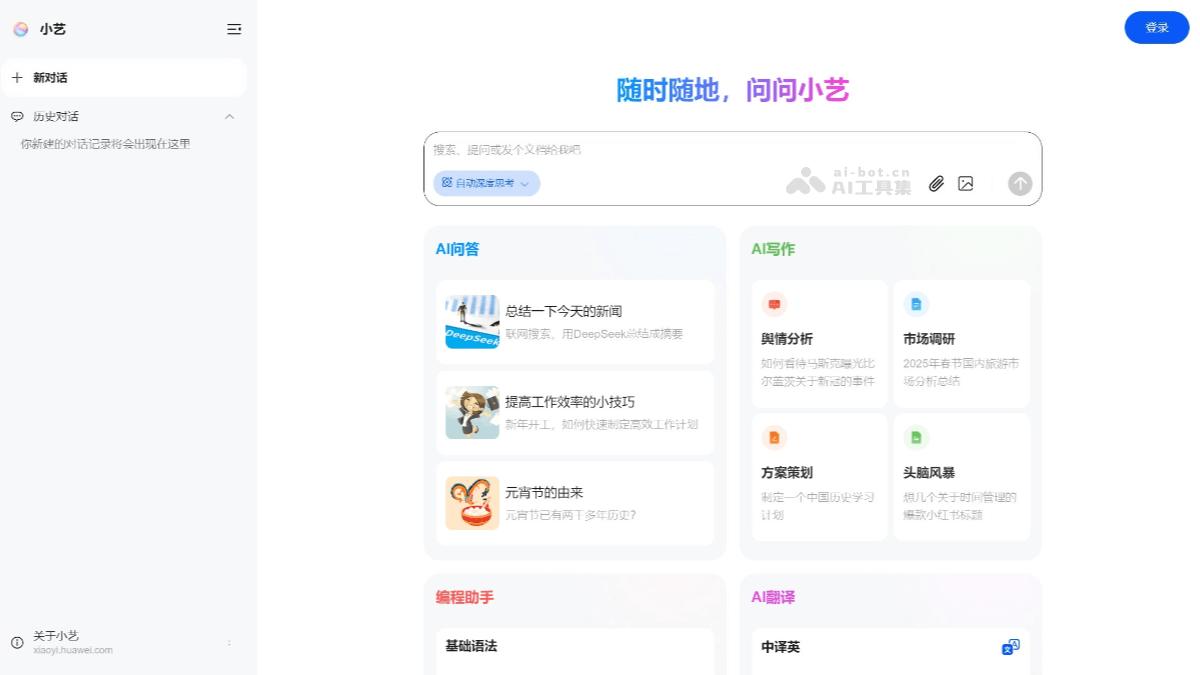
华为小艺 – 华为旗下小艺AI助手网页端,已接入DeepSeek-R1
华为小艺是华为推出的小艺AI助手网页端,用户可以通过浏览器直接访问使用。适配了手机和PC布局,提供多种功能,包括AI问答、AI写作、编程助手和AI翻译等。小艺助手网页端已接入了DeepSeek-R1智能体,支持联网搜索功能,能实时获取最新信息,为用户提供更智能、更精准的交互体验。
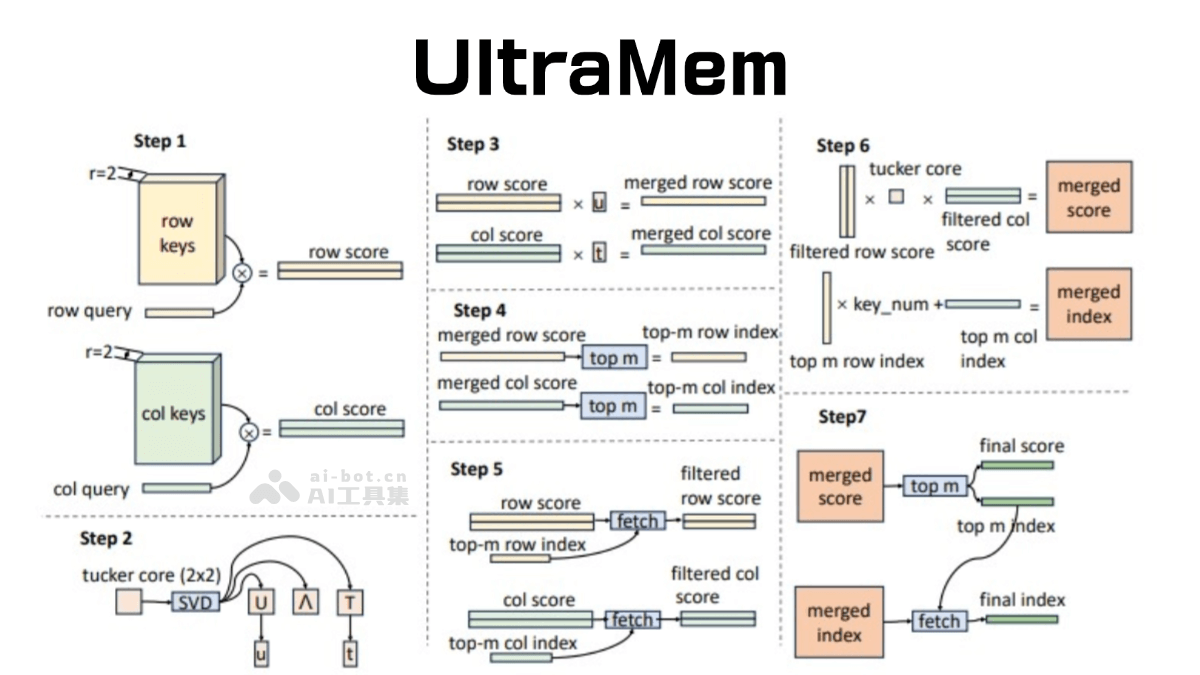
UltraMem – 字节豆包大模型团队推出的全新超稀疏模型架构
UltraMem 是字节跳动豆包大模型团队提出的全新超稀疏模型架构,解决传统 MoE 架构在推理时的高额访存问题。架构通过优化内存访问和计算效率,显著降低推理成本,推理速度较 MoE 提升了2-6倍,成本最高可降低83%。
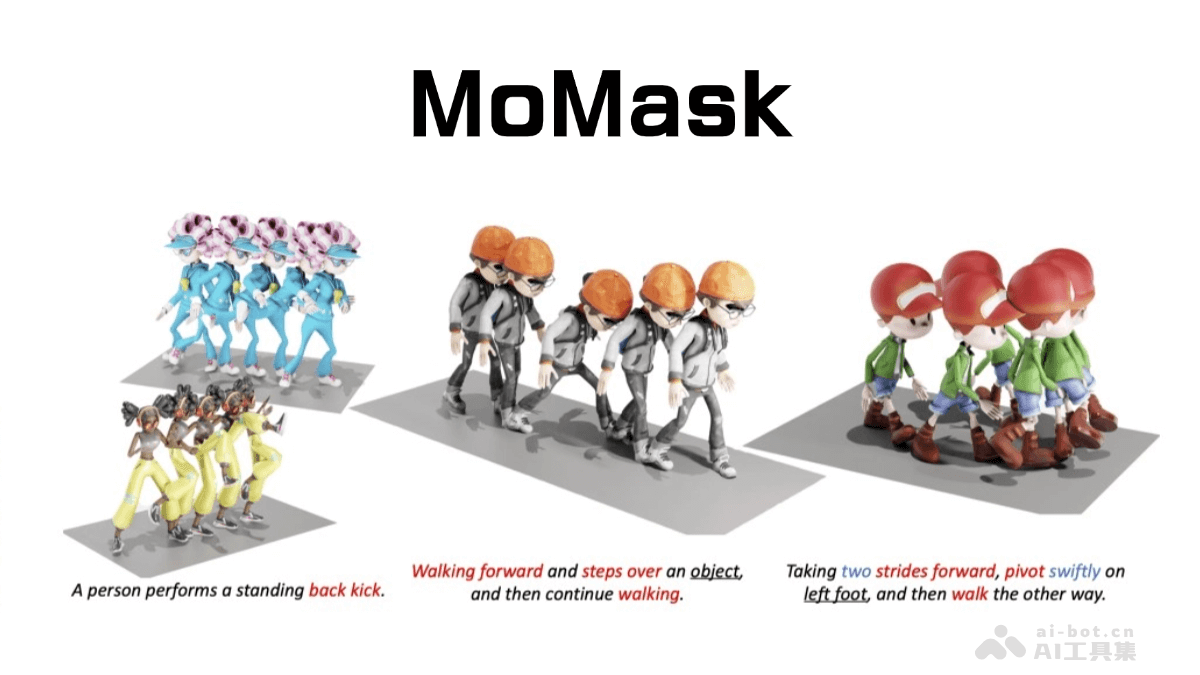
MoMask – 文本驱动生成高质量3D人体动作的模型
MoMask是创新的3D人体动作生成工具,通过生成式掩码建模技术,能根据文本描述生成高质量的3D人体动作。MoMask采用分层量化方案,将人体运动表示为多层离散的运动标记,结合掩码Transformer和残差Transformer来生成动作序列。
清华大学DeepSeek如何赋能职场应用(PDF文件) – AI教程资料
人工智能(AI)技术正以前所未有的速度改变着职场的面貌。从自动化流程到智能决策支持,AI工具已经成为提升工作效率和创新能力的关键因素。DeepSeek作为一款前沿的AI工具,凭借其强大的功能和灵活的应用场景,正在成为职场人士的新宠。本文将深入介绍DeepSeek如何赋能职场,帮助读者从入门到精通,掌握其在实际工作中的应用技巧。
ProtGPS – 麻省理工学院等机构推出的蛋白质语言模型
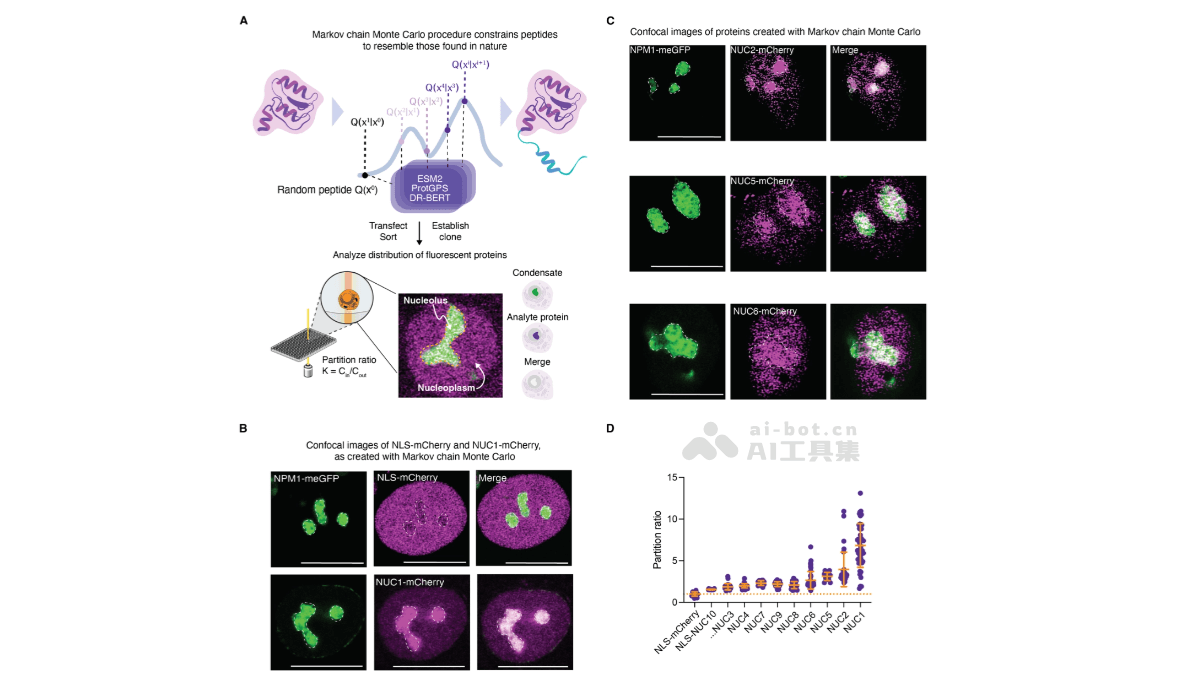
ProtGPS(Protein Localization Prediction Model)是麻省理工学院(MIT)和怀特黑德生物医学研究所推出的,基于深度学习的蛋白质语言模型,用在预测蛋白质在细胞内的亚细胞定位。ProtGPS基于分析蛋白质的氨基酸序列,用进化尺度的蛋白质变换器(Transformer)架构学习序列中的复杂模式和相互关系。