
AI文章
读懂模型与应用的新进展,找到值得尝试的 AI 实践。
7,595篇文章,持续更新
文章列表
Step-Audio – 阶跃星辰开源的语音交互模型
Step-Audio是阶跃星辰团队推出的首个产品级的开源语音交互模型,能根据不同的场景需求生成情绪、方言、语种、歌声和个性化风格的表达,能和用户自然地进行高质量对话。Step-Audio基于130B参数的统一模型,将语音理解与生成相结合,支持语音识别、对话、语音合成等功能。
Omnitool – 开源 AI 桌面,支持多种主流AI平台和服务
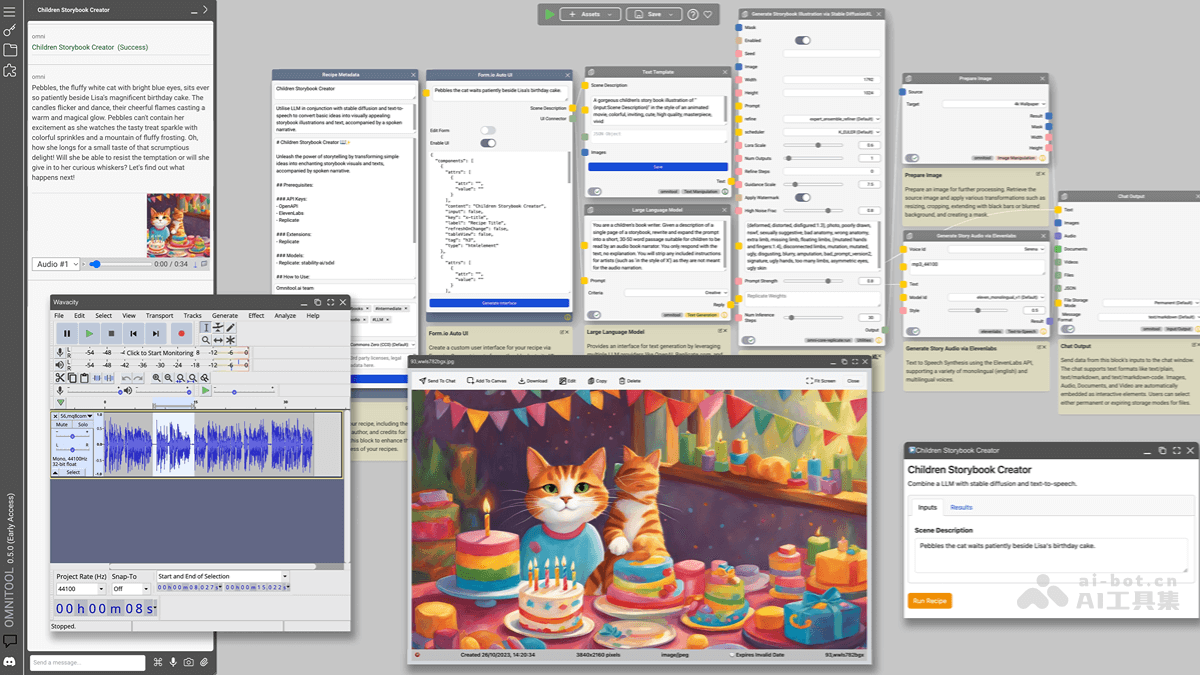
Omnitool是开源的AI桌面环境,为用户提供统一的交互界面,能快速接入和使用多种AI模型。Omnitool支持本地运行,能在Mac、Windows或Linux设备上安装,数据存储在本地,保障隐私安全。基于集成OpenAI、Stable Diffusion、Hugging Face等主流AI平台,用户无需复杂配置或学习API文档,即可快速生成图像、翻译文本、创建音频等。
超算互联网 – 科技部指导推出的国家级算力服务平台
超算互联网是科技部指导推出的国家级算力服务平台,整合全国超算、智算等算力资源,实现算力的统筹与调度。超算互联网基于提供算力、应用、数据、生态和社区等一站式服务,推动算力的普惠化和易用性。
Matrix3D – 南大联合Apple、港科大推出的统一摄影测量模型
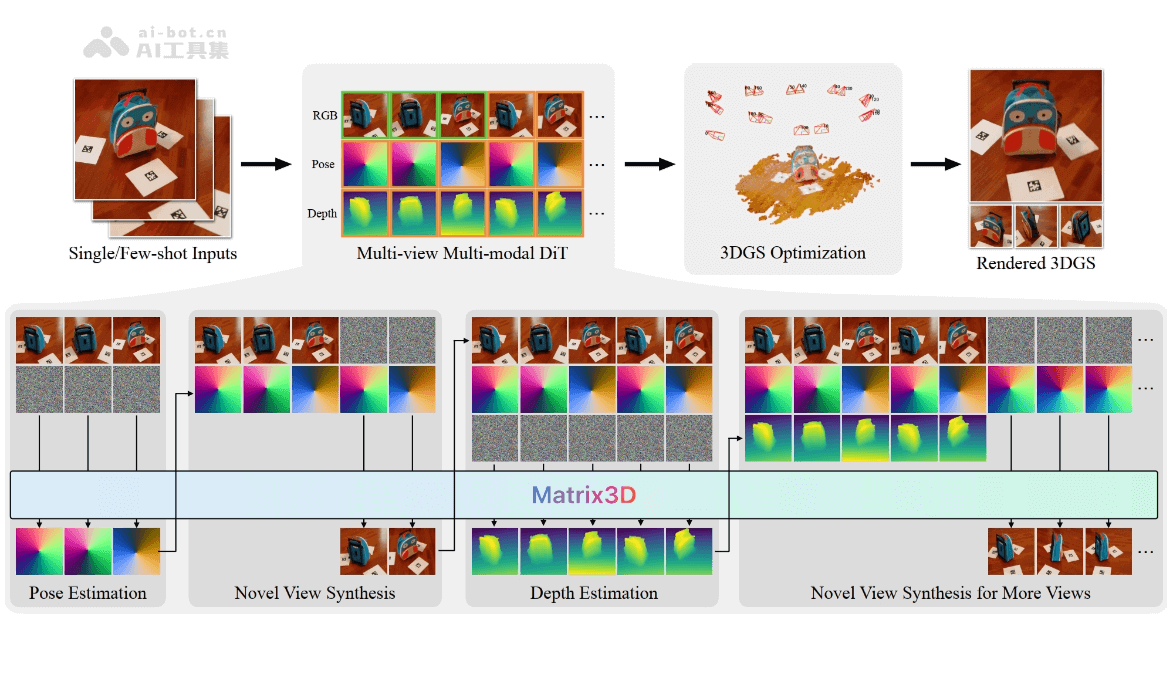
Matrix3D 是南京大学、苹果公司和香港科技大学合作推出的新型的统一摄影测量模型,能在一个模型中完成多个摄影测量子任务,包括姿态估计、深度预测和新视图合成。Matrix3D 的核心是多模态扩散变换器(DiT),通过整合图像、相机参数和深度图等多种模态的数据,实现灵活的任务处理。
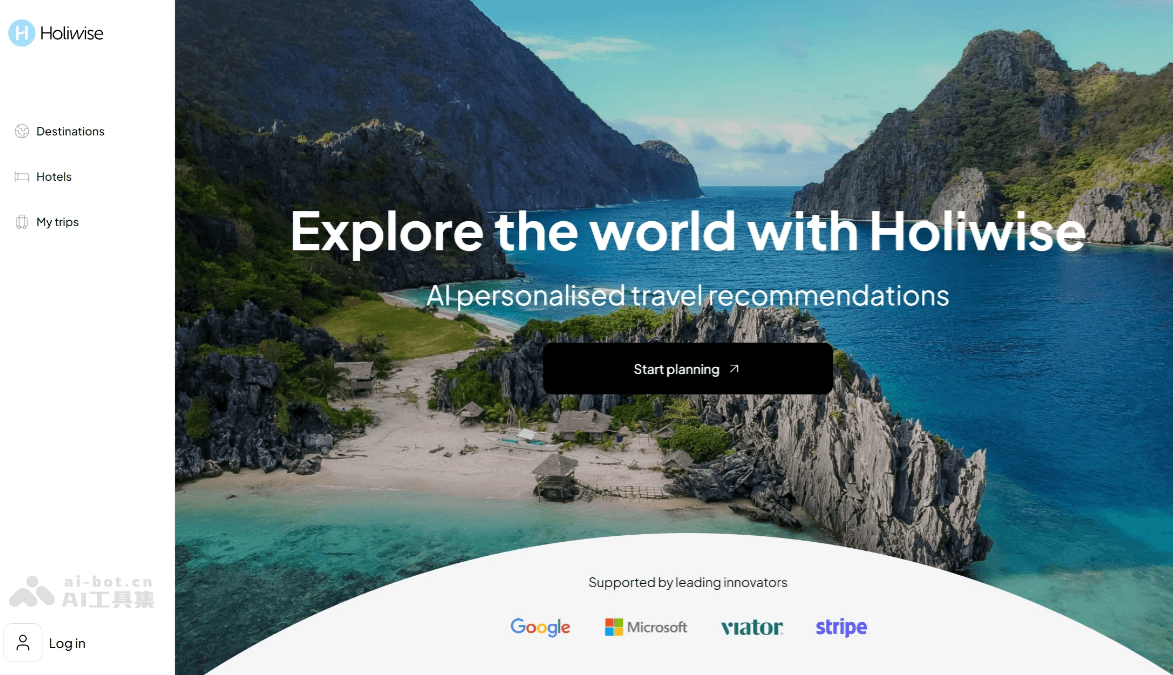
Holiwise – AI旅行规划平台,自动生成个性化的行程安排
Holiwise 是基于人工智能的旅行规划平台,为用户提供个性化、高效的旅行目的地推荐和行程规划服务。用户只需输入旅行偏好,如预算、出行日期、旅行类型等,Holiwise 的AI算法会快速分析海量数据,生成专属的目的地推荐和行程安排。
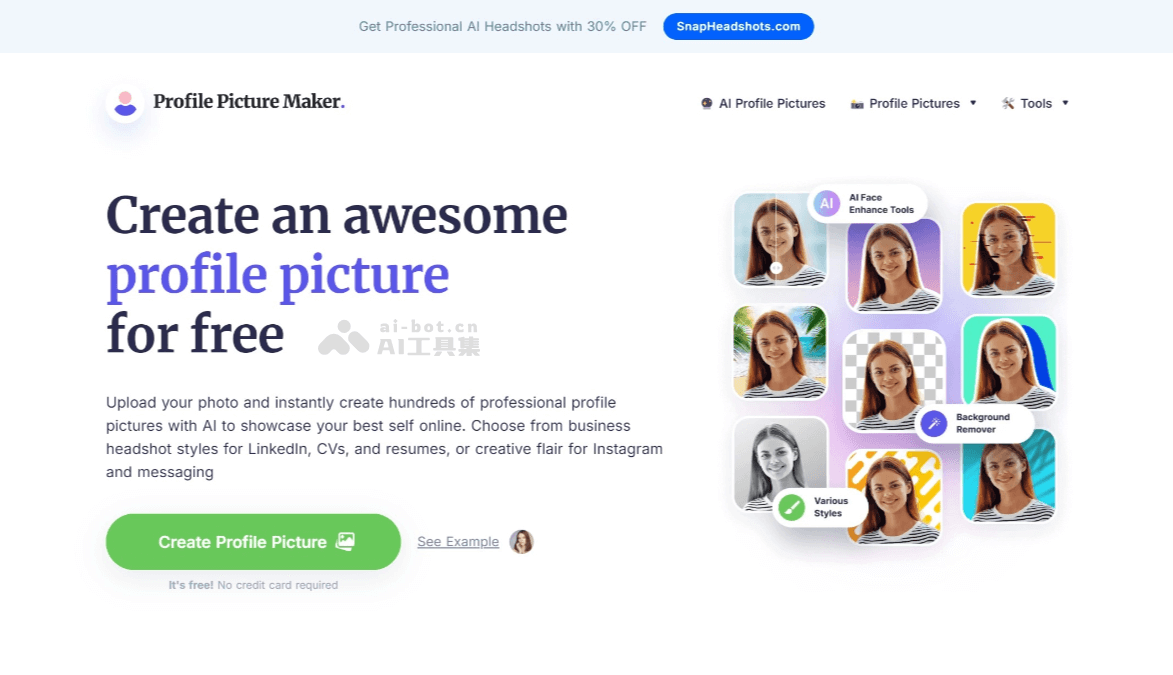
profile picture Maker – 免费AI头像制作工具,支持多种风格头像生成
profile picture Maker(PFPMaker)是基于人工智能技术的免费在线头像制作工具。能快速去除照片背景,提供丰富的编辑功能,帮助用户轻松创建个性化头像。用户可以上传自己的照片,或者选择平台提供的素材库中的图片,通过裁剪、旋转、调整亮度和对比度等工具,生成高质量的头像。
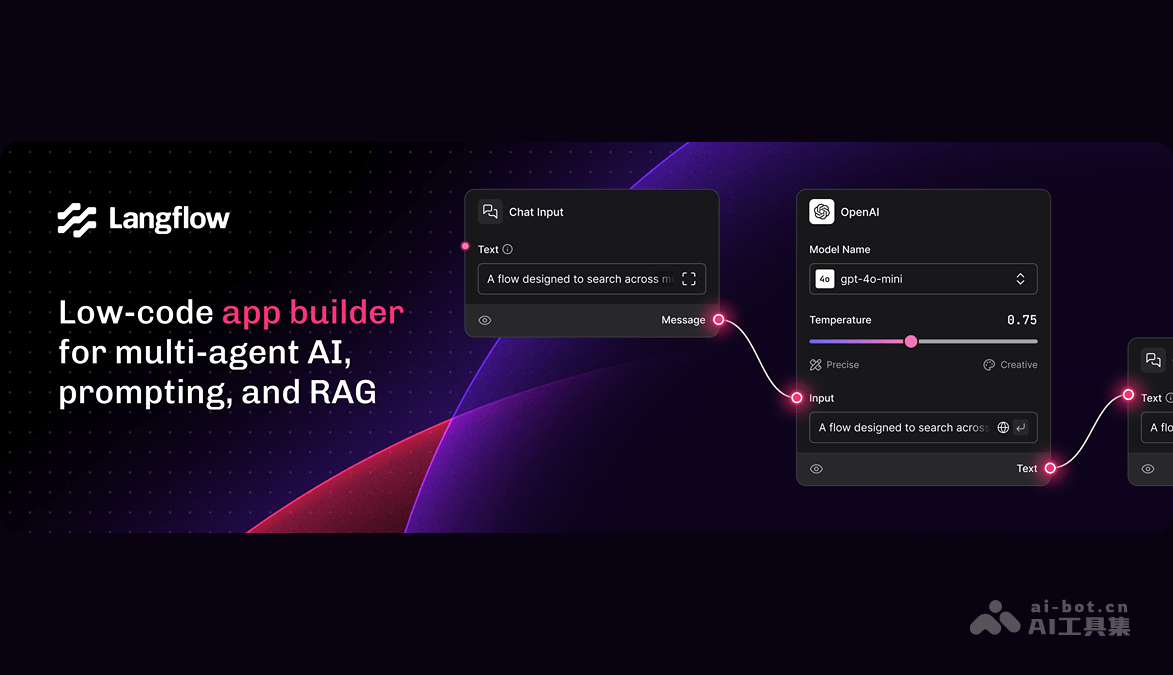
LangFlow – AI应用构建工具,拖拽组件创建复杂工作流
LangFlow 是低代码、可视化的 AI 应用构建工具,用于快速搭建和实验 LangChain 流水线。通过拖拽式界面,用户能轻松创建复杂的 AI 工作流,无需编写大量代码。LangFlow 支持多代理对话管理和 RAG(检索增强生成)应用,适用于构建智能聊天机器人、文档分析系统和内容生成工具等场景。
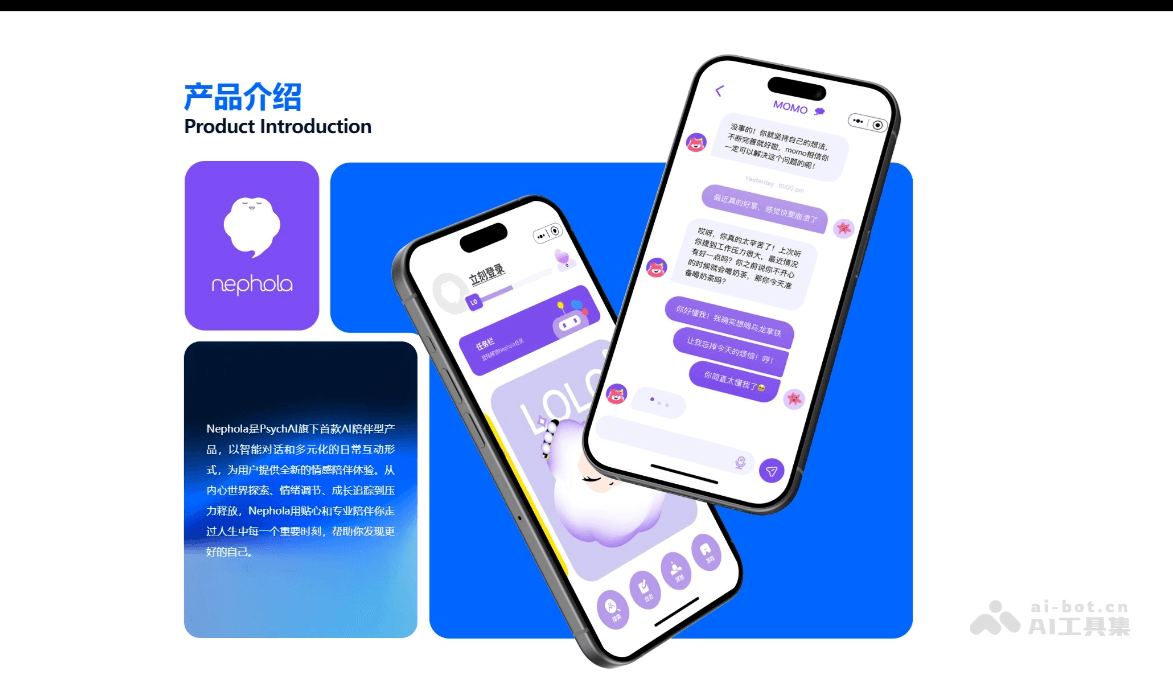
Nephola – AI陪伴应用,提供四大性格独特的 AI 智能体
Nephola 是 PsychAI 推出的心理陪伴型 AI 应用,专注于情绪管理和心理健康。通过四大性格独特的 AI 智能体(Lolo、Momo、Bobo、Dodo)为用户提供情感陪伴和心理支持。用户可以根据自己的需求选择与不同性格的智能体交流,获得个性化的陪伴体验。
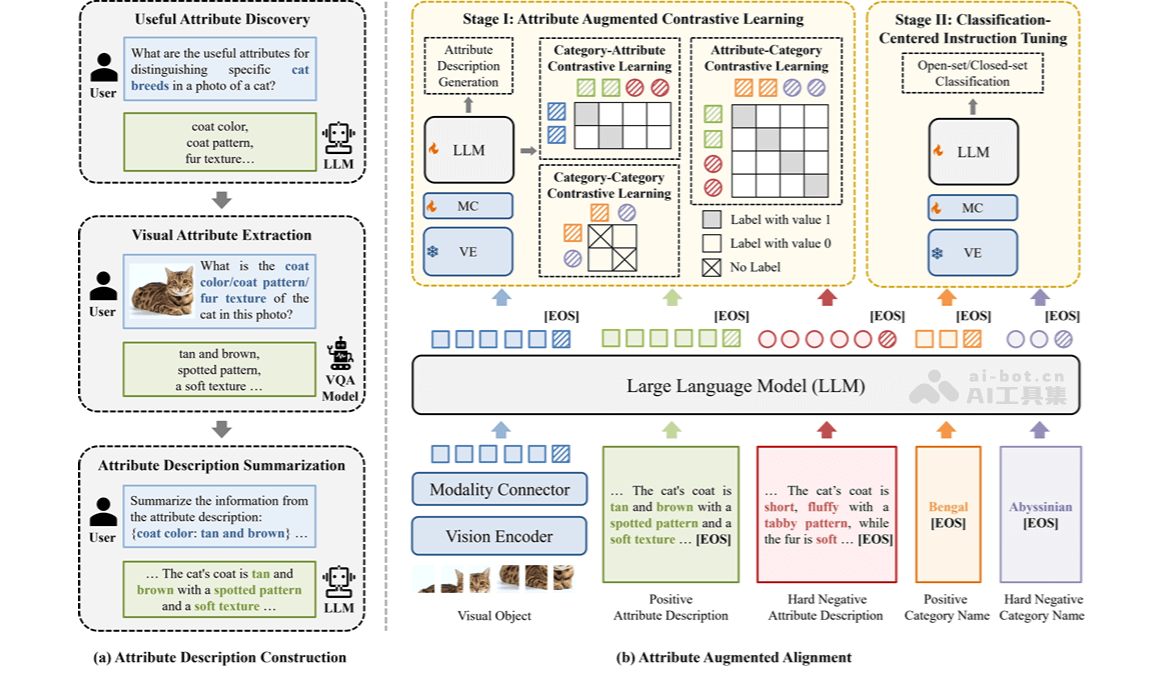
Finedefics – 北大团队推出的细粒度多模态大模型
Finedefics 是北京大学彭宇新教授团队推出的细粒度多模态大模型,提升多模态大语言模型(MLLMs)在细粒度视觉识别(FGVR)任务中的表现。模型通过引入对象的细粒度属性描述,基于对比学习对齐视觉对象与类别名称的表示,解决了传统模型中视觉对象与细粒度子类别未对齐的问题。
Step-Video-T2V – 阶跃星辰开源的文本到视频模型
Step-Video-T2V 是阶跃星辰团队推出的开源文本到视频预训练模型,拥有 300 亿参数,能生成长达 204 帧的高质量视频。模型基于深度压缩的变分自编码器(Video-VAE),实现 16×16 的空间压缩和 8× 的时间压缩,显著提高了训练和推理效率。
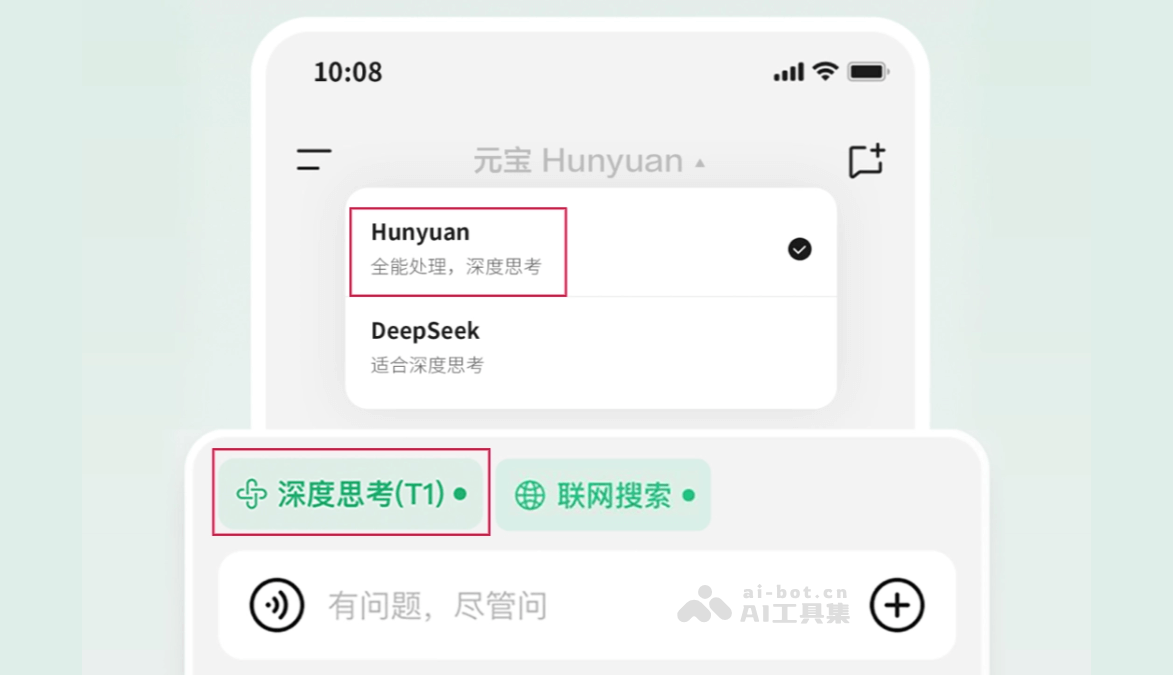
腾讯混元T1 – 腾讯混元推出的最新深度思考模型
T1(Thinker)是腾讯混元推出的最新深度思考模型,已正式上线接入腾讯元宝。模型专注于逻辑推理和深度思考,支持联网搜索功能,能从互联网信源、微信公众号、视频号等腾讯生态内容中获取信息,确保回答的时新性和权威性。
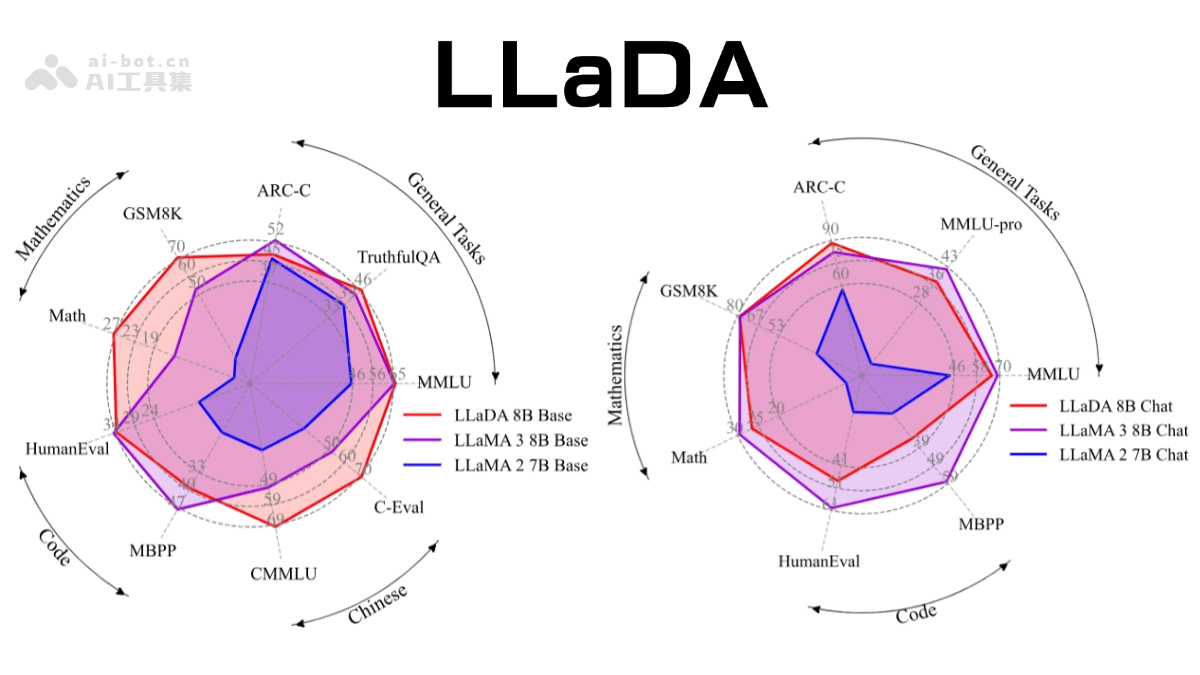
LLaDA – 人大高瓴AI联合蚂蚁推出的扩散大语言模型
LLaDA(Large Language Diffusion with mAsking)是中国人民大学高瓴AI学院李崇轩、文继荣教授团队和蚂蚁集团共同推出的新型大型语言模型,基于扩散模型框架而非传统的自回归模型(ARM)。LLaDA基于正向掩蔽过程和反向恢复过程建模文本分布,用Transformer作为掩蔽预测器,优化似然下界实现生成任务。
厦门大学《大模型概念、技术与应用实践》(PPT文件) – AI教程资料
《大模型概念、技术与应用实践》由厦门大学大数据教学团队制作,科普大模型技术及其在各领域的应用。强调其在大数据教学领域的影响力。回顾人工智能发展简史,引出大模型的定义、特点和分类,详细阐述了在自然语言处理、计算机视觉、语音识别等领域的广泛应用,以及对工作和生活的深远影响。
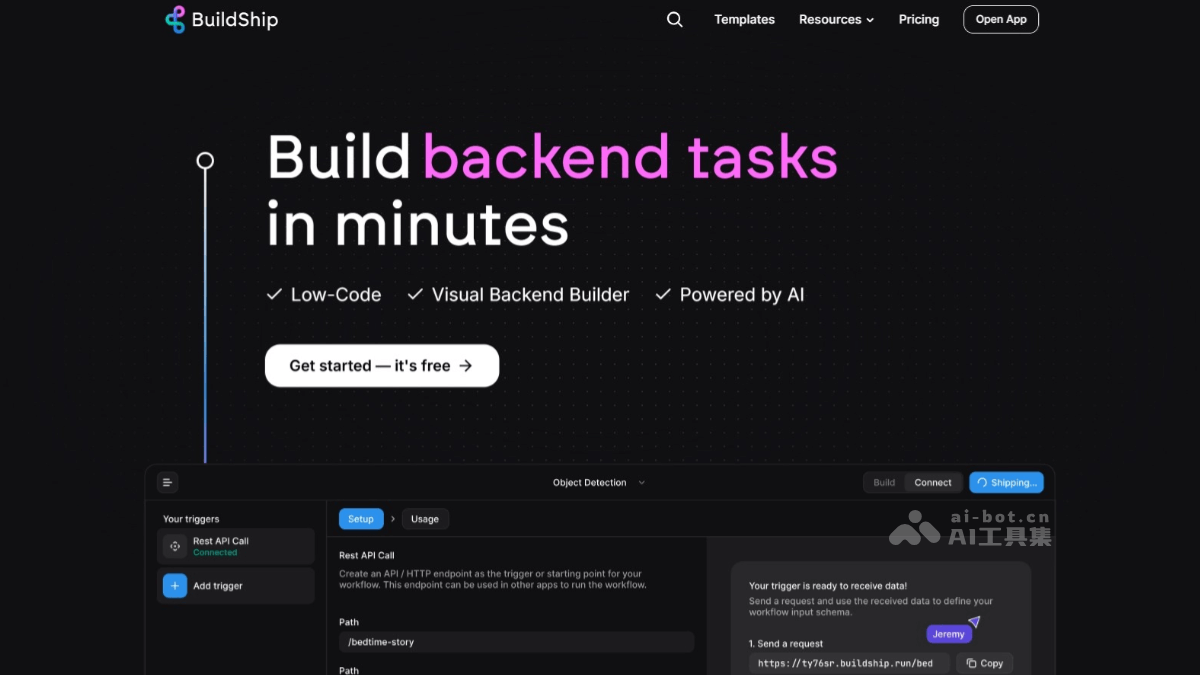
BuildShip – 低代码可视化AI后端开发平台
BuildShip 是低代码可视化后端开发平台,基于 AI 技术简化后端开发流程。BuildShip 支持快速创建 API、自动化工作流、定时任务和云部署,同时提供内置数据库或自定义数据库集成。用户基于可视化界面进行开发,无需编写复杂代码,或结合 JavaScript/TypeScript 进行低代码扩展。
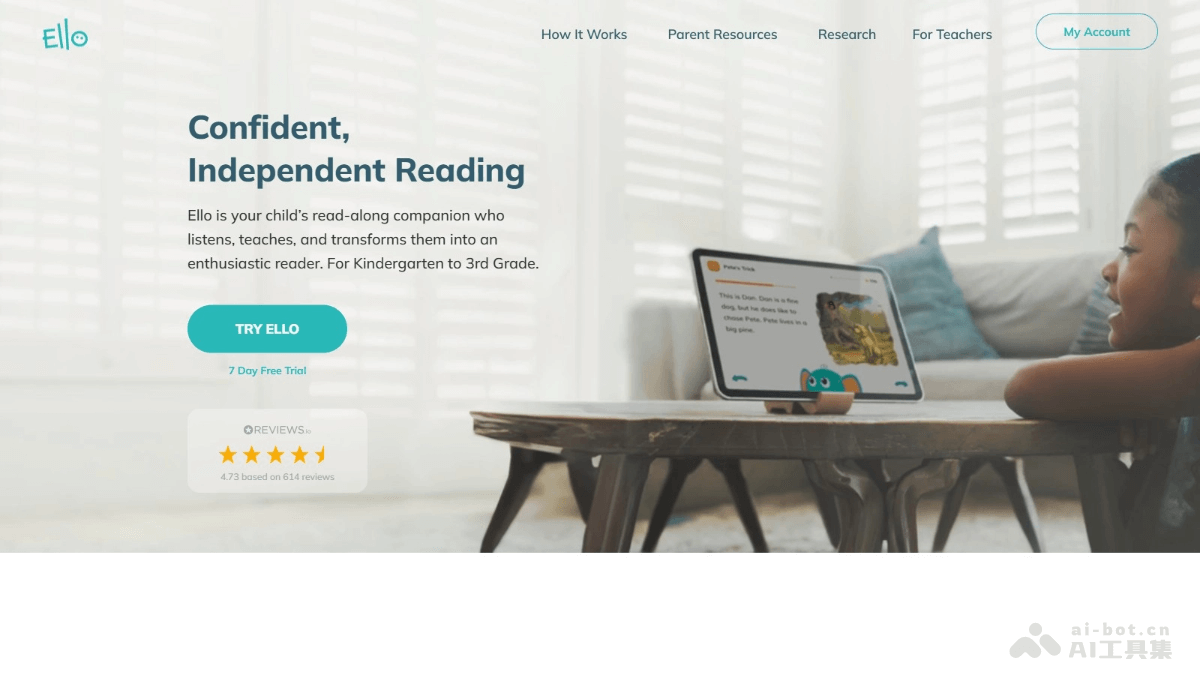
Ello – AI阅读辅导应用,根据阅读水平和兴趣个性化指导
Ello是为儿童设计的AI阅读辅导应用,基于AI技术帮助孩子提升阅读能力。Ello结合自适应学习系统(Adaptive Learn™)和语音识别技术,根据孩子的阅读水平和兴趣提供个性化指导。
如何使用DeepSeek-R1搭建个人知识库,3个免费教程
最近经常有朋友问: 如何让DeepSeek结合我们企业的内部知识生成回答? 如何让DeepSeek根据小红书的爆款笔记,生成内容? 想让AI结合本地信息,每次创建会话时都要上传文件,还限制文件大小,太麻烦了,有没有方法优化?我的回答是:搭建个人知识库!
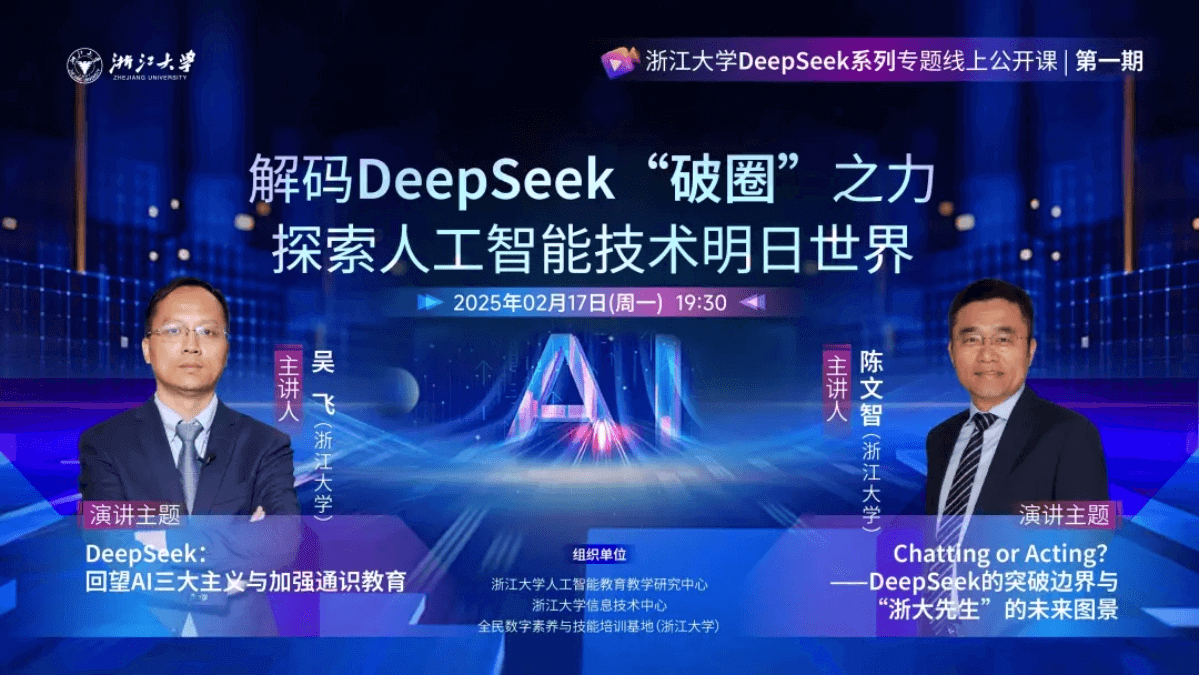
浙江大学推出DeepSeek系列专题线上公开课
为了系统解析DeepSeek在技术、应用与伦理交织演进下的革新性探索,带领大家深入了解DeepSeek的“破圈”与“扎根”。浙江大学人工智能科研团队推出DeepSeek系列专题线上公开课,自2025年2月17日起每周一晚上19:30面向全校师生及社会公众在线直播分享。
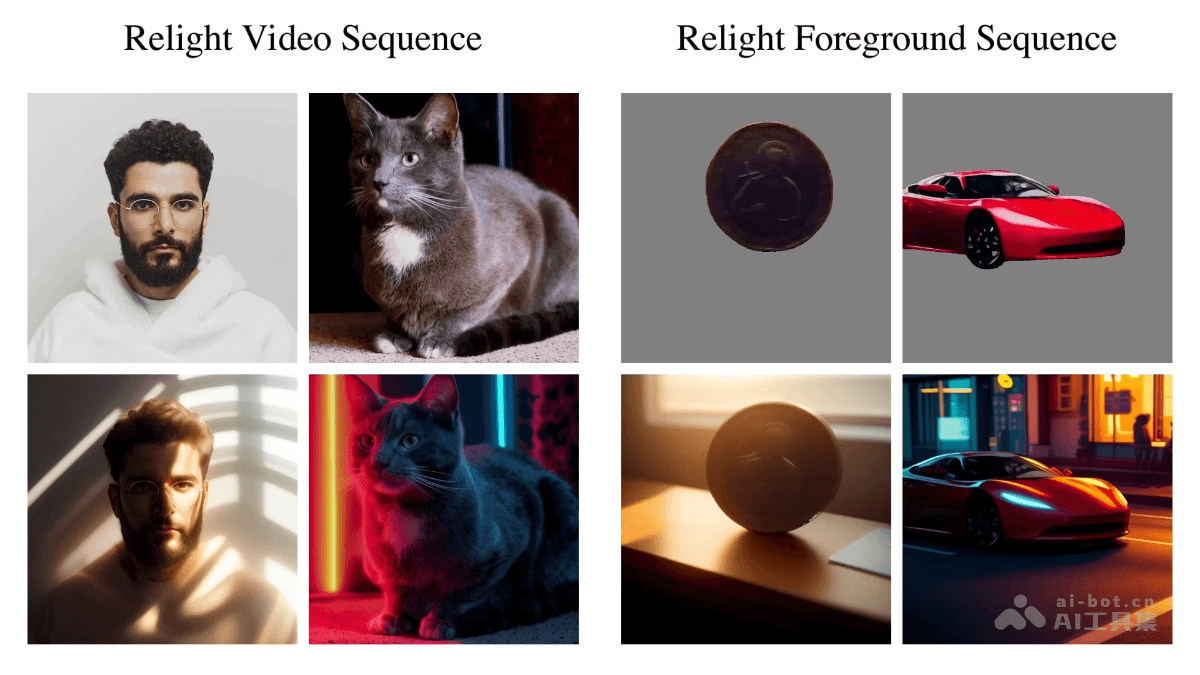
Light-A-Video – 上海AI Lab联合交大等高校推出的视频重照明方法
Light-A-Video 是上海交通大学、中国科学技术大学、香港中文大学、香港科技大学、斯坦福大学及上海AI实验室的共同推出的无需训练的视频重照明方法,基于渐进式光照融合技术实现高质量、时间上一致的视频光照控制。