
工具 · 模型 · 行业动态
AI文章
发现新工具,了解新进展。让每一次阅读,都离用好 AI 更近一步。
7,595篇文章,持续更新
最新文章
第 226 / 422 页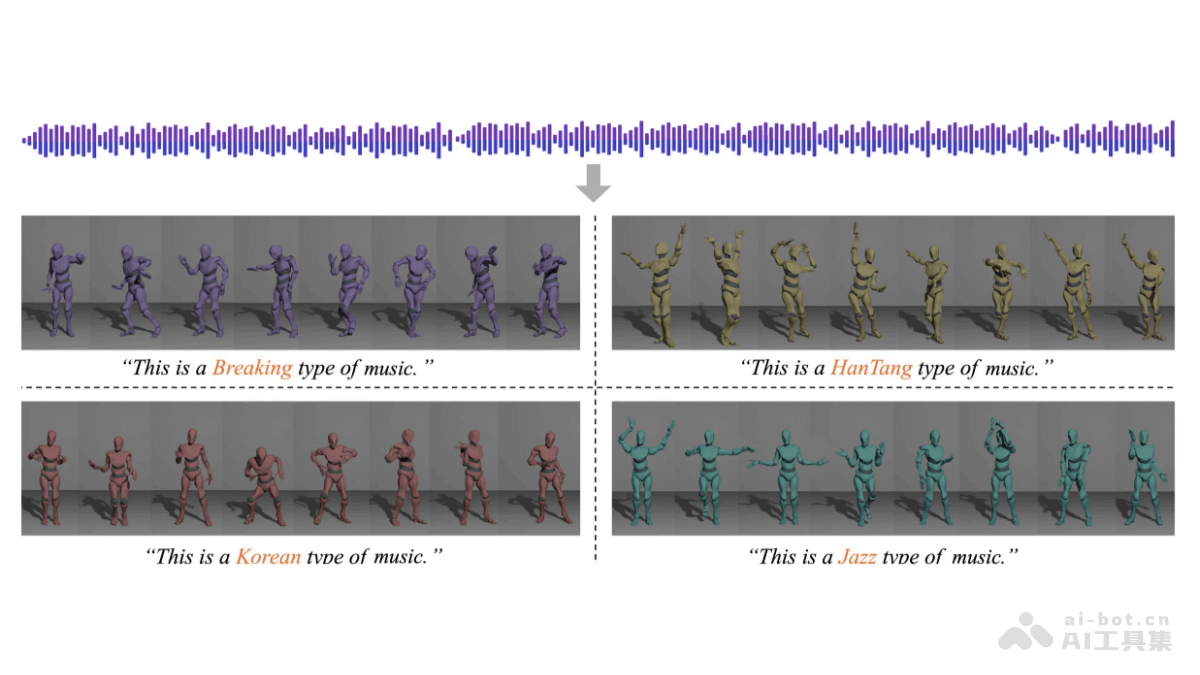
GCDance – 萨里大学和江南大学推出的3D舞蹈生成框架
GCDance(Genre-Controlled 3D Full Body Dance Generation Driven by Music)是英国萨里大学和江南大学推出的3D舞蹈生成框架,能根据音乐和文本提示生成符合特定风格的全身舞蹈序列。GCDance结合预训练的音乐基础模型(如Wav2CLIP)提取的高级音乐特征和手工设计的音乐特征(如STFT),实现多粒度音乐特征融合,用CLIP模型将文本提示嵌入到舞蹈生成的每个时间步中,实现风格可控的舞蹈生成。
阅读全文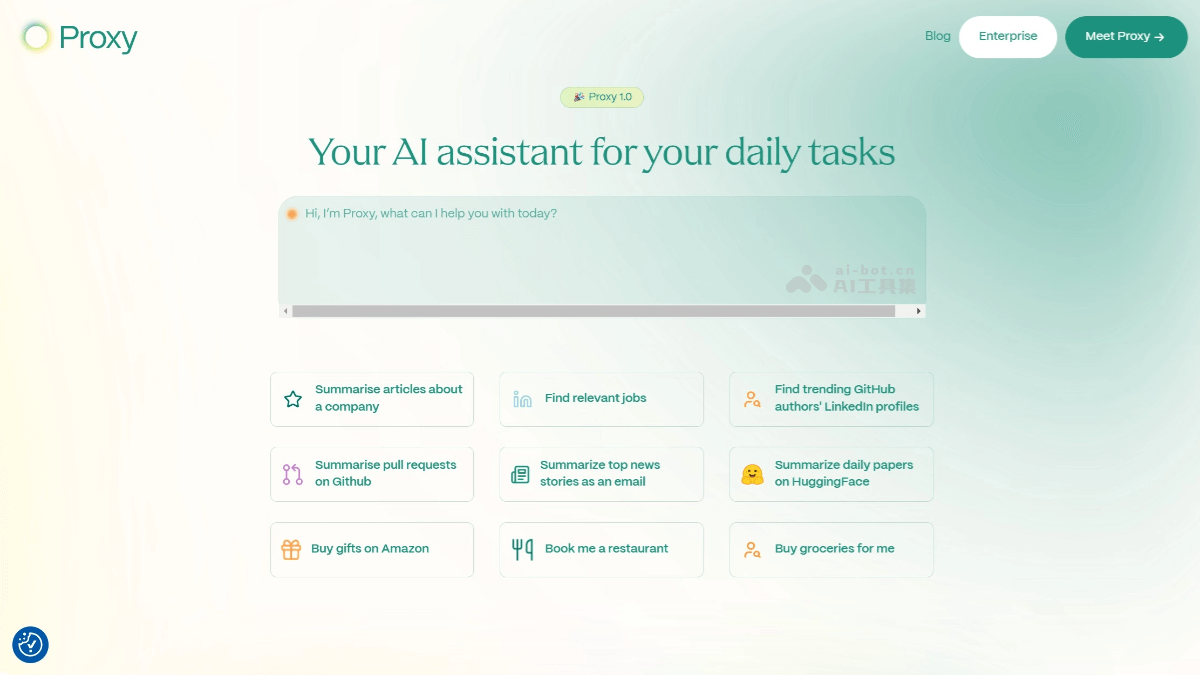
Proxy – Convergence AI 推出的全自动化 AI 助手
Proxy 是 Convergence AI 推出的全自动化的 AI 助手,通过自然语言交互帮助用户完成各种日常任务。能自动处理日程安排、邮件管理、数据录入等重复性工作,具备实时学习和改进的能力。用户只需用简单的语言描述任务,Proxy 可自动执行,能根据反馈优化性能。
阅读全文
Mistral OCR – Mistral AI 推出的先进光学字符识别工具
Mistral OCR 是 Mistral AI 推出的先进光学字符识别(OCR)工具,专为处理复杂文档而设计。能全面理解文档中的文本、图像、表格和数学公式等元素,支持数千种语言和字体,多语言处理准确率高达99.02%,在基准测试中超越 Google Document AI 和 Azure OCR。
阅读全文
OpenManus – MetaGPT 团队推出的 Manus 开源复刻版
OpenManus 是MetaGPT 团队推出的开源复刻版 Manus,提供无需邀请码的 AI Agent 。OpenManus基于模块化设计,支持多种语言模型和工具链,能执行代码、处理文件、搜索网络信息等复杂任务。OpenManus 的核心优势在于实时反馈机制,用户能直观看到 AI 的思考过程和任务执行进度。
阅读全文
怎么申请Manus邀请码,附Manus邀请码申请技巧
Manus是Monica团队推出的全球首款通用型AI智能体,Manus与传统AI助手不同,能提供建议或答案,直接交付复杂任务的完整成果。 Manus在GAIA基准测试中取得了SOTA(State-of-the-Art,当前最优水平)的成绩,超越了OpenAI的Deep Research等竞品。
阅读全文
TicVoice 7.0 – 出门问问推出的第七代语音合成引擎
TicVoice 7.0 是出门问问推出的第七代高品质 TTS(语音合成)引擎,基于新一代语音生成模型 Spark-TTS 。TicVoice 7.0基于创新的 BiCodec 编码方式,将语音分解为 Global Token 和 Semantic Tokens,实现音色与语义的精准控制,与文本 LLMs 结构高度统一。
阅读全文
tellers.ai – AI视频生成工具,自动分析文本匹配相关素材
tellers.ai 是AI视频生成工具,专注于将文本内容快速转化为高质量视频。用户只需输入文本,平台会自动分析内容从真实视频库中选取相关素材,生成具有吸引力的视频。
阅读全文
Currents AI – AI社媒分析工具,实时监测和分析市场动态
Currents AI 是基于人工智能的社交媒体趋势分析工具,专注于实时监测和分析社交媒体平台上的热门话题、用户情感和市场动态。通过24/7不间断的数据追踪,帮助用户快速捕捉市场趋势、挖掘潜在客户,生成深度报告。
阅读全文
Pinch – AI翻译平台,支持 30 多种语言在视频通话中即时语音翻译
Pinch 是创新的实时 AI 语音翻译视频会议平台,专为打破语言障碍而设计,支持超过 30 种语言的即时语音翻译。提供两种翻译模式:口译模式和同声传译模式,分别支持 38 种和 32 种语言,满足不同场景下的高精度和高效率需求。
阅读全文
混元图生视频 – 腾讯混元开源的图生视频模型
混元图生视频是腾讯混元推出的开源图生视频模型,用户可以通过上传一张图片进行简短描述,让图片动起来生成5秒的短视频。模型支持对口型、动作驱动和背景音效自动生成等功能。模型适用于写实、动漫和CGI等多种角色和场景,总参数量为130亿。
阅读全文
Aya Vision – Cohere 推出多模态、多语言的视觉模型
Aya Vision 是 Cohere 推出的多模态、多语言的视觉模型,提升全球范围内的多语言和多模态通信能力。支持 23 种语言,能执行图像描述生成、视觉问答、文本翻译和多语言摘要生成等任务。
阅读全文
BGE-VL – 智源研究院联合多所高校开源的多模态向量模型
BGE-VL 是北京智源研究院联合多所高校推出的多模态向量模型,基于大规模合成数据 MegaPairs 训练而成。BGE-VL专注于多模态检索任务,如图文检索和组合图像检索,基于高效的多模态数据合成方法提升模型的泛化能力和检索性能。
阅读全文
VDraw – AI信息图表生成工具,自动提取文件关键信息一键生成图表
VDraw是基于AI技术的信息图表生成工具,帮助用户将文字、文件或视频内容快速转化为专业且个性化的视觉内容。用户能对生成的图表进行个性化定制,包括修改颜色、字体、添加图片和品牌标志等。VDraw支持多种内容格式,如文本、PDF、视频等,提供快速分享和嵌入功能。
阅读全文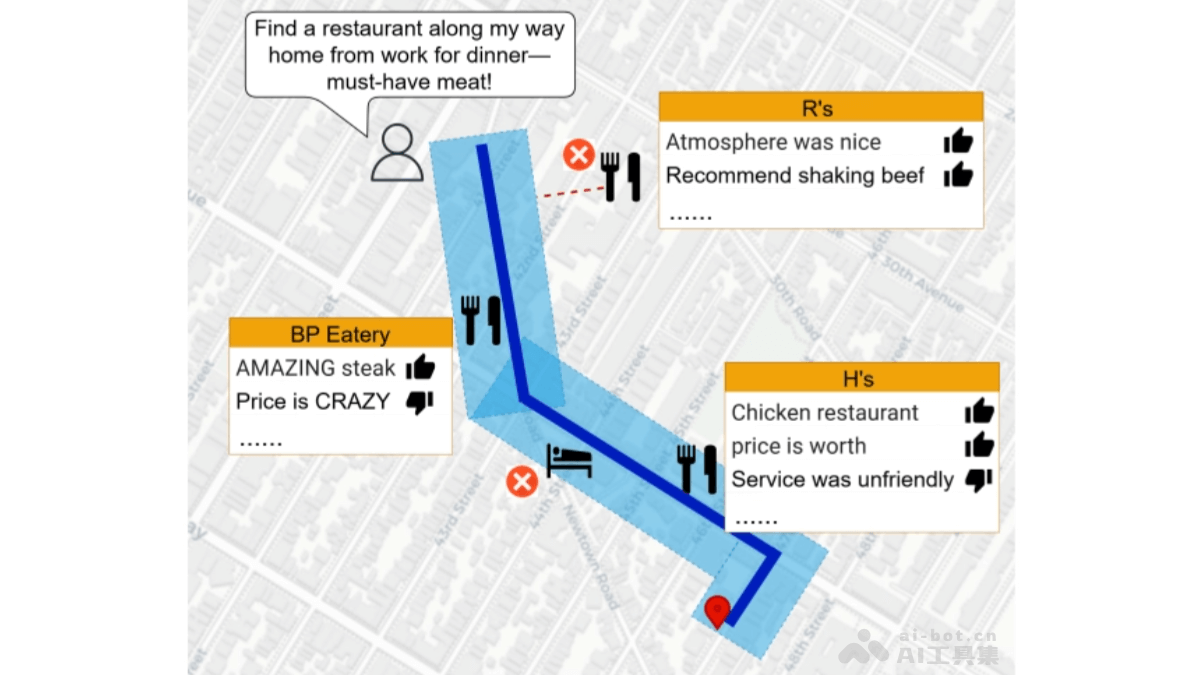
Spatial-RAG – 埃默里大学等机构推出的空间推理能力框架
Spatial-RAG(Spatial Retrieval-Augmented Generation)是美国埃默里大学、德克萨斯大学奥斯汀分校推出的用在提升大型语言模型(LLMs)空间推理能力的框架。结合稀疏空间检索(基于空间数据库的结构化查询)和密集语义检索(基于LLM的语义相似性匹配),解决LLMs在空间数据处理和推理方面的不足。
阅读全文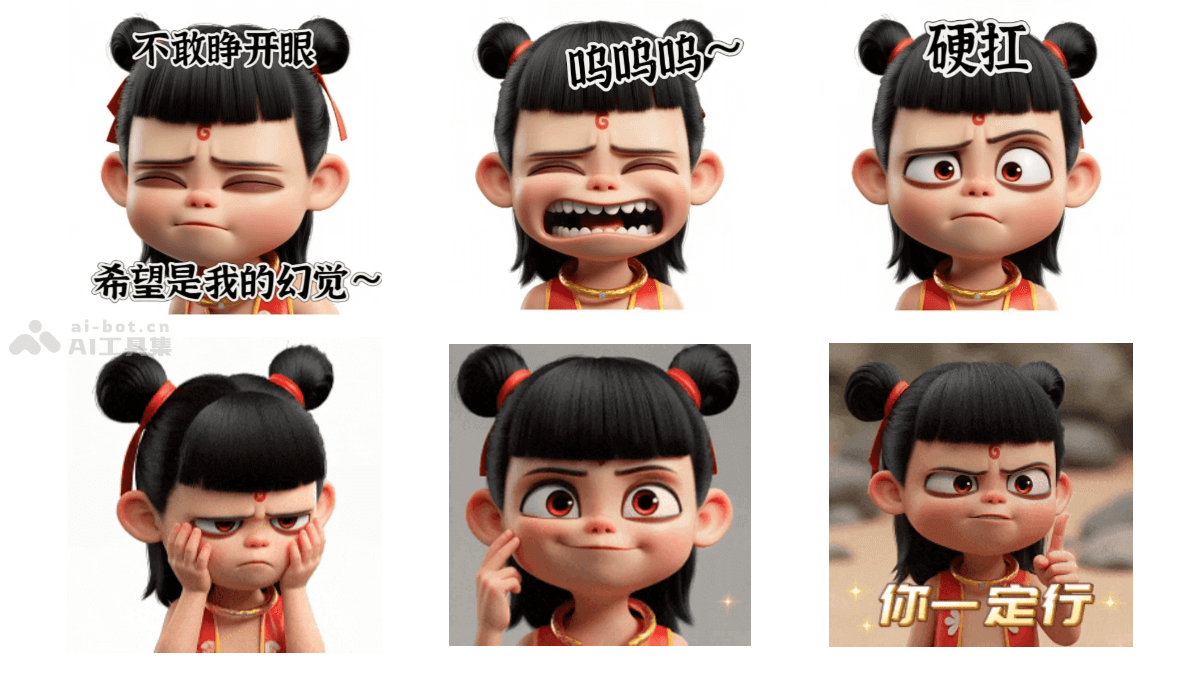
如何用AI制作哪吒表情包?ComfyUI工作流喂饭级教程
用AI制作表情包真的太香了,以前一套表情包要做好几周,现在分分钟搞定。 接下来给大家分享一下,我用ComfyUI做的最近爆火的哪吒表情包全过程。
阅读全文
Light-R1 – 360智脑开源的长思维链推理模型
Light-R1是360智脑开源的AI模型,专注于数学领域的长思维链推理,具体为 Light-R1-32B。模型基于Qwen2.5-32B-Instruct,用7万条数学数据和两阶段课程学习(SFT+DPO)训练,实现从零超越DeepSeek-R1-Distill-Qwen-32B的性能。
阅读全文
NEXUS-O – 多模态AI模型,实现对语言、音频和视觉全方位感知与交互
NEXUS-O 是HiThink 研究院、英国帝国理工学院、浙江大学、复旦大学、微软、Meta AI等机构推出的多模态AI模型,能实现对语言、音频和视觉信息的全方位感知与交互。NEXUS-O能处理音频、图像、视频和文本的任意组合输入,用音频或文本形式输出结果。
阅读全文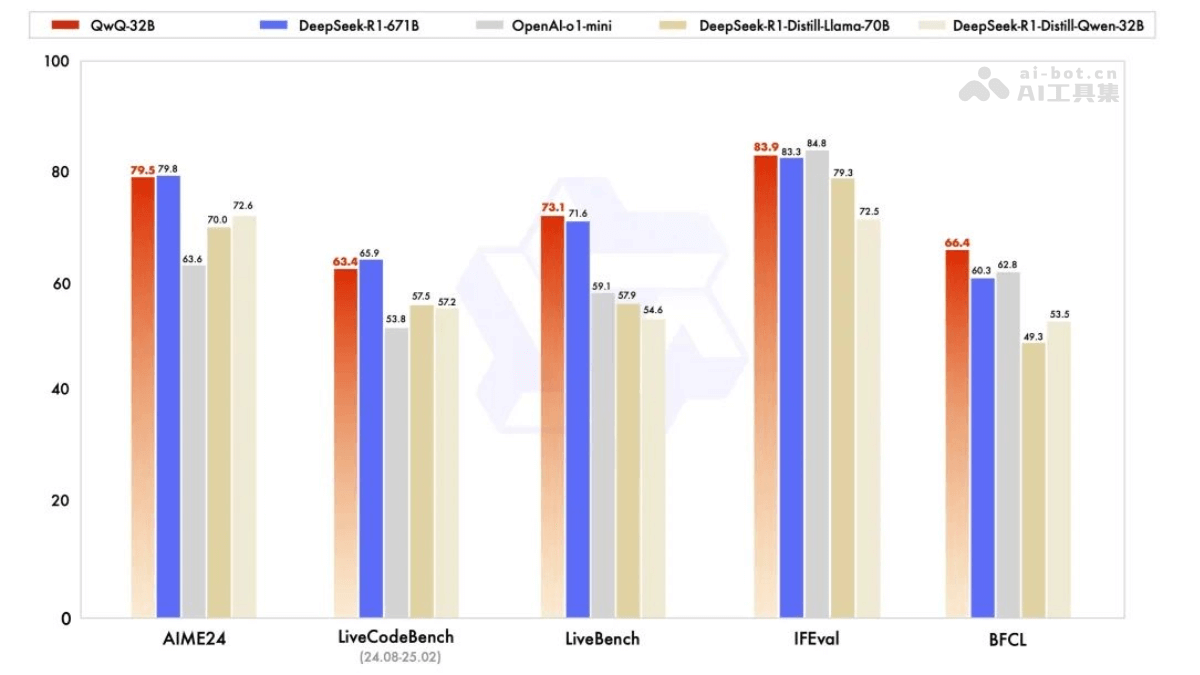
QwQ-32B – 阿里通义千问开源的最新推理模型
QwQ-32B 是阿里巴巴开源的新型推理模型,参数量为 320 亿。基于大规模强化学习(RL)训练,在数学推理、编程等任务上表现出色,性能比肩 6710 亿参数的 DeepSeek-R1 满血版。模型集成智能体能力,根据环境反馈调整推理过程,展现出强大的适应性和推理能力。
阅读全文