
工具 · 模型 · 行业动态
AI文章
发现新工具,了解新进展。让每一次阅读,都离用好 AI 更近一步。
7,595篇文章,持续更新
最新文章
第 218 / 422 页
InternVL – OpenGVLab 推出的多模态大模型
InternVL 是上海人工智能实验室 OpenGVLab 推出的多模态大模型,专注于视觉与语言任务。采用 ViT-MLP-LLM 架构,通过视觉模块(如 InternViT)和语言模块(如 InternLM)的融合,实现视觉与语言的深度结合。
阅读全文
Fynix – AI代码助手,具备上下文感知自动补全代码
Fynix 是专注于软件开发生命周期(SDLC)的 AI 工具,基于AI技术提升开发效率和代码质量。Fynix 提供 AI 代码助手、代码质量代理、SRE 代理和安全代理等多种功能,支持主流编程语言和 IDE,与 JIRA 等工具无缝集成。
阅读全文
OLMo 2 32B – Ai2 推出的最新开源语言模型
OLMo 2 32B 是 Allen Institute for AI(Ai2)推出的最新开源语言模型,是 OLMo 2 系列的重要成果。拥有 320 亿参数,是首个在多技能学术基准测试中超越 GPT-3.5-Turbo 和 GPT-4o-mini 的完全开放模型,性能接近 Qwen-2.5-72B 等更大规模模型。
阅读全文
Narakeet – AI文本转语音平台,支持 100 种语言和 800 种声音
Narakeet 是功能强大的在线平台,基于自然语音合成技术快速创建配音和旁白视频。Narakeet支持 100 种语言和 800 种声音,将文本、Word 文档、PPT 演示文稿或字幕文件转换为高质量的音频文件,与视频内容自动同步。
阅读全文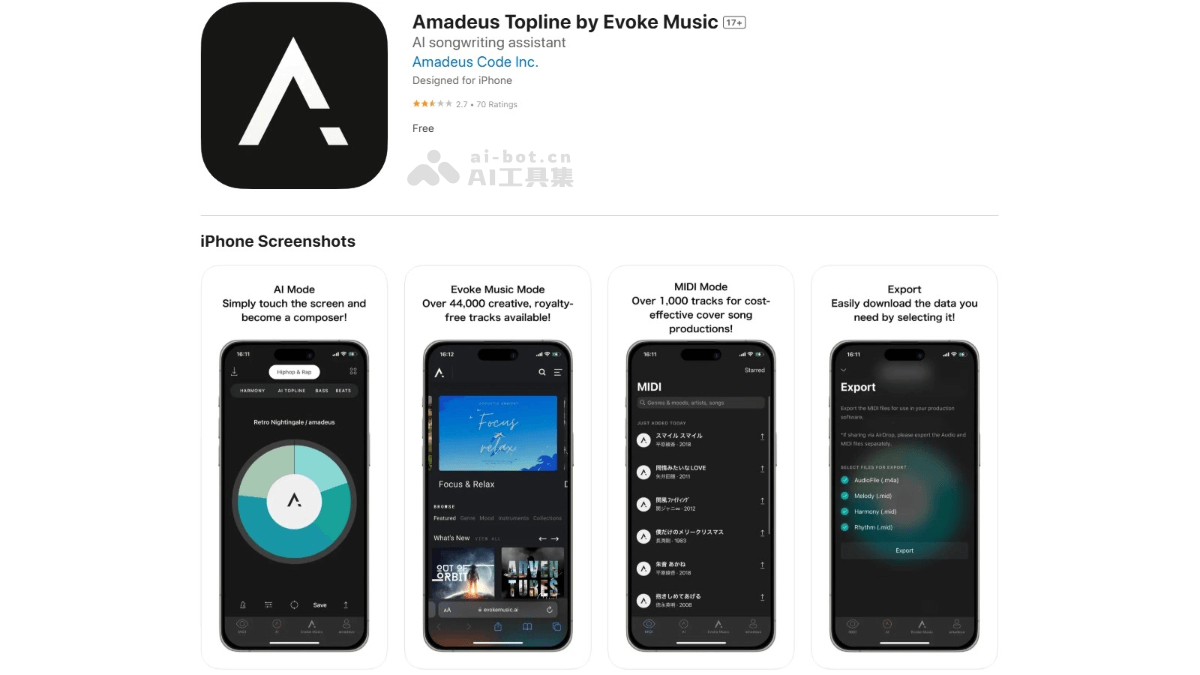
Amadeus Code – AI音乐创作工具,轻触屏幕AI自动生成旋律
Amadeus Code 是基于AI技术的音乐创作工具。基于 AI 算法生成旋律、和弦进程等音乐元素,帮助用户快速创作歌曲初稿,激发创作灵感。Amadeus Code 支持用户免费使用基本功能,包括探索新和弦进程、生成 MIDI 文件等,支持导入到数字音频工作站(DAW)中进一步完善创作。
阅读全文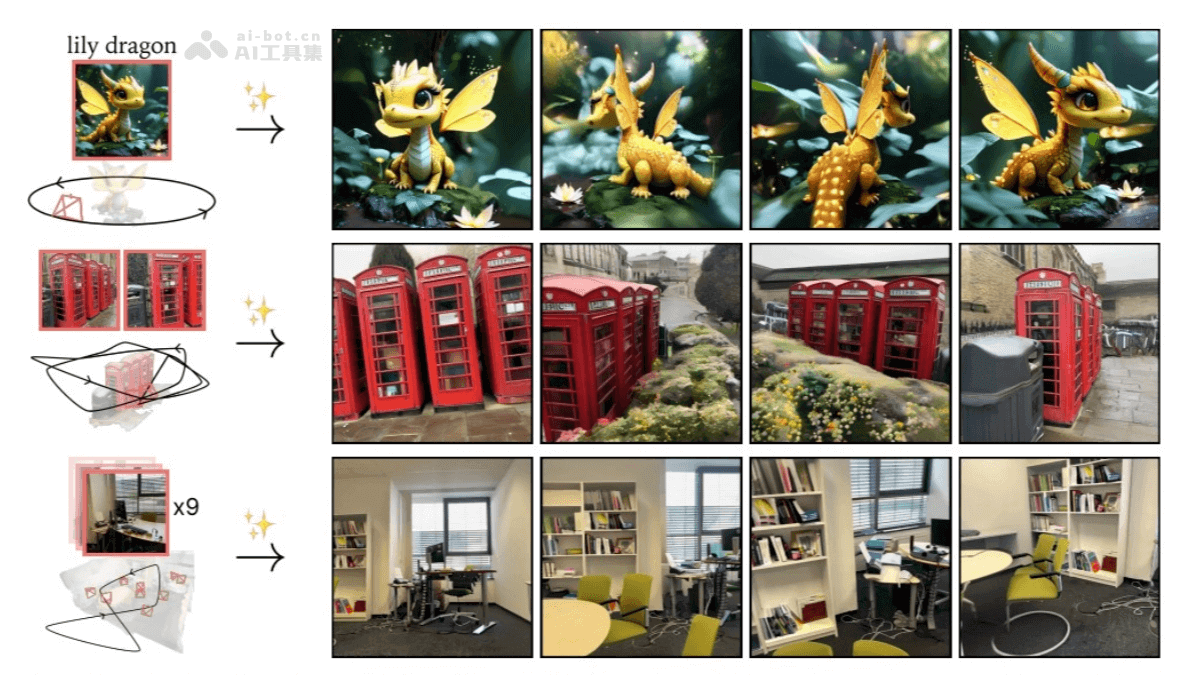
Stable Virtual Camera – Stability AI 等机构推出的 AI 模型,2D图像转3D视频
Stable Virtual Camera 是 Stability AI 推出的 AI 模型,能将 2D 图像转换为具有真实深度和透视感的 3D 视频。用户可以通过指定相机轨迹和多种动态路径(如螺旋、推拉变焦、平移等)来生成视频。模型支持从 1 到 32 张输入图像生成不同宽高比(如 1:1、9:16、16:9)的视频,最长可达 1000 帧。
阅读全文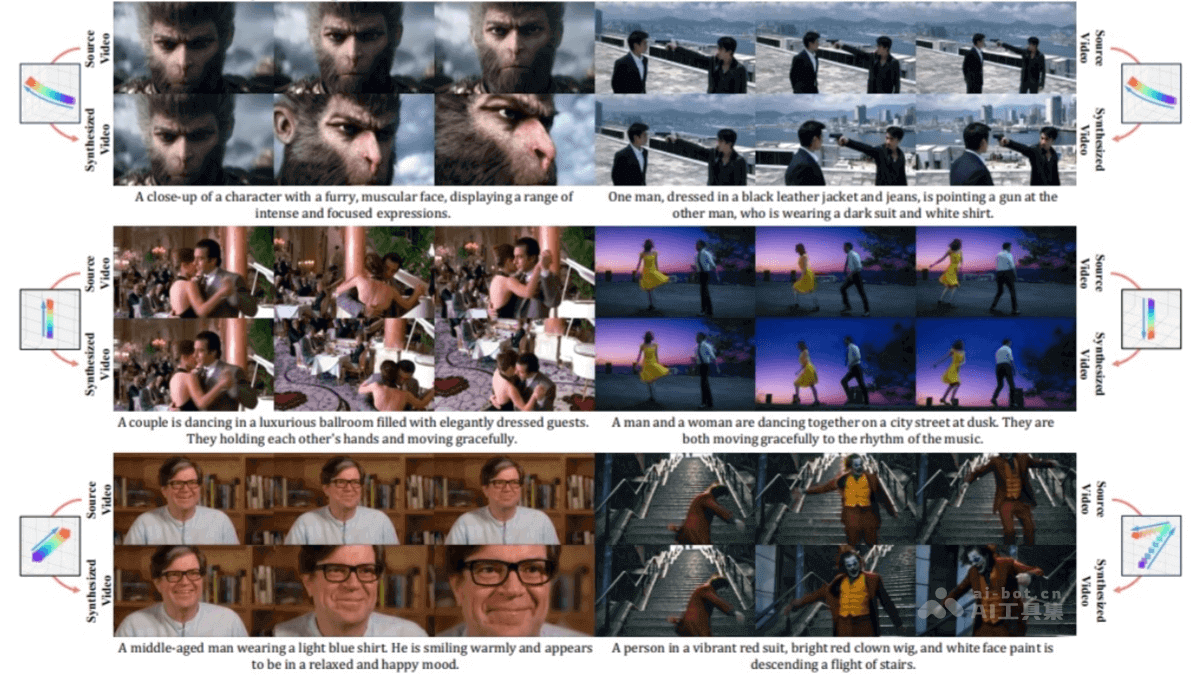
ReCamMaster – 浙大联合快手等推出的视频重渲染框架
ReCamMaster 是浙江大学、快手科技等联合推出的视频重渲染框架,能根据新的相机轨迹重新生成视频内容。通过预训练模型和帧维度条件机制,结合多相机同步数据集和相机姿态条件,实现视频视角、运动轨迹的灵活调整。
阅读全文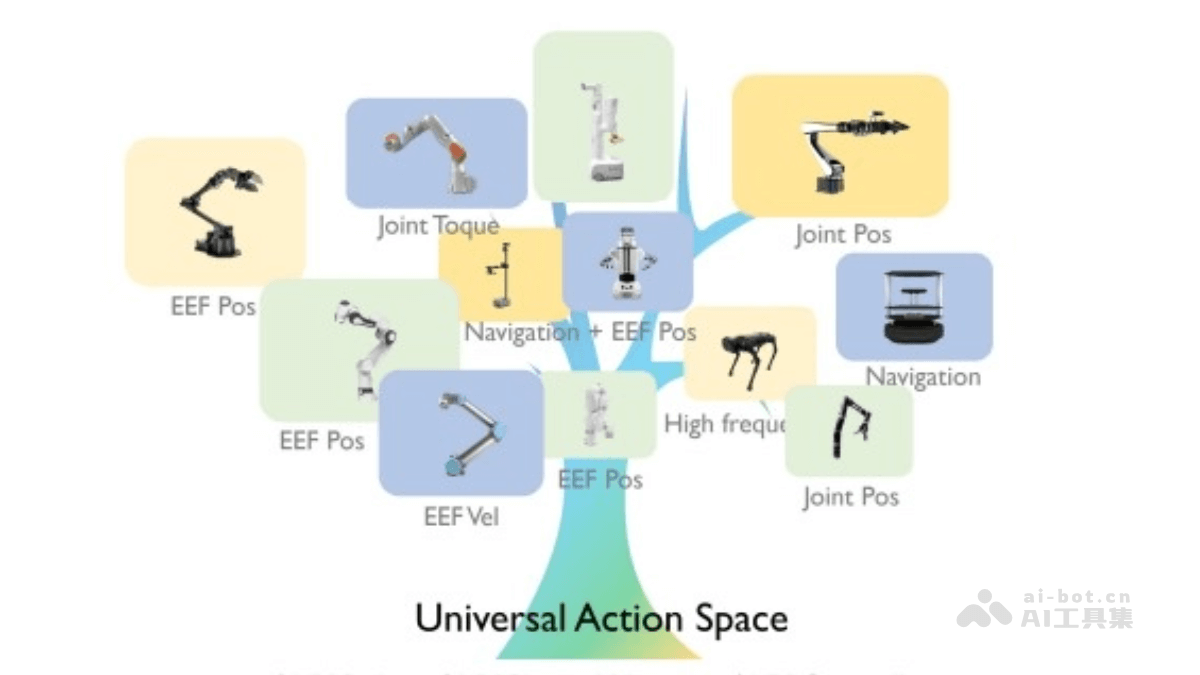
UniAct – 清华、商汤、北大、上海AI Lab共同推出的具身基础模型框架
UniAct 是新型的具身基础模型框架,解决不同机器人之间行为异构性的问题。通过学习通用行为,捕捉不同机器人共享的原子行为特征,消除因物理形态和控制接口差异导致的行为异构性。
阅读全文
AiSlides.chat – AI PPT 制作工具,对话式交互自动分析生成演示文稿
AiSlides.chat 是基于AI技术的对话式 PPT 制作工具。用户用自然语言输入需求或粘贴现有内容,AI 自动分析生成 PPT 大纲、逐页设计幻灯片,提供实时修改功能。AiSlides.chat 支持智能图表生成、图片管理、主题设置及多种导出格式(如 HTML 和 PPT)。
阅读全文
Instella – AMD开源的30亿参数系列语言模型
Instella是AMD推出的系列30亿参数的开源语言模型。模型完全从零开始在AMD Instinct™ MI300X GPU上训练而成,基于自回归Transformer架构,包含36个解码器层和32个注意力头,支持最长4096个标记的序列。
阅读全文
Multi-Speaker – AudioShake 推出的多说话人声分离模型
Multi-Speaker是AudioShake推出的全球首个高分辨率多说话人分离模型。支持将音频中的多个说话人精准分离到不同轨道,解决传统音频工具在处理重叠语音时的难题。Multi-Speaker适用于多种场景,先进神经架构支持高采样率,适合广播级音频,支持处理长达数小时的录音,在高重叠和低重叠场景,保持一致的分离效果,为音频编辑和创作带来革命性变革。
阅读全文
Dify-Plus – 基于 Dify 二次开发的企业级增强版项目
Dify-Plus 是基于 Dify 二次开发的企业级增强版项目,集成基于 gin-vue-admin 的管理中心。Dify-Plus在 Dify 基础上新增用户额度、密钥额度、Web 公开页登录鉴权、应用中心等功能,优化了权限管理,适合企业场景使用。
阅读全文
GR00T N1 – 英伟达开源的人形机器人基础模型
GR00T N1 是英伟达推出的全球首个开源基础模型,专为通用人形机器人设计。基于多模态输入(如语言和图像)实现多样化环境中的操作任务。GR00T N1 基于大规模人形机器人数据集训练,结合真实数据、合成数据和互联网视频数据,用后训练适应特定机器人形态、任务和环境。GR00T N1 基于双系统架构,视觉-语言模型负责推理和规划,扩散变换器则生成精确动作。
阅读全文
UniFluid – 谷歌联合麻省理工推出的多模态图像生成与理解框架
UniFluid 是谷歌 DeepMind 和麻省理工学院联合推出的,统一的自回归框架,用在联合视觉生成和理解任务。基于连续视觉标记处理多模态图像和文本输入,生成离散文本标记和连续图像标记。框架基于预训练的 Gemma 模型,用配对的图像-文本数据训练,让生成和理解任务相互促进。UniFluid 基于标准的 SentencePiece 作为文本标记器,用连续变分自编码器(VAE)作为图像生成的标记器,结合 SigLIP 图像编码器用在理解任务。
阅读全文
wcplusPro – 微信公众号数据采集和分析工具
wcplusPro 是专业的微信公众号数据采集和分析工具,支持 Windows、macOS 和 Linux 系统,免安装、解压即用。wcplusPro支持采集任意公众号的历史文章及多种阅读数据,包括标题、内容、阅读量等,提供高效的数据管理功能,支持百万级别文章的快速检索与排序。
阅读全文
TokenFD – 上海交大联合美团推出的细粒度图文对齐基础模型
TokenFD是上海交通大学联合美团推出的细粒度图文对齐基础模型,主要用于文档理解任务。通过Token级对齐,实现了图像Token与语言Token在同一特征空间中的共享,支持Token级图文交互,在处理包含密集文字的图像时表现突出。
阅读全文
SmolDocling – 轻量级的多模态文档处理模型
SmolDocling(SmolDocling-256M-preview )是高效轻量级的多模态文档处理模型。能将文档图像端到端地转换为结构化文本,支持文本、公式、图表等多种元素识别,适用于学术论文、技术报告等多类型文档。
阅读全文
LangManus – AI自动化框架,多智能体协同完成复杂任务
LangManus 是 AI 自动化框架,基于分层多智能体系统设计。包含多种智能体,如协调员、规划员、研究员、程序员等,各司其职,协同完成复杂任务。框架支持多种开源语言模型,如通义千问,兼容 OpenAI API 接口,能根据任务复杂度灵活调用不同层级的模型。
阅读全文