
工具 · 模型 · 行业动态
AI文章
发现新工具,了解新进展。让每一次阅读,都离用好 AI 更近一步。
7,595篇文章,持续更新
最新文章
第 205 / 422 页
BrowseComp – OpenAI 开源的 AI Agent 网络浏览能力基准
BrowseComp 是 OpenAI 开源的用于评估 AI Agent网络浏览能力的基准测试。包含 1266 个极具挑战性的问题,覆盖电影、科学与技术、艺术、历史、体育、音乐、电子游戏等多个领域。需要 AI Agent在互联网上搜索并匹配复杂约束条件,例如找出特定的足球比赛或电视剧角色等。
阅读全文
HyperChat – 开源 AI 聊天客户端,支持多种语言模型API
HyperChat 是开源的AI聊天客户端,支持多种语言模型(LLMs)的 API 接入,如 OpenAI、Claude 等。HyperChat基于 MCP 协议实现强大的生产力工具扩展,内置插件市场,支持一键安装和第三方插件。
阅读全文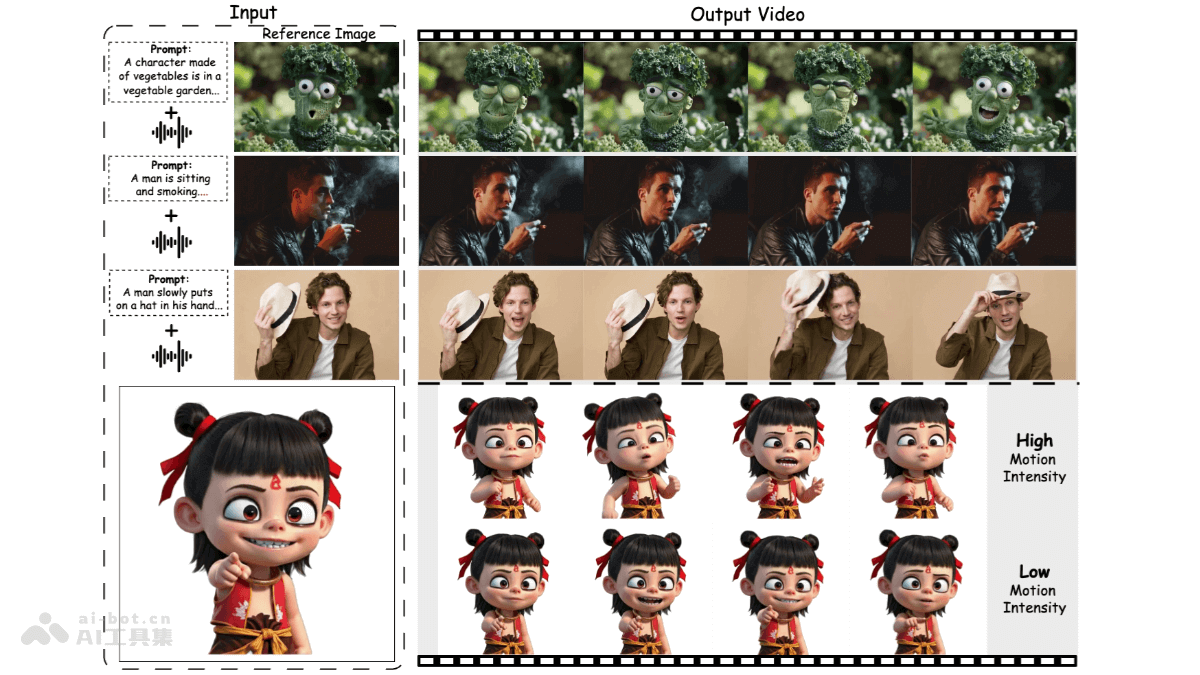
FantasyTalking – 阿里联合北邮推出静态肖像生成可控数字人的框架
FantasyTalking 是阿里巴巴 AMAP 团队和北京邮电大学联合提出的新型框架,用于从单张静态肖像生成逼真的可动画化虚拟形象。基于预训练的视频扩散变换器模型,采用双阶段视听对齐策略,第一阶段通过片段级训练方案建立连贯的全局运动,第二阶段通过唇部追踪掩码在帧级别细化唇部运动,确保与音频信号精确同步。
阅读全文
The AI Scientist-v2 – 通用端到端 AI 系统,自动探索科学假设生成论文
The AI Scientist-v2 是 Sakana AI 、不列颠哥伦比亚大学、Vector研究所等机构联合推出的完全自动生成科学发现的端到端人工智能系统,支持自主地提出科学假设、设计和执行实验、分析数据、生成可视化结果,撰写科学论文。
阅读全文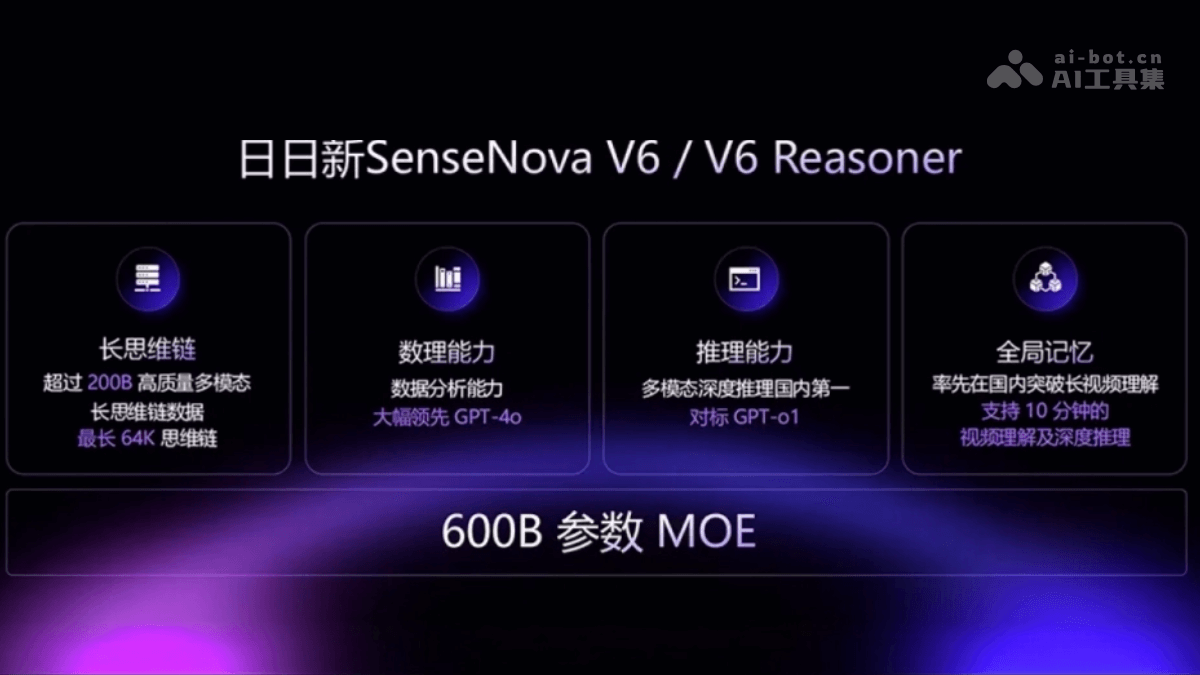
日日新SenseNova V6 – 商汤推出的多模态融合模型系列
日日新SenseNova V6是商汤推出的日日新第六代多模态融合大模型系列,基于6000亿参数的多模态MoE架构,实现文本、图像和视频的原生融合。日日新SenseNova V6在纯文本任务和多模态任务中表现卓越,多项指标超越GPT-4.5、Gemini 2.0 Pro等模型。
阅读全文
Kimi-VL – 月之暗面开源的轻量级多模态视觉语言模型
Kimi-VL 是月之暗面开源的轻量级多模态视觉语言模型,基于轻量级MoE模型Moonlight(16B总参数,2.8B激活参数)和原生分辨率的MoonViT视觉编码器(400M参数)。Kimi-VL支持单图、多图、视频和长文档等多模态输入,在图像感知、数学、多学科题目、OCR等任务中表现出色。
阅读全文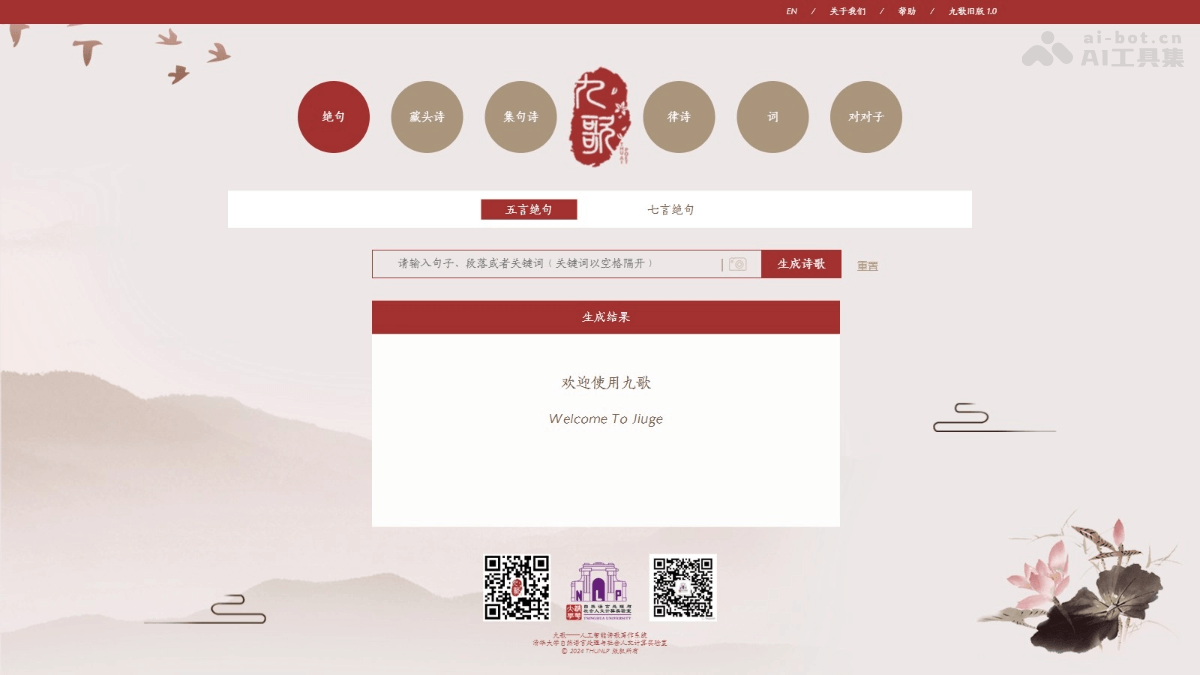
九歌 – 清华大学推出的AI诗歌写作工具
九歌是清华大学自然语言处理与社会人文计算实验室推出的AI诗歌写作系统。九歌基于深度学习技术,用超过80万首人类诗人创作的诗歌进行训练,辅助用户生成符合古诗格律的诗词作品。
阅读全文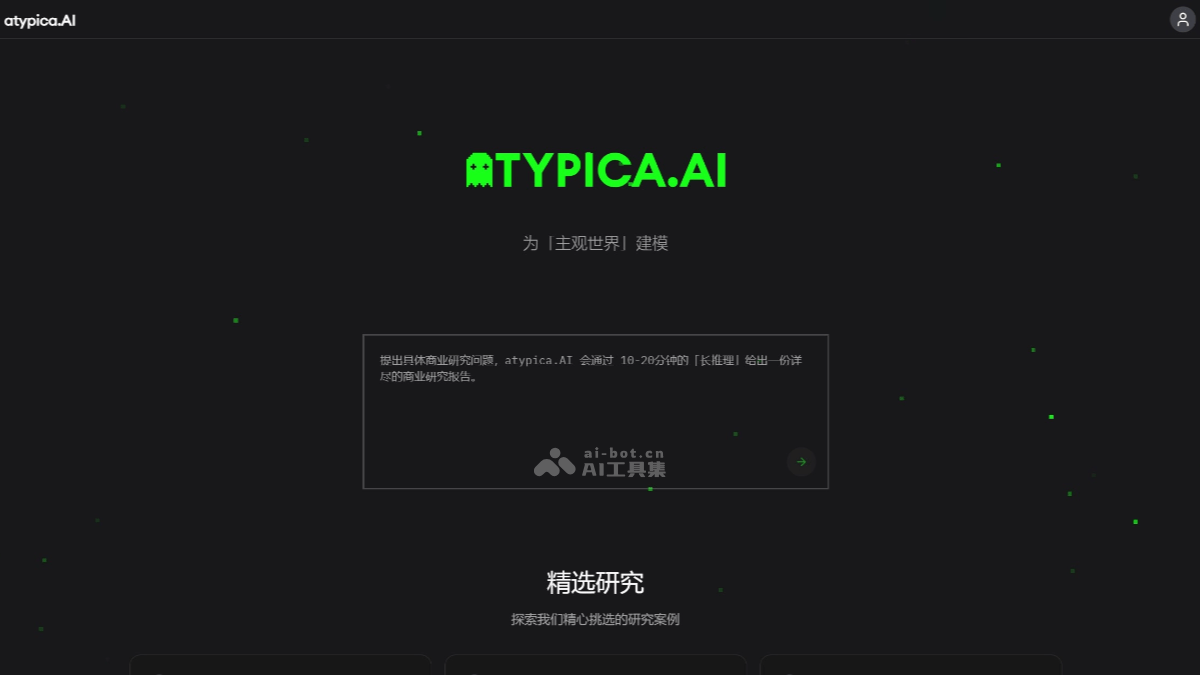
atypica.AI – AI商业研究智能体,自动明确研究意图、生成研究报告
atypica.AI 是专注于商业研究的智能体框架,通过语言模型快速生成用户洞察。通过虚拟访谈任务,模拟真实用户行为,快速收集和分析数据,生成详细的研究报告。能帮助市场营销人员、产品经理、品牌策划人员等快速了解用户需求和市场趋势。
阅读全文
Multi-SWE-bench – 字节豆包开源的多语言代码修复基准
Multi-SWE-bench 是字节跳动豆包大模型团队开源的首个多语言代码修复基准。在SWE-bench基础上,首次覆盖Python之外的7种主流编程语言,包括Java、TypeScript、JavaScript、Go、Rust、C和C++,是真正面向“全栈工程”的评测基准。
阅读全文
Gemini 2.5 Flash – 谷歌推出的最新 AI 推理模型
Gemini 2.5 Flash 是 Google 推出的高效、低延迟的 AI 模型,基于 Gemini 2.5 模型构建。Gemini 2.5 Flash在保持低延迟和成本效益的同时,引入思考能力。
阅读全文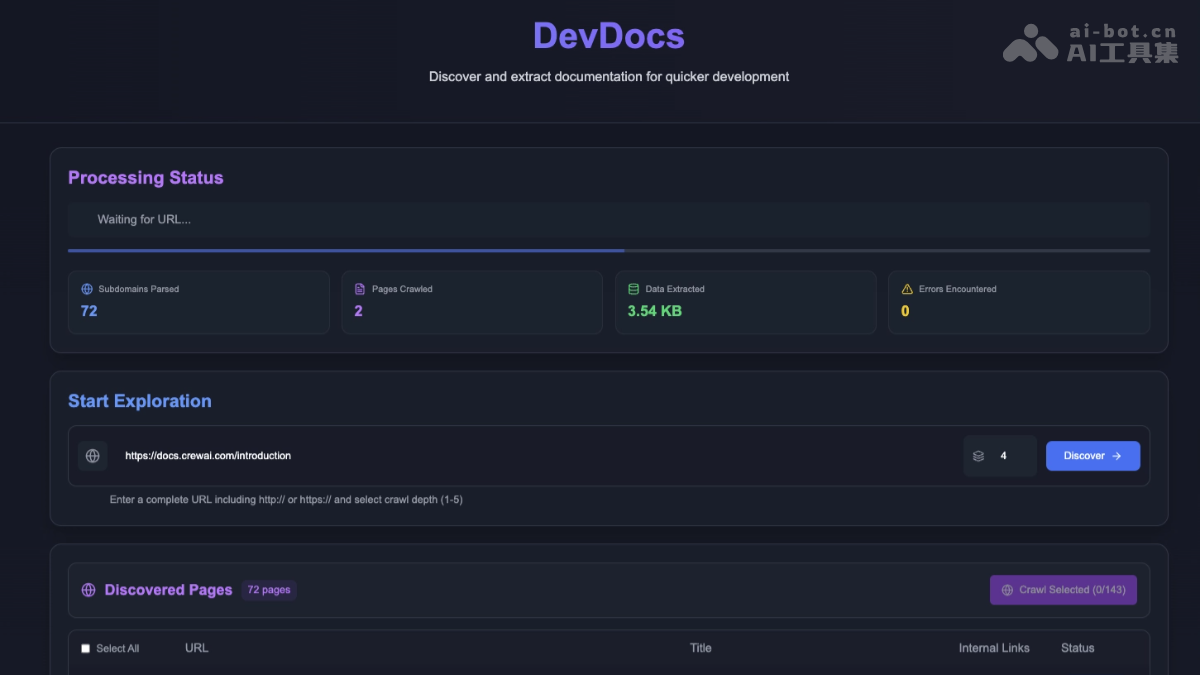
DevDocs – 开源的技术文档爬取和处理工具
DevDocs 是专为程序员和开发者设计的开源技术文档爬取和处理工具,基于智能爬虫技术,快速爬取、整理技术文档,将理解文档的时间从数周缩短至几小时。DevDocs支持1-5层深度的网站结构爬取,自动发现链接和子URL,多线程爬取速度快。
阅读全文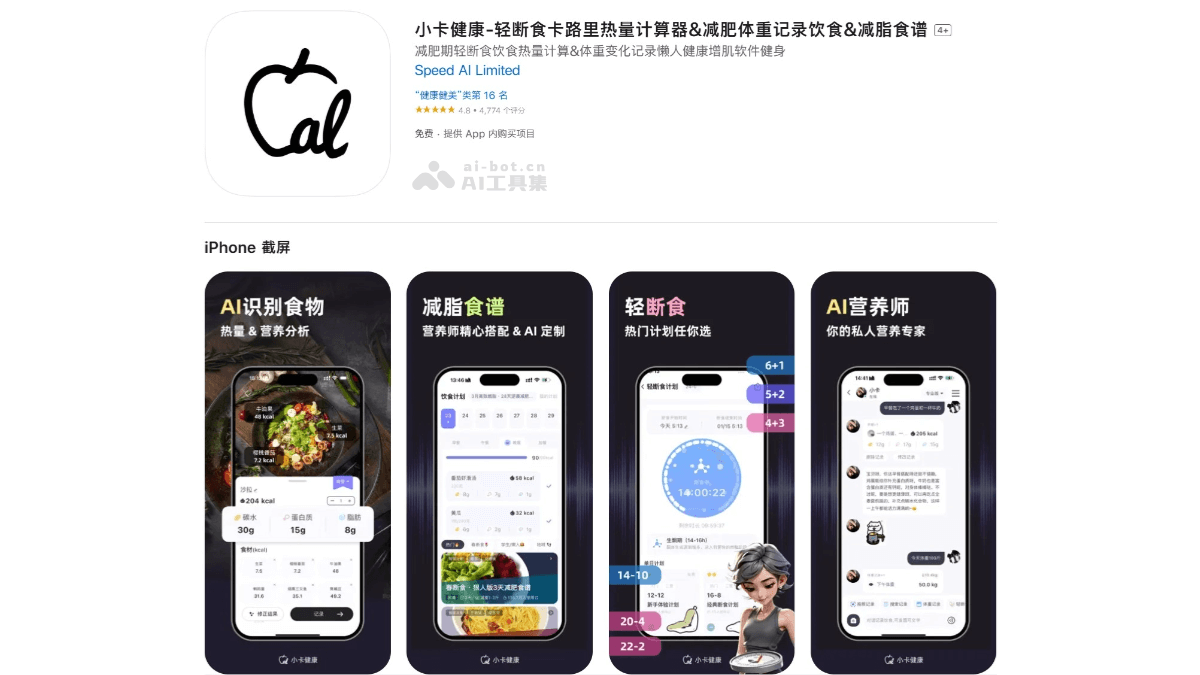
小卡健康 – AI健康管理应用,自动识别食物热量和营养分析
小卡健康是北京快欧科技推出的AI健康管理应用,专注于帮助用户轻松管理热量摄入与消耗。核心功能包括拍照识别热量,用户只需对食物拍照,APP能快速准确地识别食物的热量及其他营养成分,自动记录,无需手动输入。
阅读全文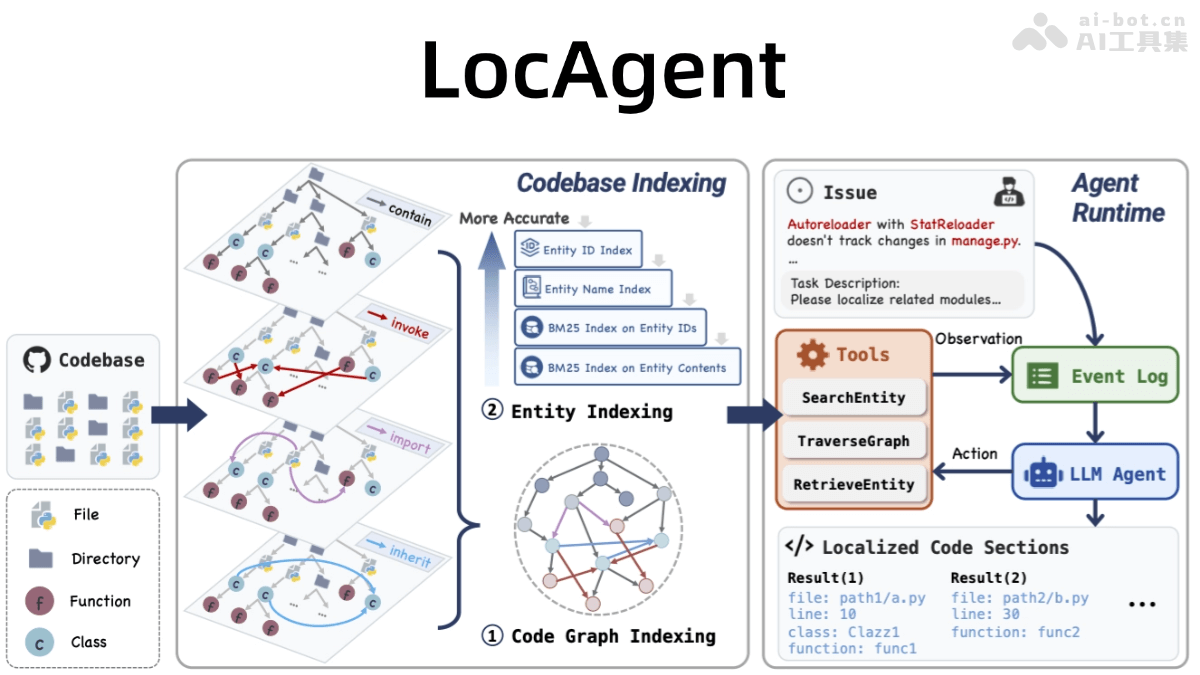
LocAgent – 斯坦福联合耶鲁大学等机构推出的代码问题定位智能体
LocAgent是斯坦福大学、耶鲁大学和南加州大学等机构联合推出的,专注于代码定位任务的框架,帮助开发者快速准确地找到代码库中需要修改的部分。LocAgent将代码库解析为有向异构图,捕捉代码的结构和依赖关系,让大型语言模型(LLM)基于强大的多跳推理能力,高效地搜索和定位相关代码实体。
阅读全文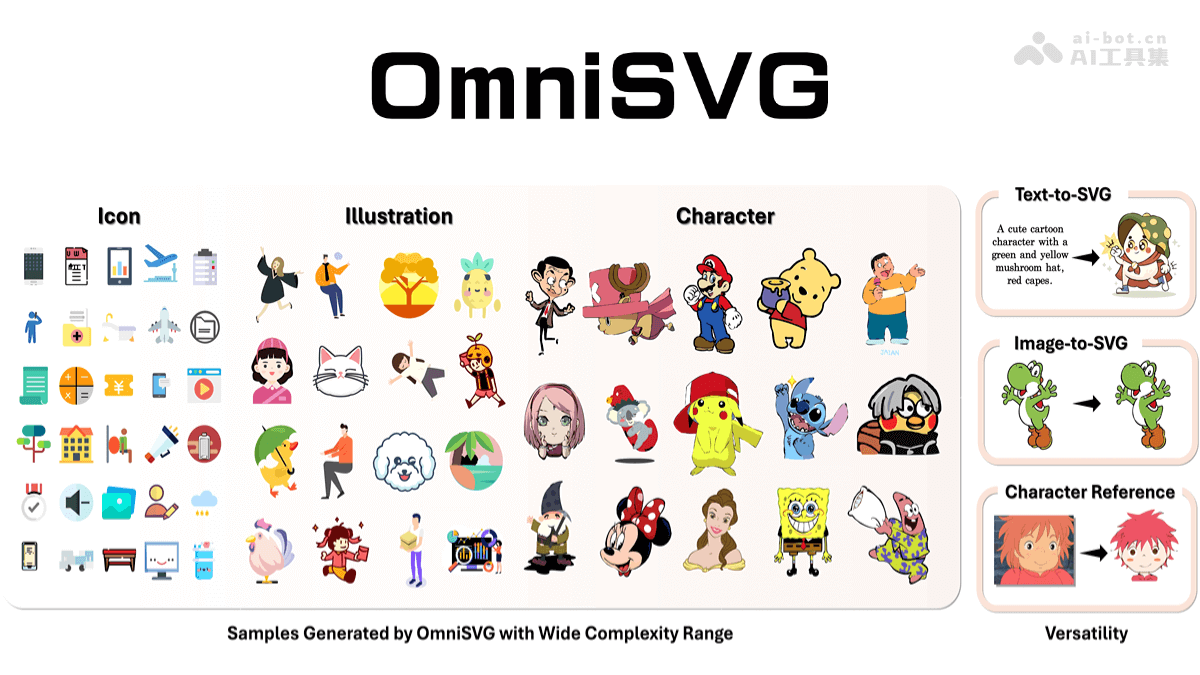
OmniSVG – 复旦大学联合 StepFun 推出端到端多模态矢量图形生成模型
OmniSVG 是复旦大学和 StepFun 联合开发的全球首个端到端多模态 SVG(可缩放矢量图形)生成模型。基于预训练视觉语言模型(VLM),通过创新的 SVG 标记化方法,将 SVG 命令和坐标参数化为离散令牌,实现了结构逻辑与几何细节的解耦。
阅读全文
A2A – 谷歌开源的首个标准智能体交互协议
A2A(Agent2Agent)是谷歌开源的首个标准智能体交互协议,让不同框架和供应商构建的AI智能体相互协作。A2A基于标准化的通信方式,打破系统孤岛,让智能体安全地交换信息、协调行动。
阅读全文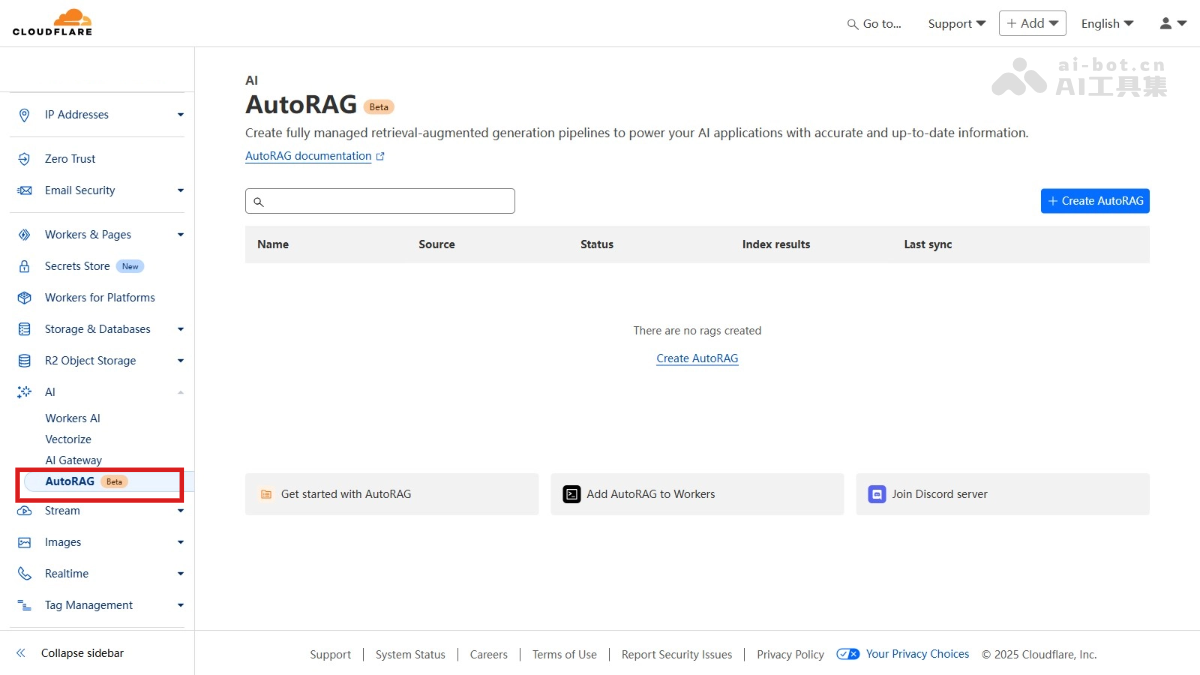
AutoRAG – Cloudflare 推出的全托管检索增强生成服务
AutoRAG 是Cloudflare 推出的全托管的检索增强生成(RAG)管道,帮助开发者轻松将上下文感知的 AI 集成到应用程序中,无需管理基础设施。
阅读全文
Firebase Studio – 谷歌推出的AI编程工具,一站式开发全栈应用
Firebase Studio 是谷歌推出AI编程工具,用户可以一站式完成全栈应用的构建、修改和部署。Firebase Studio整合 Project IDX 和 Firebase 的专用 AI Agent,提供从后端到前端、移动应用等全方位的开发支持。
阅读全文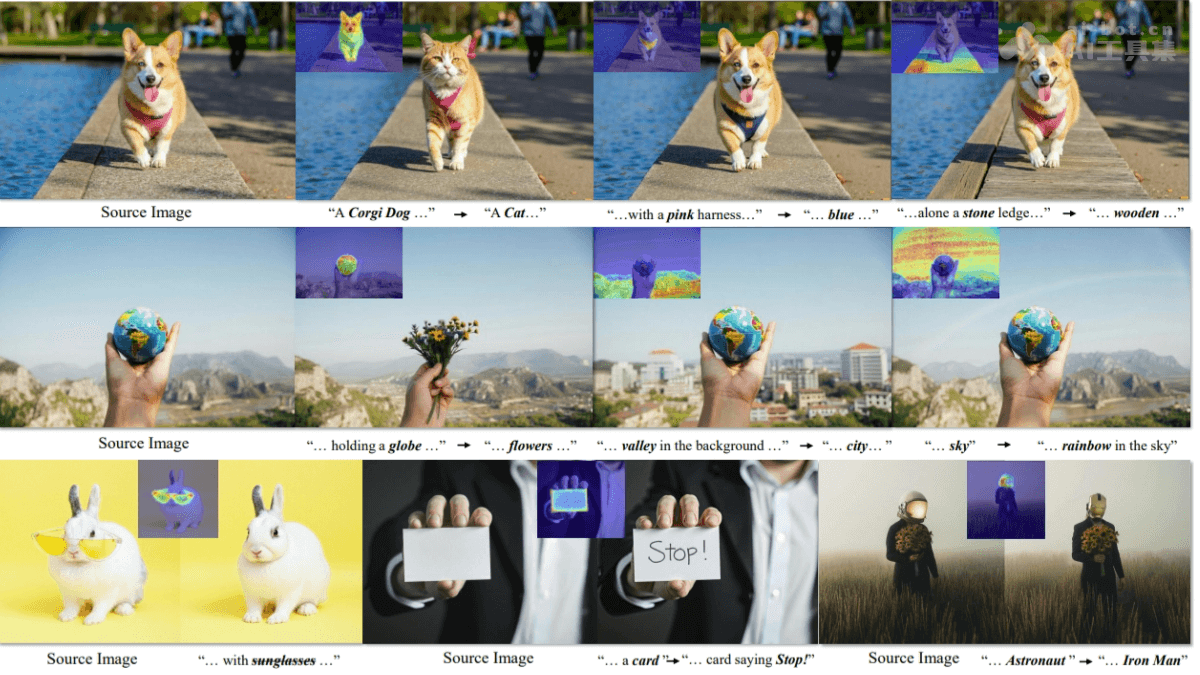
DCEdit – 北交大联合美图推出的双层控制图像编辑方法
DCEdit 是新型的双层控制图像编辑方法,是北京交通大学和美图2MT实验室联合推出的。DCEdit基于精确语义定位策略(PSL),用视觉和文本自注意力优化交叉注意力图,提供更精准的区域线索指导图像编辑。
阅读全文