Avat3r是什么
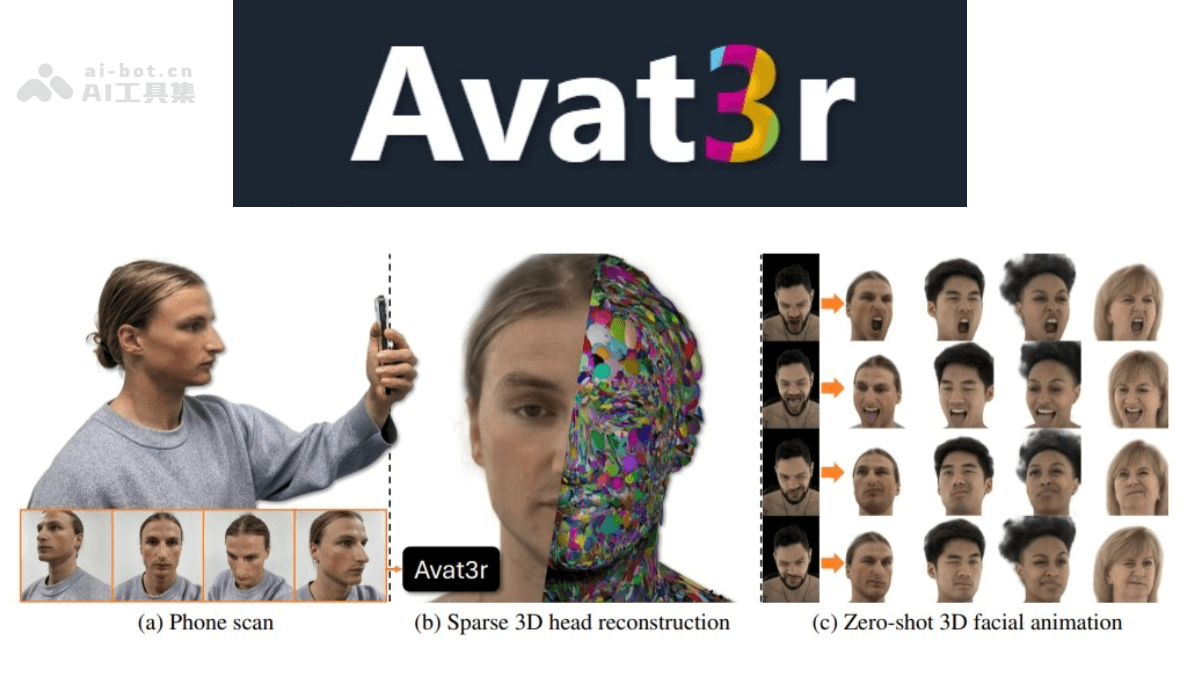
Avat3r 是慕尼黑工业大学和 Meta Reality Labs 推出的高保真三维头部头像的大型可动画高斯重建模型,仅需几张输入图像,能生成高质量且可动画化的 3D 头部头像,降低了计算需求。模型通过大型多角度视频数据集学习强大的三维人头先验,结合 DUSt3R 的位置图和 Sapiens 的特征图,优化重建效果。Avat3r 的关键创新在于通过简单的交叉注意力机制实现表情动画化,能从不一致的输入(如手机拍摄或单目视频帧)中重建三维头部头像。
Avat3r的主要功能
- 高效生成:仅需几张输入图像,可快速生成高质量的 3D 头部头像,大大减少了传统方法所需的计算资源。
- 动画化能力:通过简单的交叉注意力机制,Avat3r 能为生成的 3D 头部头像赋予动画效果,支持实时表情控制。
- 鲁棒性:模型在训练时使用了不同表情的图像,能处理不一致的输入,例如手机拍摄的模糊照片或单目视频帧。
- 多源输入支持:Avat3r 可以从多种来源生成 3D 头部头像,包括智能手机拍摄的照片、单张图像,古董半身像。
Avat3r的技术原理
- 高斯重建技术:Avat3r 使用3D高斯喷洒技术(3D Gaussian-splatting)作为基础表示。通过将3D空间中的点用高斯分布表示,每个高斯分布不仅描述点的空间位置,还编码颜色、法线等属性。能高效地重建和渲染复杂的3D头部模型。
- 多视图数据学习:Avat3r 从多角度视频数据集中学习三维人头的强大先验,在仅有少量输入图像的情况下,能生成高质量的3D头部头像。模型能更好地处理不一致的输入,例如手机拍摄的模糊照片或单目视频帧。
- 动画化技术:Avat3r 的关键创新之一是通过简单的交叉注意力机制实现表情动画化。模型在训练时输入不同表情的图像,提高对表情变化的鲁棒性。生成的3D头像能实时响应表情变化,实现自然的动画效果。
- 结合先验模型:Avat3r 结合了DUSt3R的位置图和Sapiens的广义特征图,进一步优化重建效果。先验模型为3D头部的几何结构和纹理提供了额外的约束,提升生成头像的真实感和细节表现。
- 高效性和泛化能力:Avat3r 在少输入和单输入场景中表现出色,能在几分钟内从几张输入图像生成高质量的3D头像。模型具备良好的泛化能力,能处理来自不同来源的输入,如智能手机照片或单张图片。
Avat3r的项目地址
Avat3r的应用场景
- 虚拟现实(VR)和增强现实(AR):Avat3r 可以生成高质量且可动画化的 3D 头部头像,适用于 VR 和 AR 场景。
- 影视制作和视觉特效:Avat3r 仅需几张输入图像可生成高质量的 3D 头像,可广泛应用于影视制作中的角色建模和动画生成。
- 游戏开发:在游戏开发中,Avat3r 可以快速生成角色的 3D 头像,支持实时动画化,为玩家提供更具沉浸感的游戏体验。
- 数字人和虚拟助手:Avat3r 可用于生成数字人的 3D 头像,头像可以结合语音合成和自然语言处理技术,为用户提供更加自然和个性化的交互体验。