AgentScope Tuner 是什么
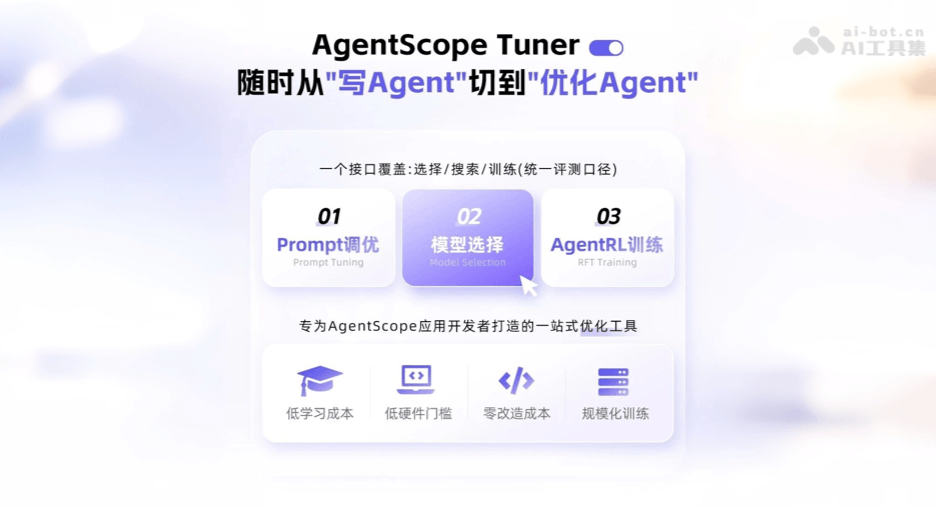
AgentScope Tuner 是阿里通义实验室为 Agentic AI 推出的一站式自动优化引擎,深度融入 AgentScope 生态,打通开发、调优、部署、回归全流程。工具提供 Prompt 调优、模型选择、AgentRL 强化微调三大能力,让已有 Agent 工作流几乎零改造成本可接入优化,实现从轻量验证到企业级分布式训练的全周期覆盖,让智能体越用越聪明。
AgentScope Tuner 的主要功能
-
Prompt 调优:通过自动化搜索算法(如 MIPROv2)系统化探索提示词空间,面向 Agent 轨迹优化 Prompt 模板,无需 GPU 即可快速迭代。
-
模型选择:在候选模型中自动评测筛选,结合准确率、响应速度、Token 消耗等多维指标,一键选出综合性价比最优基座模型。
-
强化微调(RFT):基于 Trinity-RFT 框架,从真实交互轨迹中学习,用端到端交互为单位进行深度参数优化,支持百卡集群分布式训练。
-
统一优化接口:三种优化策略共享同一套 API 设计范式,开发者无需学习不同框架即可自由切换优化方法。
-
开发-调优闭环:训练指标与线上效果一致,省去手动导出数据、格式适配、环境切换等繁琐步骤。
AgentScope Tuner 的技术原理
- Workflow-as-Function 抽象与异步执行图:将 Agent 工作流抽象为纯函数
async def workflow(task, model, system_prompt) -> WorkflowOutput,通过参数注入实现可优化变量的声明式绑定。Judge 函数返回标量奖励,形成标准的 (状态, 动作, 奖励) 强化学习三元组,整个执行图用异步协程方式调度。 - 提示词优化的组合搜索机制:基于 MIPROv2 在离散指令空间执行”元提示生成候选 → 少样本评估 → 局部筛选”的迭代搜索。用训练集构建示例池,通过组合优化在 Prompt 模板的语法-语义联合空间中寻找局部最优解。
- 模型选择的多目标帕累托计算:将准确率、时延、Token 成本转化为带权效用函数,在候选模型集合上执行批量推理,计算每个模型在任务分布上的期望奖励,通过帕累托前沿分析选出综合最优基座,实现多目标权衡下的自动决策。
- 轨迹级强化学习的组相对策略优化:基于 Trinity-RFT 框架,将完整 Agent 交互轨迹(多轮工具调用、观察、推理)作为单一训练样本。采用 GRPO(Group Relative Policy Optimization)通过组内相对优势估计解决长轨迹信用分配问题,避免传统 PPO 价值网络在离散动作空间中的估计偏差。
- 训练-推理同构运行时:Tuner 直接复用 AgentScope 运行时生成训练数据,确保训练分布与推理分布一致。通过在工作流中直接注入待优化参数消除传统 pipeline 的数据导出、格式转换环节,从根上避免环境漂移导致的”训练好、上线差”。
如何使用AgentScope Tuner
- 环境准备:安装 AgentScope 确保已有 Agent 工作流可正常运行。
- 准备数据集:将任务数据按 Hugging Face Datasets 格式整理为
train.jsonl和test.jsonl,每行包含任务输入与期望输出。 - 定义工作流函数:将 Agent 逻辑封装为
async def workflow(task, ...)函数,返回WorkflowOutput对象。 - 定义评判函数:实现
async def judge_function(task, response),返回包含reward的JudgeOutput提供优化信号。 - 启动优化:根据需求调用
tune_prompt()、select_model()或tune()接口,传入工作流、数据集与配置,可自动完成优化并回归部署。
AgentScope Tuner 的关键信息和使用要求
-
出品方:阿里通义实验室(AgentScope 官方生态)。
-
开源地址:GitHub
agentscope-ai/agentscope(tuner 模块位于src/agentscope/tuner)。 -
硬件要求:Prompt 调优与模型选择无需 GPU;强化微调需要 GPU,支持百卡集群及云端分布式训练。
-
数据格式:要求 Hugging Face Datasets 格式(JSONL),需自行准备训练集与评测集。
-
接入成本:已有 AgentScope 工作流几乎无需重构代码,通过注入
system_prompt或model参数可开启优化。 -
依赖框架:深度训练基于 Trinity-RFT,支持 vLLM 等推理加速。
-
推荐案例:GitHub
agentscope-ai/agentscope-samples/tree/main/tuner提供 Math Agent、狼人杀 Multi-Agent、Deep Finance Agent 等示例。
AgentScope Tuner的项目地址
- 项目官网:https://docs.agentscope.io/tune-agent/tune-your-first-agent
- GitHub仓库:https://github.com/agentscope-ai/agentscope/tree/main/src/agentscope/tuner
AgentScope Tuner 的核心优势
-
Agent 原生闭环:唯一围绕 Agent 多轮交互轨迹设计的优化引擎,训练与线上效果高度一致,避免“训练好、上线差”的脱节问题。
-
零改造成本接入:已有工作流仅需修改几行参数即可启动优化,无需切换环境或重写逻辑。
-
全周期阶梯优化:从早期 Prompt 轻量迭代到后期模型深度训练,提供贯穿研发生命周期的连续优化路径。
-
统一体验:三种优化策略共享同一套接口与评测口径,降低多框架学习成本。
-
企业级扩展性:支持云端百卡集群分布式强化学习,满足复杂业务场景的大规模训练需求。
AgentScope Tuner 的同类竞品对比
| 维度 | AgentScope Tuner | DSPy | LangChain LangSmith |
|---|---|---|---|
| 定位 | Agent 一站式自动优化引擎 | 提示词工程与优化框架 | LLM 应用观测与评估平台 |
| Prompt 优化 | 支持,面向 Agent 轨迹优化 | 核心功能,基于签名编译 | 有限,主要依赖人工迭代 |
| 模型选择 | 内置自动评测筛选 | 需自行实现 | 支持,侧重监控与 A/B 测试 |
| 模型微调 | 支持强化微调(RFT/RL) | 不支持原生 RL 训练 | 不支持 |
| Agent 原生 | 深度适配多轮工具调用与规划 | 通用型,需自行封装 Agent | 观测为主,不直接优化 |
| 接入成本 | 零改造,同一工作流无缝切换 | 需按框架重构代码 | 需接入 SDK 埋点 |
| 分布式训练 | 支持百卡集群/云端 | 不支持 | 不支持 |
| 出品方 | 阿里通义实验室 | Stanford NLP | LangChain |
AgentScope Tuner 的应用场景
-
数学推理 Agent:优化链式思考路径与工具调用描述,提升复杂数学问题的求解准确率。
-
多智能体博弈系统:如狼人杀场景,通过强化微调训练多个 Agent 的推理、欺骗与协作等高阶策略。
-
金融深度分析 Agent:针对长链路报告生成任务,优化端到端交互轨迹,实现文本分析与财务数据整合的自动化。
-
企业内部工具调用 Agent:当 Agent 需精准调用十几个内部 API 并按复杂业务规则生成报告时,通过 RFT 突破性能天花板。
-
模型降本增效:在准确率几乎无损的前提下,自动将昂贵的大模型替换为性价比更高的轻量模型。